【PR】この記事にはアフィリエイトリンクを含みます。実測に使った機材と、実測していない機材は、リンクごとに区別して記載しています。
このブログでは、これまでVRAM 6GBのGPUとRTX 4070(12GB)でローカルLLMを動かしてきました。この記事では、その実測値を1か所にまとめます。数字はすべて元記事の値。くわしい条件は、各行の出典リンクから元記事で確かめてください。
VRAMの量や実行環境(llama.cpp / Ollama)で絞り込んで見比べたいときは、VRAMで探すページを使ってください。この記事では、数字の読み方とVRAMごとの選び方を解説します。
結論
VRAM 6GBのGPU
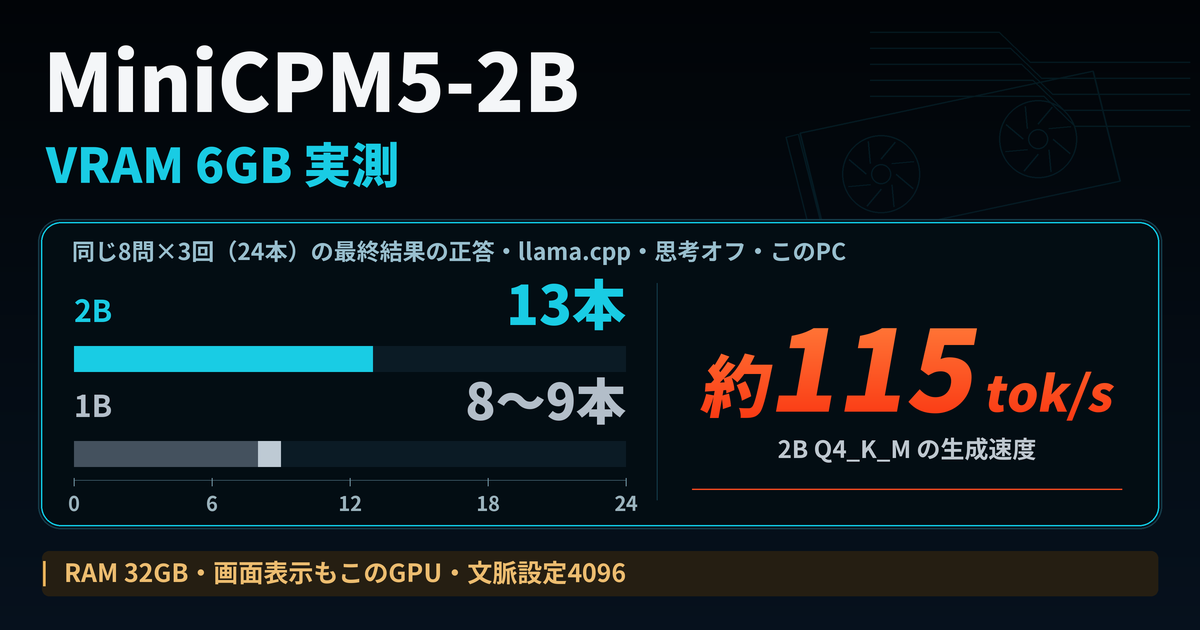
- MiniCPM5-2B(Q4_K_M)は、-ngl 99 -c 4096 で 114.59 tok/s(中央値)。llama-server の実タスクで測った値です。
- MiniCPM5-1B(Q4_K_M)は、同じ測り方で 227.53 tok/s。
- LLM-jp-4.1 8B(Q4_K_M、5.12GiB)は、一部の層だけGPUに載せる形で動きました。-ngl 22 -c 8192 で 15.39 / 15.37 / 15.79 tok/s。
- LLM-jp-4.1 32B-A3B(Q4_K_M、20.04GiB)は、--n-cpu-moe 30 -c 16384 で 17.92 / 17.82 / 17.89 tok/s。
- Qwythos-9B(旧版、Q4_K_M)は、-ngl 8 -c 4096 で 5.96 / 7.06 / 5.59 tok/s。
RTX 4070(12GB)
- Ternary Bonsai 2 27B(PTQ1_0、5.95 GB)は、-ngl 99 -c 8192 で平均56.0 tok/s、VRAMピークは 7,608 MiB。
- Muse Glimmer 30B(UD-IQ2_XXS、10.01GiB)は、-ngl 53 -c 8192 で平均37.9 tok/s。
- Gemma 4 12B(Q4_K_M)は、Ollama で 43 tok/s。
- 今回測った各モデル・配布物では、Q4_K_M の27B〜30Bは、RTX 4070(12GB)に載りきりませんでした。Qwen3.8-27B は -ngl 42 で 3.55 / 3.56 / 3.54 tok/s、Muse Glimmer 30B は -ngl 38 で平均3.75 tok/s。
この記事の見方
- tok/s:1秒あたりに生成できるトークン(文字のかたまり)の数。大きいほど速く文章が出ます。この記事の「生成tok/s」は、文章を出す速さの値です。
- 量子化:モデルの重みを少ないビット数に縮めて、ファイルとVRAMを小さくする方法。Q4_K_M、Q8_0、IQ2_XXS などがその種類です。
- -ngl:llama.cpp で、モデルの層をいくつGPUに載せるかの設定。99 や 999 は「全部載せる」という意味で使っています。
- --n-cpu-moe:MoE(専門家を切り替えるタイプ)のモデルで、エキスパート部分をCPU側に置く層の数。
- 文脈設定(-c、num_ctx、context):一度に扱えるトークン数の上限。大きくするとVRAMを多く使います。
速度の測り方は、元記事ごとに違います。llama-server で実際のタスク(旅行プラン・要約・コード相談など)を回した値、llama-bench の tg128(128トークン生成)の値、Ollama の eval rate など。表の「主な設定」の欄に、実行環境と測り方を一緒に書いています。
VRAMの値も、記事ごとに測り方が違います。GPU全体のピーク、待機時やモデル未ロード時からの追加分、nvidia-smi の観測値など。表の各セルに意味を書いています。
表の「出典」は、その行の値を載せた元記事へのリンク。アフィリエイトリンクではありません。
VRAM 6GBで動いたモデル
※VRAMの値は記事ごとに測り方が違います(GPU全体の最大値、待機時からの増加分、nvidia-smi の観測値など)。行どうしを並べて比べず、各セルの括弧内の意味と一緒に読んでください。
| モデル | 量子化 | 主な設定 | 生成tok/s | VRAM | 出典 |
|---|---|---|---|---|---|
| MiniCPM5-2B | Q4_K_M(1.45GiB) | -ngl 99 -c 4096 -fa on --parallel 1 --jinja、思考オフ llama.cpp b11574/llama-server 実タスク(3シード) | 114.59(中央値。範囲110.30〜115.65) | 3,459 MiB(待機時からの増加 +1,655 MiB)/GPU全体の最大値 | 記事 |
| MiniCPM5-2B | Q4_K_M(1.45GiB) | num_ctx 4096、思考オフ Ollama 0.40.6/Ollama 実タスク | 116.67 | 記事に記載なし | 記事 |
| MiniCPM5-2B | Q8_0(2.50GiB) | -ngl 99 -c 4096 -fa on、思考オフ llama.cpp b11574/llama-server 実タスク | 81.20 | 4,395 MiB(+2,591 MiB)/GPU全体の最大値 | 記事 |
| MiniCPM5-1B | Q4_K_M(0.64GiB) | -ngl 99 -c 4096 -fa on、思考オフ llama.cpp b11574/llama-server 実タスク | 227.53 | 2,571 MiB(+767 MiB)/GPU全体の最大値 | 記事 |
| MiniCPM5-1B | Q8_0(1.07GiB) | -ngl 99 -c 4096 -fa on、思考オフ llama.cpp b11574/llama-server 実タスク | 165.69 | 2,917 MiB(+1,113 MiB)/GPU全体の最大値 | 記事 |
| MiniCPM5-2B | Q4_K_M(1.45GiB) | -ngl 99 -c 32768 -fa on llama.cpp b11574/llama-server 長文脈 | 114.94 | 4,588 MiB/GPU全体の最大値 | 記事 |
| MiniCPM5-2B | Q4_K_M(1.45GiB) | -ngl 99 -c 131072 -fa on llama.cpp b11574/llama-server 長文脈 | 100.81 | 5,573 MiB(共有GPUメモリ +2,702 MiB)/GPU全体の最大値 | 記事 |
| MiniCPM5-2B | Q8_0(2.50GiB) | -ngl 99 -c 32768 -fa on llama.cpp b11574/llama-server 長文脈 | 80.96 | 5,383 MiB(暖機時)/GPU全体の最大値 | 記事 |
| MiniCPM5-2B | Q8_0(2.50GiB) | -ngl 99 -c 131072 -fa on llama.cpp b11574/llama-server 長文脈 | 73.95 | 5,714 MiB(共有GPUメモリ +3,672 MiB)/GPU全体の最大値 | 記事 |
| LLM-jp-4.1 8B | Q4_K_M(公式、5.12GiB) | -ngl 21 -c 4096 -fa on --jinja、思考 medium llama.cpp b11574/llama-server 実タスク(各1回) | 14.49 / 14.87 / 15.00(旅行/要約/コード) | 5,406 MiB/候補選定区間のGPU全体ピーク | 記事 |
| LLM-jp-4.1 8B | Q4_K_M(公式、5.12GiB) | -ngl 22 -c 8192 -fa on --jinja、思考 medium llama.cpp b11574/llama-server 実タスク(各1回) | 15.39 / 15.37 / 15.79 | 5,621 MiB/候補選定区間のGPU全体ピーク | 記事 |
| LLM-jp-4.1 8B | Q4_K_M(公式、5.12GiB) | -ngl 17 -c 16384 -fa on --jinja、思考 medium llama.cpp b11574/llama-server 実タスク(各1回) | 12.51 / 12.67 / 12.68 | 5,432 MiB/候補選定区間のGPU全体ピーク | 記事 |
| LLM-jp-4.1 8B | Q4_K_M(公式、5.12GiB) | --device none(GPU不使用)-c 16384 llama.cpp b11574/llama-server コード相談1本 | 6.25 | 記事に記載なし | 記事 |
| LLM-jp-4.1 32B-A3B | Q4_K_M(公式、20.04GiB) | -ngl 99 --n-cpu-moe 28 -c 4096 -fa on --jinja llama.cpp b11574/llama-server 実タスク(各1回) | 17.85 / 18.71 / 18.67 | 記事に記載なし | 記事 |
| LLM-jp-4.1 32B-A3B | Q4_K_M(公式、20.04GiB) | -ngl 99 --n-cpu-moe 30 -c 8192 -fa on --jinja llama.cpp b11574/llama-server 実タスク(各1回) | 17.83 / 17.49 / 17.97 | 記事に記載なし | 記事 |
| LLM-jp-4.1 32B-A3B | Q4_K_M(公式、20.04GiB) | -ngl 99 --n-cpu-moe 30 -c 16384 -fa on --jinja llama.cpp b11574/llama-server 実タスク(各1回) | 17.92 / 17.82 / 17.89 | 記事に記載なし | 記事 |
| Qwythos-9B(旧版) | Q4_K_M(約5.63GB) | -ngl 8 -c 4096 --reasoning off llama.cpp(版の記載なし)/llama-server ブラウザUIの表示 | 5.96(旅行)/ 7.06(要約)/ 5.59(コード) | 約3,920〜4,137 MiB(3タスクの範囲)/nvidia-smi の観測値 | 記事 |
| Qwythos-9B(旧版) | Q5_K_M(約6.47GB) | -ngl 8 -c 4096 --reasoning off llama.cpp(版の記載なし)/llama-server ブラウザUIの表示 | 5.93(旅行) | 約4,432〜4,583 MiB(起動後)/nvidia-smi の観測値 | 記事 |
| Qwythos-9B(旧版) | Q6_K(約7.36GB) | -ngl 8 -c 4096 --reasoning off llama.cpp(版の記載なし)/llama-server ブラウザUIの表示 | 2.98(コード) | 約4,394〜4,499 MiB/nvidia-smi の観測値 | 記事 |
| Qwythos-9B(旧版) | Q4_K_M | -c 8192 llama.cpp CLI(版の記載なし)/長文の合言葉取得(成功) | 5.6 | 約4,064 MiB/nvidia-smi の観測値 | 記事 |
| Qwythos-9B(旧版) | Q4_K_M | -c 16384 llama.cpp CLI(版の記載なし)/長文の合言葉取得(成功) | 4.0 | 約4,816 MiB/nvidia-smi の観測値 | 記事 |
| Qwythos-9B(旧版) | Q4_K_M | -c 32768 llama.cpp CLI(版の記載なし)/長文の合言葉取得(成功) | 3.0 | 約4,464 MiB/nvidia-smi の観測値 | 記事 |
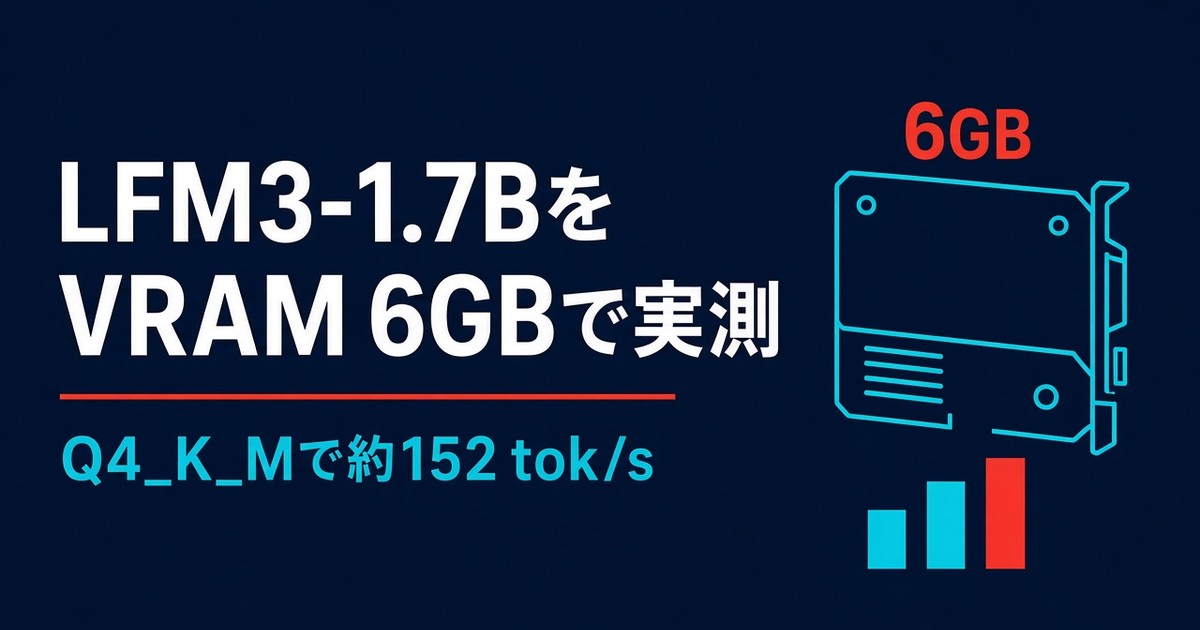
| LFM3-1.7B | Q4_K_M(公式、1,099,627,808 bytes) | -ngl 99 -c 4096 -fa on --parallel 1 --jinja、思考オフ llama.cpp b12005/llama-server 実タスク(3シード) | 152.13(中央値) | 3,045 MiB(待機時からの増加 +1,251 MiB)/GPU全体の最大値(外部 nvidia-smi 1秒間隔) | 記事 |
| LFM3-1.7B | QAD-Q4_0(公式、1,049,615,680 bytes) | -ngl 99 -c 4096 -fa on --parallel 1 --jinja、思考オフ llama.cpp b12005/llama-server 実タスク(3シード) | 152.01(中央値) | 2,991 MiB(+1,197 MiB)/GPU全体の最大値(外部 nvidia-smi 1秒間隔) | 記事 |
| LFM3-1.7B | Q8_0(公式、1,846,238,496 bytes) | -ngl 99 -c 4096 -fa on --parallel 1 --jinja、思考オフ llama.cpp b12005/llama-server 実タスク(3シード) | 107.08(中央値) | 3,806 MiB(+2,012 MiB)/GPU全体の最大値(外部 nvidia-smi 1秒間隔) | 記事 |
| Nemotron 3.5 Bolt E4B | Q4_K_M(公式 NVIDIA、5.76GiB) | -ngl 99 -c 4096 -fa on --parallel 1、思考オフ llama.cpp b12005/llama-server 実タスク(8問×3シード) | 58.048(中央値。範囲57.137〜58.343) | 5,702 MiB(待機時からの増加 +3,456 MiB)/GPU全体の最大値(画面表示分を含む) | 記事 |
| Nemotron 3.5 Bolt E4B | UD-Q4_K_XL(Unsloth、4.71GiB) | -ngl 99 -c 4096 -fa on --parallel 1、思考オフ llama.cpp b12005/llama-server 実タスク(8問×3シード) | 55.191(範囲53.391〜55.44) | 5,259 MiB(+3,764 MiB)/GPU全体の最大値(画面表示分を含む) | 記事 |
| Nemotron 3.5 Bolt E4B | UD-Q3_K_XL(Unsloth、3.93GiB) | -ngl 99 -c 4096 -fa on --parallel 1、思考オフ llama.cpp b12005/llama-server 実タスク(8問×3シード) | 55.738(範囲55.279〜56.049) | 4,435 MiB(+2,949 MiB)/GPU全体の最大値(画面表示分を含む) | 記事 |
| Nemotron 3.5 Bolt E4B | Q4_K_M(公式 NVIDIA、5.76GiB) | -ngl 99 -c 4096 -fa on --parallel 1、思考ON llama.cpp b12005/llama-server 実タスク(8問×3シード) | 57.453(思考込み) | 5,721 MiB(+3,475 MiB)/GPU全体の最大値(画面表示分を含む) | 記事 |
| Recursive Flint(40B-A2.5B MoE) | UD-Q2_K_XL(unsloth、13,562,207,680 bytes) | -ngl 99 --n-cpu-moe 41 -c 4096 -fa on --parallel 1、思考オフ llama.cpp b12005/llama-server 実タスク(8問×3シード)、RAM 32GB(DDR4-3200) | 25.272(中央値。範囲22.996〜26.367) | 5,639 MiB(+3,545 MiB)/GPU全体の最大値(画面表示分を含む) | 記事 |
| Recursive Flint(40B-A2.5B MoE) | UD-IQ2_XXS(unsloth、11,855,541,696 bytes) | -ngl 99 --n-cpu-moe 49 llama.cpp b12005/llama-bench tg128 のみ(実タスクは未測定) | 21.312(tg128、3回平均) | 3,560 MiB/GPU全体の最大値(bench 区間) | 記事 |
MiniCPM5-2B/MiniCPM5-1B
どちらも全層をGPUに載せて(-ngl 99)動きました。MiniCPM5-2B の Q4_K_M は、llama-server の実タスク3シードで 114.59 tok/s(中央値)。同じモデルを llama-bench の tg128 で測ると 117.14、Ollama 0.40.6 では 116.67 tok/s でした。
MiniCPM5-1B は、Q4_K_M で 227.53 tok/s、Q8_0 で 165.69 tok/s(llama-server 実タスク)。Ollama では Q4_K_M が 232.48、Q8_0 が 169.14 です。
長文脈では、MiniCPM5-2B の Q4_K_M が -c 32768 で 114.94 tok/s、-c 131072 で 100.81 tok/s。-c 131072 では共有GPUメモリへのはみ出しがありました。プロンプト処理(入力を読み込む速さ)は、それぞれ 478.39 と 300.67 tok/s です。
LLM-jp-4.1 8B
ファイルは 5.12GiB。全層は載せず、-ngl 17〜22 の範囲で層の数を調整しました。-ngl 21 -c 4096 で 14.49 / 14.87 / 15.00 tok/s、-ngl 22 -c 8192 で 15.39 / 15.37 / 15.79 tok/s、-ngl 17 -c 16384 で 12.51 / 12.67 / 12.68 tok/s です。10/16 の測定では、-c 16384・-ngl 19 で 13.79 / 14.18 / 13.85 tok/s。
GPUを使わない設定(--device none)では、コード相談1本で 6.25 tok/s。CPU 4コア8スレッドだけの値です。
LLM-jp-4.1 32B-A3B
ファイルは 20.04GiB で、VRAM 6GBには収まりません。--n-cpu-moe でエキスパート部分をCPU側に置き、-ngl 99 で残りをGPUに載せて動かしました。-c 16384・--n-cpu-moe 30 で 17.92 / 17.82 / 17.89 tok/s。10/16 の測定では、--n-cpu-moe 28 で 18.02 / 18.24 / 18.15 tok/s でした。層ごとCPUに回す方法(-ngl 6)では 14.15 tok/s。
RAMは 32GB(DDR4-3200)。--n-cpu-moe 28 -c 4096 の測定では、RAMの空きが最小で約1.1 GiB まで減りました。
Qwythos-9B(旧版)
-ngl 8 -c 4096 で、Q4_K_M が 5.96 / 7.06 / 5.59 tok/s、Q5_K_M が 5.93 tok/s(旅行)、Q6_K が 2.98 tok/s(コード)。速度は llama-server のブラウザUIに出る表示です。Q5_K_M のゲーム生成(-c 8192)は 6.09 t/s でした。
長い文脈の試験(ID 317)では、llama.cpp CLI で -c 8192 が 5.6、-c 16384 が 4.0、-c 32768 が 3.0 tok/s。どれも長文の合言葉を取り出せています。この記事には -ngl とファイルサイズの記載がありません。
VRAM 12GBで動いたモデル
※VRAMの値は記事ごとに測り方が違います(GPU全体のピーク、モデル未ロード時からの追加分、生成中のピーク、llama-bench 中のピークなど)。行どうしを並べて比べず、各セルの括弧内の意味と一緒に読んでください。
| モデル | 量子化 | 主な設定 | 生成tok/s | VRAM | 出典 |
|---|---|---|---|---|---|
| MiniCPM5-1B | Q4_K_M(656.19 MiB) | context 4K、Thinking無効 Ollama 0.32.0/固定プロンプト5回 | 293.52(中央値) | 追加 847 MiB(GPU総使用量 約2,871 MiB)/モデル未ロード時との差 | 記事 |
| MiniCPM5-1B | Q8_0(1,100.09 MiB) | context 4K、Thinking無効 Ollama 0.32.0/固定プロンプト5回 | 246.30(中央値) | 追加 1,191 MiB(約3,219 MiB)/モデル未ロード時との差 | 記事 |
| Qwen3.5-0.8B | Q8_0(988.04 MiB) | context 4K Ollama 0.32.0/固定プロンプト5回 | 203.07(中央値) | 追加 1,449 MiB(約3,477 MiB)/モデル未ロード時との差 | 記事 |
| LFM2.5-1.2B-Instruct | Q4_K_M(697.04 MiB) | context 4K Ollama 0.32.0/固定プロンプト5回 | 340.44(中央値) | 追加 977 MiB(約3,002 MiB)/モデル未ロード時との差 | 記事 |
| Phi-4-mini(phi4-mini) | Q4_K_M | 既定 Ollama 0.30.8/ollama run --verbose の eval rate | 111 | 6,025 MiB/全タスク中のVRAMピーク | 記事 |
| Gemma 4 E4B(gemma4:e4b) | Q4_K_M | 既定 Ollama 0.30.8/ollama run --verbose の eval rate | 84 | 6,717 MiB/全タスク中のVRAMピーク | 記事 |
| Gemma 4 12B(gemma4:12b) | Q4_K_M | 既定 Ollama 0.30.8/ollama run --verbose の eval rate | 43 | 10,673 MiB/全タスク中のVRAMピーク | 記事 |
| Qwen3 14B(qwen3:14b) | Q4_K_M | 既定 Ollama 0.30.8/ollama run --verbose の eval rate | 38 | 11,456 MiB/全タスク中のVRAMピーク | 記事 |
| Gemma 4 26B MoE(gemma4:26b) | Q4_K_M(18 GB、ollama ps) | CONTEXT 4096、43%/57% CPU/GPU Ollama 0.30.8/ollama run --verbose の eval rate | 24 | 11,952 MiB/全タスク中のVRAMピーク | 記事 |
| Qwythos-9B(旧版) | Q5_K_M(約6.47GB) | ngl 999、reasoning off、ctx 8192/16384 llama.cpp version 9789/ゲーム生成(各1回) | 53.01(初回)/ 50.07(改善) | 7,682 MiB/生成中ピーク(nvidia-smi 1秒間隔) | 記事 |
| Qwythos-9B(旧版) | Q6_K(約7.36GB) | ngl 999、reasoning off llama.cpp version 9789/ゲーム生成(各1回) | 42.10 / 41.04 | 8,611 MiB/生成中ピーク | 記事 |
| Qwythos-9B(旧版) | Q8_0(約9.53GB) | ngl 999、reasoning off llama.cpp version 9789/ゲーム生成(各1回) | 34.81 / 34.00 | 10,374 MiB/生成中ピーク | 記事 |
| Qwythos-9B v2 | Q8_0(9,527,501,568 bytes) | ngl 999、reasoning off、ctx 16384 llama.cpp version 9789/ゲーム生成(各1回) | 37.88 / 35.68 | 10,719 MiB/生成・改善会話を通したピーク | 記事 |
| LLM-jp-4.1 8B | Q4_K_M(公式、5.12GiB) | 全33層GPU -c 16384 -fa on --jinja llama.cpp b11574/llama-server 実タスク(各1回) | 40.89 / 41.21 / 41.06 | 8,730 MiB(直前との差 7,157 MiB)/GPU全体のピーク | 記事 |
| LLM-jp-4.1 32B-A3B | Q4_K_M(公式、20.04GiB) | --n-cpu-moe 32 -c 16384 llama.cpp b11574/llama-server 実タスク | 約9.0〜9.2 | 記事に記載なし | 記事 |
| Muse Glimmer 30B | UD-IQ2_XXS(unsloth、2bit、10.01GiB) | -ngl 53 -c 8192 --parallel 1 --jinja -fa on、思考 low llama.cpp b11574/llama-server 実タスク(各1回) | 38.06 / 37.71 / 38.04(平均37.9) | 10,779 MiB/GPU全体のピーク | 記事 |
| Muse Glimmer 30B | Q4_K_M(Meta公式 17GB版、15.61GiB) | -ngl 38 -c 8192 --jinja -fa on、思考 low llama.cpp b11574/llama-server 実タスク(各1回) | 3.70 / 3.79 / 3.76(平均3.75) | 11,941 MiB/GPU全体のピーク | 記事 |
| Muse Glimmer 30B | Q4_K_M(公式)+DFlash(15.61GiB+1.52GiB) | -ngl 32 -md dflash… --spec-type draft-dflash --spec-draft-n-max 3 llama.cpp b11574/llama-server 1回 | 7.72(コード相談1件) | 11,996 MiB/GPU全体のピーク | 記事 |
| Ternary Bonsai 2 27B | PTQ1_0(5.95 GB) | -ngl 99 -c 8192、思考オフ PrismML版 llama.cpp prism-b10754/llama-server 実タスク(各1回) | 56.21 / 55.62 / 56.21(平均56.0) | 7,608 MiB/VRAMピーク | 記事 |
| Ternary Bonsai 2 27B | PQ2_0(7.21 GB) | -ngl 99 -c 8192、思考オフ PrismML版 llama.cpp prism-b10754/llama-server 実タスク(各1回) | 48.91 / 49.09 / 49.07(平均49.0) | 8,760 MiB/VRAMピーク | 記事 |
| Ternary Bonsai 2 27B | PTQ1_0(5.95 GB) | -ngl 99 -c 65536(64K) PrismML版 llama.cpp prism-b10754/llama-server 短い要約1回 | 56.26 | 11,105 MiB/VRAMピーク | 記事 |
| Ternary Bonsai 2 27B | PTQ1_0(5.95 GB) | -ngl 99 -fa on -ctk q8_0 -ctv q8_0 -c 128K PrismML版 llama.cpp prism-b10754/llama-server 短い要約1回 | 55.71 | 11,393 MiB/VRAMピーク | 記事 |
| Ternary Bonsai 2 27B | PQ2_0(7.21 GB) | -ngl 99 -c 48K PrismML版 llama.cpp prism-b10754/llama-server 短い要約1回 | 48.89 | 11,214 MiB/VRAMピーク | 記事 |
| Qwen3.8-27B | Q4_K_M(bartowski、16.54 GiB) | -ngl 42(llama-bench -p 512 -n 128) llama.cpp b10456/llama-bench 5回 | 3.00(tg128) | 11,861 MiB(96.6%)/VRAMピーク | 記事 |
| Qwen3.8-27B | Q4_K_M(bartowski、16.54 GiB) | -ngl 32 -c 2048 --parallel 1 llama.cpp b10456/llama-server 実タスク(各1回) | 2.06 / 2.06 / 2.08 | 9,362 MiB(76.2%)/VRAMピーク | 記事 |
| Qwen3.8-27B | Q4_K_M(17.77 GB) | -ngl 42 -c 2048、思考オフ llama.cpp b10456/llama-server 実タスク(各1回) | 3.55 / 3.56 / 3.54 | 11,856 MiB/VRAMピーク | 記事 |
| Qwythos-27B v1 | Q4_K_M(17,314,170,272 bytes) | 自動フィット、-c 16384、KV q8_0、flash attention 有効 llama.cpp build 10241/llama-server 実運用 | 1.75 | 11,457 MiB(93.3%)/VRAM最大使用 | 記事 |
| Qwythos-27B v1 | Q4_K_M(16.11 GiB) | -ngl 42(llama-bench) llama.cpp b10456/llama-bench | 3.03(tg128) | 記事に記載なし | 記事 |
1B前後の小さなモデル(Ollama 0.32.0)
固定プロンプトを5回流した中央値です。MiniCPM5-1B は Q4_K_M で 293.52 tok/s、Q8_0 で 246.30 tok/s。Qwen3.5-0.8B(Q8_0)は 203.07 tok/s、LFM2.5-1.2B-Instruct(Q4_K_M)は 340.44 tok/s でした。VRAMは、モデル未ロード時との差で書いています。
Phi-4-mini/Gemma 4/Qwen3 14B(Ollama 0.30.8)
速度は ollama run --verbose の eval rate。Phi-4-mini が 111、Gemma 4 E4B が 84、Gemma 4 12B が 43、Qwen3 14B が 38 tok/s でした。Gemma 4 26B MoE は ollama ps で 18 GB と表示され、43%/57% CPU/GPU でCPUへ一部オフロードされました。このときは 24 tok/s。
Qwythos-9B
全層をGPUに載せて(ngl 999)、ゲーム生成を各1回ずつ測りました。旧版は Q5_K_M で 53.01 / 50.07、Q6_K で 42.10 / 41.04、Q8_0 で 34.81 / 34.00 tok/s。v2 の Q8_0 は 37.88 / 35.68 tok/s です。v2 は低温度の短文試験で 42.93 t/s でした。
LLM-jp-4.1 8B/32B-A3B
8B は全33層をGPUに載せ、-c 16384 で 40.89 / 41.21 / 41.06 tok/s でした。-c 8192 のときのVRAMは 7,326 MiB(差 6,124 MiB)です。
32B-A3B は --n-cpu-moe 32 -c 16384 で 約9.0〜9.2 tok/s でした。元記事には「配置を詰め切れていない」と明記しています。llama-bench で --n-cpu-moe 18 にした値は 14.99。
PTQ1_0/PQ2_0/2bit の UD-IQ2_XXS で27B〜30Bが載った例
Ternary Bonsai 2 27B は、PTQ1_0(5.95 GB)と PQ2_0(7.21 GB)のどちらも -ngl 99、つまり全層をGPUに載せて動きました。-c 8192 の実タスクで、PTQ1_0 は平均56.0 tok/s(VRAMピーク 7,608 MiB)、PQ2_0 は平均49.0 tok/s(8,760 MiB)。llama-bench の tg128 は、PTQ1_0 が 61.37、PQ2_0 が 53.19 でした。
長文脈でも、PTQ1_0 は -c 65536 で 56.26 tok/s(11,105 MiB)、KVキャッシュを q8_0 にした -c 128K で 55.71 tok/s(11,393 MiB)。PQ2_0 は -c 48K で 48.89 tok/s(11,214 MiB)でした。いずれも文脈設定を広げた状態で、短い要約を1回測った値です。
Muse Glimmer 30B は、2bit の UD-IQ2_XXS(10.01GiB)を -ngl 53 で動かし、平均37.9 tok/s(GPU全体のピーク 10,779 MiB)でした。llama-bench の tg128 は 40.09。
Q4_K_M の27B〜30Bが12GBに載りきらなかった例
今回測った Q4_K_M の27B〜30Bは、ファイルが Muse Glimmer 30B で 15.61GiB、Qwen3.8-27B で 17.77 GB あり、今回のRTX 4070(12GB)には全層が載りませんでした。一部の層をCPUに残す形になり、生成は遅くなりました。
- Muse Glimmer 30B(Q4_K_M、15.61GiB):-ngl 38 で平均3.75 tok/s(11,941 MiB)。llama-bench の tg128 は 4.10。DFlash を併用した1回は 7.72 tok/s(採用率 66.0%)でした。
- Qwen3.8-27B(Q4_K_M):-ngl 42 の llama-server 実タスクで 3.55 / 3.56 / 3.54 tok/s(11,856 MiB)。同日の llama-bench の tg128 は 3.55。
- Qwythos-27B v1(Q4_K_M):自動フィット・-c 16384 の実運用で 1.75 tok/s(11,457 MiB)。llama-bench -ngl 42 の tg128 は 3.03 でした。
設定でつまずきやすい点
- 共有GPUメモリへのはみ出し:VRAM 6GBのGPUで MiniCPM5-2B(Q4_K_M)を -c 131072 にすると、共有GPUメモリ(メインメモリの一部)へ +2,702 MiB はみ出しました。それでも測定は最後まで進み、生成は 100.81 tok/s。止まらずに動き続けるので、はみ出しに気づきにくい点に注意してください。Q8_0 の -c 131072 でも、共有GPUメモリ +3,672 MiB。
- 文脈を広げすぎると急に遅くなる:Ternary Bonsai 2 27B の PTQ1_0 は、64K の 56.26 tok/s から、96K で 15.04 tok/s に下がりました。PQ2_0 は 48K で 48.89 tok/s、64K で 17.05 tok/s。
- -ngl を上げれば速くなるとは限らない:Qwen3.8-27B(Q4_K_M)の llama-bench では、-ngl 42 の tg128 が 3.00、-ngl 40 が 2.79、全層を指定した -ngl 99 は 1.31。Qwythos-27B v1 でも、-ngl 42 の 3.03 に対し、-ngl 99 は 1.69 でした。載りきらないモデルでは、-ngl の値を少しずつ試す必要があります。
- MoEモデルは置き方で速度が変わる:VRAM 6GBのGPUで LLM-jp-4.1 32B-A3B を動かしたとき、--n-cpu-moe で配置した場合は 17.92 / 17.82 / 17.89 tok/s、層ごとCPUに回す方法(-ngl 6)では 14.15 tok/s でした。RTX 4070(12GB)の --n-cpu-moe 32 は 約9.0〜9.2 tok/s。元記事には配置を詰め切れていないと書いています。
- RAMの空きにも注意:LLM-jp-4.1 32B-A3B を RAM 32GB の環境で動かしたとき、RAMの空きが最小で約1.1 GiB まで減りました。
- 速度は測り方で値が変わる:同じ MiniCPM5-2B(Q4_K_M)でも、llama-server 実タスクの中央値は 114.59、llama-bench tg128 は 117.14、Ollama は 116.67。別の記事の値と並べるときは、測り方をそろえて読んでください。
この結果から言えること
- VRAM 12GBのGPUをすでに持っている人:RTX 4070(12GB)では、Ternary Bonsai 2 27B(PTQ1_0)が全層GPUで平均56.0 tok/s。今回測った Q4_K_M の27B〜30Bは載りきらず、3.55 / 3.56 / 3.54 tok/s(Qwen3.8-27B、-ngl 42)などにとどまりました。大きなモデルを試すときは、まず量子化の小さい配布物から試すのが近道です。
- いまのGPUが8GB以下の人:VRAM 6GBのGPUでは、MiniCPM5-2B が 114.59 tok/s、LLM-jp-4.1 32B-A3B が --n-cpu-moe 併用で 17.92 / 17.82 / 17.89 tok/s。VRAM 8GBのGPUは未実測です。今回のRTX 4070環境の測定値は、上の12GBの表を見てください。RTX 4070 は、今回動作と速度を確かめた構成の一例です。
【PR】楽天市場でRTX 4070の価格を見る
- より大きなVRAMを考える人:VRAM 16GB・24GBのGPUは未実測です。Q4_K_M の27B〜30Bが全層載るかどうか、どれくらいの速度が出るかは、このブログではまだ確かめていません。
- PCごと替える人:GPUだけでなく、CPUやRAMも速度に関わります。今回の6GB側は CPU 4コア8スレッド・RAM 32GB(16GB×2、DDR4-3200)、12GB側は CPU 8コア8スレッド・RAM 32GB(8GB×4、DDR4-2133 で動作)です(いずれもID 498 の記事の検証環境の値)。中古ゲーミングPCの掲載機種は未実測です。購入前に、GPUのVRAM容量とRAM容量を確かめてください。
【PR】GP-ZEROで中古ゲーミングPCを見る
測定環境
VRAM 6GB側
- GPU:VRAM 6GBのGPU(6,144 MiB)。画面表示もこのGPU
- CPU:4コア8スレッド
- メモリ:RAM 32GB(16GB×2、DDR4-3200)
VRAM 12GB側
- GPU:GeForce RTX 4070 12GB(12,282 MiB)。画面表示もこのGPU
- CPU:8コア8スレッド
- メモリ:RAM 32GB(8GB×4、DDR4-2133 で動作)
PCの構成は、ID 498 の記事の「検証環境」の値。12GB側のほかの記事の構成は、各元記事で確かめてください。
llama.cpp と Ollama の版は、記事ごとに違います。各行の版は、表の「主な設定」の欄を見てください。
元記事の一覧
- ID 533:https://localailab.org/nemotron-3-5-bolt-e4b-vram-6gb/
- ID 522:https://localailab.org/lfm3-1-7b-vram-6gb/
- ID 506:https://localailab.org/minicpm5-2b-vram-6gb/
- ID 498:https://localailab.org/llm-jp-4-1-vram-6gb/
- ID 491:https://localailab.org/muse-glimmer-30b-rtx4070-12gb/
- ID 480:https://localailab.org/ternary-bonsai-2-27b-rtx4070-12gb/
- ID 443:https://localailab.org/llama-server-no-response-antivirus/
- ID 435:https://localailab.org/qwen38-27b-rtx4070-ngl-cliff/
- ID 422:https://localailab.org/qwythos-27b-rtx4070-vram-12gb/
- ID 388:https://localailab.org/minicpm5-1b-ollama-benchmark/
- ID 369:https://localailab.org/qwythos-9b-v2-browser-game/
- ID 317:https://localailab.org/qwythos-9b-32k-context-prefill-vram-6gb/
- ID 287:https://localailab.org/qwythos-9b-vram-6gb-q4-q5-q6/
- ID 235:https://localailab.org/gemma4-rtx4070-12gb-local-llm-benchmark/
コメント