【PR】この記事にはアフィリエイトリンクを含みます。実測に使った機材と、実測していない機材は、リンクごとに区別して記載しています。
結論
Meta の Muse Glimmer 30B を、RTX 4070(VRAM 12GB)で動かした実測結果です。12GBに全部載る unsloth の2bitと、載りきらない Meta公式の4bitを、同じPCで、文脈の長さ・生成の設定・プロンプトをそろえて比べました。
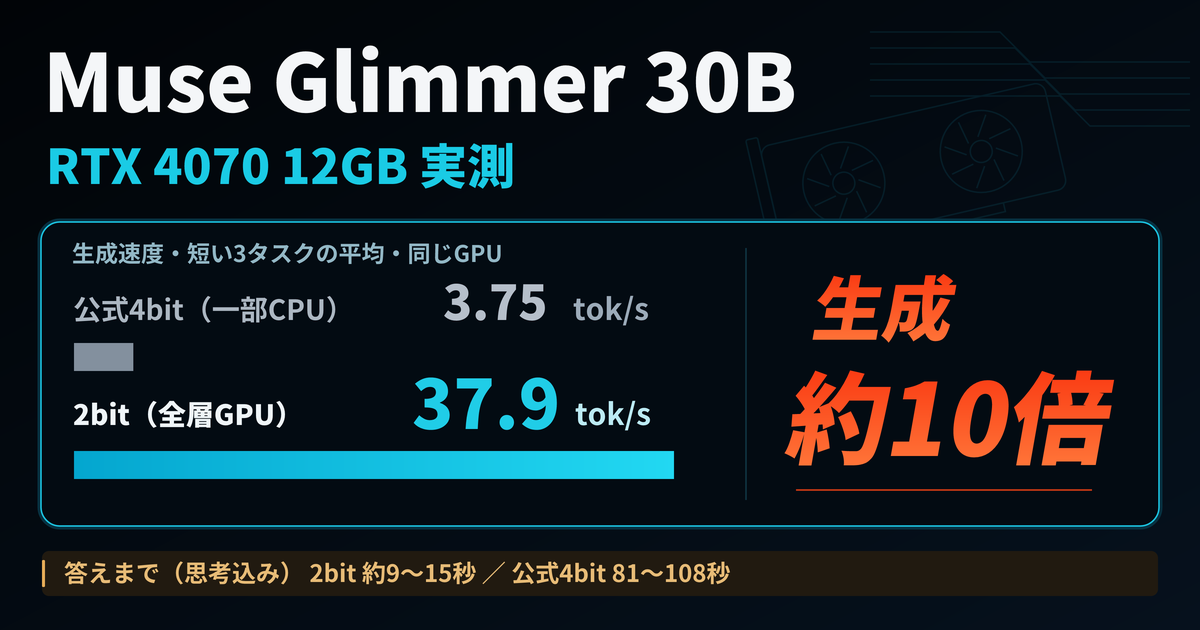
- unsloth の2bit(UD-IQ2_XXS、10.01GiB)は全層がGPUに載り、生成は約38 tok/s。思考(強さ low)を含めて、短い3タスクの答えが 8.6〜15.2秒で返りました
- Meta公式の4bit(17GB版 Q4_K_M、15.61GiB)は12GBに載りきらず、GPUに置けたのは53単位中38でした。生成は約3.7 tok/s、答えまで 81〜108秒。生成速度は2bitが約10倍です
- 品質は、要約とコード相談では明確な差がありませんでした。旅行プランは両方とも地理を間違え、公式4bitは成り立たない交通経路を組みました(各1回。作り手の違う配布物どうしの比較なので、差をビット数だけのせいにはしません)
- 公式4bitに、下書きモデルで生成を速める DFlash を足すと、生成は 3.76 → 7.72 tok/s(約2.1倍)になりました。それでも2bitの約5分の1です(コード相談1件・1回)
- 公式4bitは、GPUに載せる層を34から36に増やすとプロンプト処理が約6.4分の1に落ちました。一方、生成は今回試した llama-bench の構成では38層が最速でした。読む速さと書く速さで、速い層数が違います
RTX 4070 12GBで Muse Glimmer 30B を使うなら、今回の結果では unsloth の2bitです。公式4bitを全層GPUで使えた16GBのGPUの報告もありますが、画面出力に使っていないGPUで空きVRAMが多いなどの条件付きで、16GBなら必ず載るという意味ではありません(本サイトでは未実測)。
Muse Glimmer 30Bとは
Meta が2026年8月10日に公開したモデルです(Meta の発表)。ライセンスは Apache 2.0。MoE ではなく、毎回すべての重みを使う dense 型です(Meta公式のモデルカード)。Meta は30B(300億)としていますが、今回のテキスト用GGUFを llama-bench で読むと、パラメータ数は約278.5億(27.85B)でした。差の内訳は確かめていません。画像入力にも対応しますが、今回は使っていません。
使うときに知っておきたい点が2つあります。
- 思考(推論)をオフにできません。 強さを low / medium / high / xhigh から選びます(既定は high)。今回は主に low で測りました
- Meta公式のGGUFは24GB向けです。 公式の「17GB版」Q4_K_M は 16,756,683,904 bytes(15.61GiB)で、12GBのGPUには載りません。海外メディアの Notebookcheck は、公式4bitを動かせるGPUから12GBの中級GPUを外し、VRAMが少なければ unsloth などの小さい量子化を使い、一部をRAMに逃がすことになって速度が落ちる、と書いています(その構成での速度の数字はありません)。今回の unsloth の2bitは、全53単位が12GBのGPUに載りました
16GBのGPUでは先行の実測があります(後述)。一方、RTX 4070 などの12GBで条件を明示して測った記事は、10月12日時点で見つけられませんでした。
12GBに載るのか
| 配布物 | 大きさ | 今回GPUに置けた単位 |
|---|---|---|
| unsloth の UD-IQ2_XXS(2bit) | 10,746,373,152 bytes(10.01GiB) | 53/53(全部) |
| Meta公式 17GB版 Q4_K_M(4bit) | 16,756,683,904 bytes(15.61GiB) | 38/53(残る15層はCPU) |
| Meta公式 DFlash用の下書きモデル | 1,631,208,128 bytes(1.52GiB) | 6/6(DFlashの測定時。本体は32/53) |
llama.cpp は、52層に出力層を加えた53単位で数えます。RTX 4070 のVRAMは 12,282 MiB で、ここから画面表示や常駐ソフトの分が引かれます(後述)。
2つは、作り手も量子化のしかたも違う「配布物」です。この記事の品質の比較は、unsloth の2bitと Meta公式の4bitという配布物どうしの比較です。
検証環境
| 項目 | 値 |
|---|---|
| GPU | NVIDIA GeForce RTX 4070 / 12,282 MiB |
| ドライバ | 617.42 |
| CPU | Intel Core i7-9700K(8コア8スレッド) |
| RAM | 約32GiB |
| PC | 10月7日の Ternary Bonsai 2 27B の測定と同じPC(Windows) |
| 実行環境 | 通常版 llama.cpp b11574(Windows CUDA 12.4版)。このモデルには b10353 以上が必要です(Meta公式のモデルカード) |
| モデル | unsloth/Muse-Glimmer-30B-GGUF の UD-IQ2_XXS、meta-models/Muse-Glimmer-30B-GGUF の 17GB版 Q4_K_M と DFlash 用の下書きモデル(いずれもSHA256照合済み) |
| サーバ | llama-server、文脈 8,192(-c 8192)、flash attention 有効(-fa on)、--jinja、KVキャッシュは16bit(既定) |
| リクエスト | 思考の強さ low、出力の上限 4,096トークン、temperature 1.0 / top_p 0.95 / top_k 64(公式の推奨値)、シード 20261012 固定、非ストリーミング、プロンプトのキャッシュなし。ほかのサンプラーは使用版の既定値 |
| 計測 | llama-bench -p 512 -n 128(採用した構成は各5回、±は標準偏差)と、llama-server での実タスク(各1回) |
| 常駐ソフト | ウイルス対策ソフト(Norton)は保護機能を有効にしたまま。実タスク・DFlash・思考 high、公式4bitの層数探索(28〜42層)と採用ベンチは、ブラウザなどを閉じたあとに測定。2bitの llama-bench と公式4bitの -ngl 99 は、閉じる前の測定で、常駐分はそろっていません |
用語を先に整理します。トークンはモデルが文章を扱う単位で、1トークン=1文字ではありません。tok/s は1秒あたりに生成(または処理)するトークン数です。答えまでの秒数は、リクエストを送ってから応答が全部返るまでの時間で、プロンプトを読む時間と思考の時間を含みます。モデルの読み込みと暖機(2回の短い生成)を済ませたあとのリクエストで測りました。pp512 は512トークンを読む速さ、tg128 は128トークンを書く速さです。温度(temperature)は、次の語の選び方のばらつきに関わる設定です。VRAMピークは、常駐ソフトを含むGPU全体の使用量を約2秒おきに読んだときの最大値で、モデル単体の必要量ではありません。
速度: 実際に使ったとき(llama-server)
Bonsai の記事と同じ3つのプロンプト(長野1泊2日の旅行プランを500字以内、ローカルLLMの説明文を300字以内に要約、ボタンが動かないHTML/JavaScriptの相談)を、各1回投げました。思考の強さは low です。起動条件は、2bitが -ngl 53、公式4bitが -ngl 38(層数の決め方は後述)で、どちらも -c 8192 です。6つの応答はすべて正常に完了し、出力の上限(4,096トークン)で打ち切られたものはありません。
| タスク | 配布物 | 出力トークン | 生成(tok/s) | 答えまで |
|---|---|---|---|---|
| 旅行プラン | 2bit | 570 | 38.06 | 15.2秒 |
| 旅行プラン | 公式4bit | 378 | 3.70 | 107.6秒 |
| 要約 | 2bit | 332 | 37.71 | 9.1秒 |
| 要約 | 公式4bit | 297 | 3.79 | 83.6秒 |
| コード相談 | 2bit | 317 | 38.04 | 8.6秒 |
| コード相談 | 公式4bit | 284 | 3.76 | 80.9秒 |
- 生成速度の平均は、2bitが 37.9 tok/s、公式4bitが 3.75 tok/s で約10倍。答えまでの秒数では約7.1〜9.4倍の差です(出力の長さが違うので、同じ文章を書かせた比較ではありません)
- 公式4bitは、約185トークンのプロンプトを読むだけで約5.6秒かかりました。2bitは約0.28秒です
- 生成速度は、後述の llama-bench の tg128 に対して2bitが約95%、公式4bitが約91%でした。今回の条件では、生成速度はベンチからほぼ見積もれます
- VRAMのピークは、2bitのサーバが 10,779 MiB、公式4bitのサーバが 11,941 MiB でした。応答中のGPU使用率の平均は、2bitが95〜97%、公式4bitが33〜41%です
思考はオフにできない。low でも出力の3〜7割
このモデルは思考を止められないので、待ち時間には必ず思考の分が入ります。表示された思考文を同じサーバでトークン数に数え直すと(参考値)、low でも出力の約3〜7割が思考でした。
6つの応答とも、思考は質問文を書き写すところから始まり、そのあとは主に英語で考えていました。最終的な回答はすべて日本語です。
コード相談で思考の強さを high に上げると、次のようになりました(各1回)。
| 配布物 | 強さ | 出力トークン | 生成(tok/s) | 答えまで |
|---|---|---|---|---|
| 2bit | low | 317 | 38.04 | 8.6秒 |
| 2bit | high | 718 | 38.06 | 19.1秒 |
| 公式4bit | low | 284 | 3.76 | 80.9秒 |
| 公式4bit | high | 454 | 3.95 | 119.7秒 |
high では思考が長くなり、答えまでの時間が延びました。最終的な回答は、low でも high でも両方正しく直せています。この1問では、high にして回答がよくなったとは言えません。既定は high なので、速さを重視するなら low を指定してください(指定のしかたは後述)。xhigh は測っていません。
品質: 同じ3タスクを並べた
各タスク1回、温度1.0・シード20261012固定です。別のシードや繰り返しでのばらつきは評価していないので、1回ずつの比較は「今回はこうだった」までです。品質は、思考文ではなく最終的な回答で判定しました。
コード相談: 両方とも正答
ボタンの id="countButton" と getElementById("button") の食い違いを、両方とも原因として最初に説明し、正しい修正コードを出しました。差はありません(原因の説明と修正コードを読んで確認しました。ブラウザでの実行はしていません)。
要約: 両方ともほぼ同じ内容
両方とも、原文の「外部に送らず処理できる」「GPUやメモリの性能で動かせるモデルが変わる」「セットアップに手間がある」を3点に整理し、「VRAMが少ない環境では量子化された軽いモデルを選ぶ必要がある」を注意点にしました。文面までほぼ同じで、原文にない情報の追加もありません。300字以内の指示も両方守りました。
旅行プラン(長野1泊2日): 両方とも地理を間違えた
| 500字以内の指示 | 地理の誤り(抜粋) | |
|---|---|---|
| 2bit | 守った | 長野駅から「徒歩10分で善光寺」、「長野駅前の県立美術館」 |
| 公式4bit | 守った | 「新幹線で東京→松本 約2時間」、「特急あずさで松本→軽井沢 約1時間」 |
確かめた事実です。
- 長野駅から善光寺までは約2km、徒歩約30分です(ながの観光コンベンションビューロー)
- 長野県立美術館は、駅前ではなく城山公園内、善光寺の東隣にあります(長野県立美術館)
- 松本への新幹線の直通はありません。東京からは中央線の特急あずさ、または北陸新幹線で長野まで行き、特急しなのに乗り換えます(松本市美術館の交通案内)
- 特急あずさの運行区間に軽井沢は含まれません(JR東日本)
- 2bitの「なかよし公園」、公式4bitの「軽井沢高原ショッピングプラザ」は、回答が指す施設として確認できませんでした
公式4bitは、使えない交通経路が1日目の中心になっていて、この旅行プランはそのままでは成り立ちません。この点では公式4bitのほうが明らかに悪い結果でした。ただ、2bitの案もそのまま使える品質ではありません。
同じ旅行プランの質問は、Bonsai の記事でも5つの構成すべてが地理を間違えました(思考オフ・温度0.7)。Bonsai の記事の5つと今回の2つ、計7つの出力すべてに地理の誤りがありました。 固有名詞や所要時間は、どのモデルでも自分で確かめる前提です。
この結果から言えること
- VRAM 12GBのGPUをすでに持っている人:unsloth の2bit(UD-IQ2_XXS)を全層GPUに載せれば、生成約38 tok/s、短い質問なら思考込みで約9〜15秒で答えが返りました。今回の3タスクでは、公式4bitに見劣りする場面はありませんでした(各1回)。ただし、空きVRAMの余裕は小さめです。起動前にVRAMの使用量を確かめてください(後述)。他の12GB GPUでの速度は未確認です。
- これからGPUを選ぶ人:RTX 4070 12GBは、2bitの Muse Glimmer 30B が全層に載り、約38 tok/s で動くことを今回確かめた構成です。
【PR】楽天市場でRTX 4070の価格を見る
- Meta公式の4bitをそのまま使いたい人:12GBでは約3.7 tok/s、DFlash を足してもコード相談1件で約7.7 tok/s で、答えまで40秒〜2分近く待ちました。画面出力に使っていない RTX 5060 Ti 16GB で、17GB版(1件は別の配布元のもの)を全部載せて 22.8〜24.6 tok/s という第三者の報告が2件あります(条件と測り方はそれぞれ違います。詳しくは後述)。16GBなら必ず全部載るという意味ではありません。RTX 5060 Ti 16GB は、本サイトでは未実測です。
【PR】楽天市場でRTX 5060 Ti 16GBの価格を見る(未実測) - 長い文脈や画像入力も使いたい人:Meta は公式の17GB版を24GB向け、より大きい Dynamic 版(19,653,960,832 bytes、約18.3 GiB)を32GB向けとしています(Meta公式のモデルカード)。長い文脈、画像入力、より大きい配布物を使うなら、より大きなVRAMが候補になります。必要な容量と、RTX 3090(VRAM 24GB)での速度は、本サイトでは未実測です。
【PR】楽天市場でRTX 3090の価格を見る(未実測)
速度: llama-bench
ここから下は、上の数字の裏付けと、動かすときに役立つ細かい結果です。
| 構成 | プロンプト処理 pp512(tok/s) | 生成 tg128(tok/s) | VRAMピーク |
|---|---|---|---|
2bit(-ngl 99、全53単位) | 1305.48 ± 14.80 | 40.09 ± 0.07 | 11,708 MiB |
公式4bit(-ngl 38、38/53) | 57.85 ± 1.80 | 4.10 ± 0.08 | 11,951 MiB |
生成は2bitが約9.8倍、プロンプト処理は約23倍です。2bitの llama-bench は、ブラウザなどを閉じる前の測定です。公式4bitの -ngl 38 は、次の探索で決めました。
公式4bitは「何層載せるか」に落とし穴がある
公式4bitで、GPUに載せる層の数(-ngl)を変えて測りました(各2回の平均)。常駐ソフトの使うVRAMが測定ごとに動いていたので、各測定の直前の値も載せます。
-ngl | プロンプト処理 pp512(tok/s) | 生成 tg128(tok/s) | 直前のアイドルVRAM |
|---|---|---|---|
| 28 | 376.4 | 3.16 | 1,825 MiB |
| 34 | 438.9 | 3.91 | 1,824 MiB |
| 36 | 68.4 | 4.07 | 1,549 MiB |
| 38 | 67.8 | 4.32 | 1,229 MiB |
| 40 | 82.5 | 3.71 | 816 MiB |
| 42 | 80.2 | 2.98 | 1,020 MiB |
| 99(全部載せる指定) | 86.1 | 1.83 | 記録なし(ブラウザなどを閉じる前) |
- 生成は、試した llama-bench の構成では38層が最速でした。42層では38層より約31%遅く、全部載せる指定(
-ngl 99)では1.83 tok/sと半分以下です。エラーは出ません - プロンプト処理は、34層から36層で約6.4分の1(438.9 → 68.4)に落ちました。直前のアイドルVRAMは36層のほうが少なかったので、常駐ソフトの増減だけでは説明しにくい結果です
- 34層と38層を続けて測り直しても、プロンプト処理は 395.2 と 69.4、生成は 3.60 と 4.35 で、同じ傾向でした。38層と40層の測り直しでも、生成は38層が速いままでした(4.12 と 3.72)
なぜ34層と36層の間でプロンプト処理だけが落ちるのかは、確かめていません。1層ずつの境目も測っていません。なお、サーバの起動確認(上限128トークンの短い生成)では、36層(4.34 tok/s)が38層(4.27 tok/s)をわずかに上回りました。差は2%未満なので、実タスクは38層で測りました。
実際のサーバでも同じ傾向が出ています。後述の DFlash の測定で、本体を32層にした構成は184トークンのプロンプトを2.07秒で読みましたが、38層の構成は5.55秒かかりました。長い文書を読ませる使い方なら、34層前後が有利な可能性があります。ただし、これは短い入力の観測からの推測で、長い入力は測っていません。
38層のサーバのログには、Bonsai の記事でも見た警告が出ていました。
common_fit_params: failed to fit params to free device memory: n_gpu_layers already set by user to 38, abortそれでも38層のサーバは正常に動き、実タスクにも採用できました。この警告は「危ないかもしれない」の目印で、遅くなった証拠ではありません。
2bitも、2層をCPUに回すだけで遅くなる
サーバの起動確認(上限128トークンの短い生成、2回目の値)で、2bitを全53単位で載せると 38.74 tok/s、51単位(2層がCPU)では 24.78 tok/s と、約36%遅くなりました。2bitは全部GPUに載せる前提で使ってください。
公式4bitに DFlash を足すと約2倍
DFlash は、小さな下書きモデルが先に数トークンを予想し、本体がまとめて確かめることで生成を速める仕組みです。Meta が専用の下書きモデル(1.52GiB、5層。今回の llama.cpp の配置ログでは6/6単位)を配っています。
12GBでは下書きモデルを置く場所を空ける必要があるので、公式4bitの本体を38層から6層減らした32層にし、空いた分に下書きモデルを全部載せました(予想するトークン数の上限は3)。比べるため、32層でDFlashなしの構成も測りました。タスクはコード相談、思考は low、各1回です。
| 構成 | GPU配置 | 生成(tok/s) | 出力トークン | 答えまで | VRAMピーク(MiB) |
|---|---|---|---|---|---|
| A:公式4bit | 38/53 | 3.76 | 284 | 80.9秒 | 11,941 |
| B:Aから6層減らす | 32/53 | 3.58 | 308 | 87.9秒 | 10,971 |
| C:B+DFlash | 32/53+下書き6/6 | 7.72 | 286 | 42.8秒 | 11,996 |
- C は A の約2.1倍、B の約2.2倍の生成速度でした。A と B の生成速度の差は約4.8%でした(各1回で出力の長さも違うので、層を減らした影響を切り分けたわけではありません)
- 下書きが予想した288トークンのうち、190トークンが採用されました(採用率 66.0%)
- 3つとも、コード相談の回答は正しく直せていました
- ただし C の VRAMピークは 11,996 MiB で、12,282 MiB の上限まで286 MiBでした
それでも、2bitのコード相談(38.04 tok/s、8.6秒)と比べると約5分の1の速さです。12GBで速さを取るなら、DFlash付きの公式4bitより2bitです。
16GBの先行例では、RTX 5060 Ti で52層中7層をCPUに回した構成に、予想の上限3の DFlash を足して1.71倍という報告があります(AIハードウェア図鑑)。こちらは温度0、今回は温度1.0で、CPUに回した層の数も違うので、倍率は直接比べられません。どのタスクでも約2倍になるとも言えません(今回はコード相談1件だけです)。
2bitと DFlash の組み合わせは試していません。2bitのサーバのVRAMピーク(10,779 MiB)に、下書きモデルの重みのGPU側の確保(1,543 MiB)を単純に足すと 12,322 MiB で、12,282 MiB の上限を約40 MiB超えます。さらに下書きモデル用のKVキャッシュ(DFlashの測定では50 MiB)なども要ります。別々の測定の足し算なので、実際に入るかどうかは未実測です。
VRAMの「空き」は1時間で約1 GiB動いた
12GBで2bitを使うなら、いちばん気をつけたいところです。
llama.cpp を動かしていないとき(アイドル時)のVRAM使用量は、10月7日の測定では1,215 MiB(約1.2 GiB)でした。今回はブラウザなどを閉じたあとでも、約1時間の間に785〜1,825 MiB(約0.8〜1.8 GiB)の間で動きました。各測定の直前に記録した値です。
何が増減させたのかは特定できていません。Windows のカウンターでは、Norton の常駐プロセス(model_host.exe、2つ)にGPUの専用メモリが表示され、その値はプロセスと時点によって約130〜740 MiBでした。ただし、このカウンターは値がずれることがあると Microsoft も説明しており(Microsoft の説明)、今回も物理VRAMを超える値が出ていたので、原因とは断定しません。ウイルス対策ソフトは止めずに測りました。止めることはおすすめしません。
2bitのサーバ(文脈8K)を動かしているときのVRAMピークは 10,779 MiB で、直前のアイドルは881 MiBでした。もしアイドルがこの日の最大の1,825 MiBまで増えていたら、残りは計算上559 MiB(約0.55 GiB)です(実測ではありません)。起動する前に nvidia-smi でVRAMの使用量を見てください。 起動後は、サーバのログに offloaded 53/53 layers to GPU と出ていることに加えて、生成速度も確かめてください。9月1日の記事のように、VRAMが足りないとエラーは出ずに遅くなるだけのことがあります。今回の約38 tok/s より大きく遅ければ、VRAM不足を疑ってください。
文脈を広げると、そのぶんKVキャッシュ(文脈の計算結果を保持するメモリ)が増えます。今回は文脈8Kだけで測りました。
16GB・24GBとの関係
第三者の16GBでの実測を2つ紹介します。どちらも本サイトでは再現していません。
- AIハードウェア図鑑:画面出力に使っていない2枚目の RTX 5060 Ti 16GB(起動前のVRAM使用量 0 MiB)で、公式17GB版(今回より前の版)を全部GPUに載せ、生成は約24.6 tok/s(llama-bench の tg128 を3回測った平均)。53単位中52(1層がCPU)では21.82 tok/s(同じ測り方)。記事自身が、16GBのGPU一般に当てはまる話ではないと断っています
- かっぱずさんの記事:外付けで画面出力なしの RTX 5060 Ti 16GB で、lmstudio-community 配布の17GB版を全部GPUに載せ、空の文脈で生成 22.8 tok/s。文脈65,536、KVキャッシュは4bit(q4_0)
どちらも、画面出力に使っていない16GBのGPUでの結果です。今回の RTX 4070 は、llama.cpp を動かしていないときでも785〜1,825 MiBを使っていました。同じように常駐分がある16GBのGPUで公式17GB版が全部載るかは、これらの報告からは分かりません。公式4bitを全部GPUに載せて使いたいなら16GB以上が候補ですが、16GBなら必ず載るとは言えません。
今回の2bit(約38 tok/s)のほうが生成は速い数字ですが、GPU・量子化・配布物・条件がすべて違うので、目安としての比較にとどめます。16GB機・24GB機での速度は、本サイトでは未実測です。
動かすときの注意
- llama.cpp は b10353 以上を使う。 それより前の版は、このモデルを読み込めないと Meta がモデルカードで案内しています。今回は通常版の b11574(Windows CUDA 12.4版)を使いました
-nglと-cを自分で指定する。 2bitは全部載せる指定(-ngl 53または99)、公式4bitは今回試した llama-bench の構成では-ngl 38が生成最速で、実タスクにも採用しました。公式4bitで-ngl 99にすると、エラーは出ずに半分以下の速度になります- 思考の強さはリクエストで指定する。 既定は high です。low にするには、リクエストに
"chat_template_kwargs": {"reasoning_strength": "low"}を付けます。サーバは--jinja付きで起動します - 起動前にVRAMの使用量を見る。 常駐ソフトの使う量は時間とともに変わりました。2bitは余裕が小さめです
- llama-server が応答しないときは、ウイルス対策ソフトを疑ってください。私は9月にこれでつまずきました(llama-serverが応答しない原因はウイルス対策ソフトでした)
今回の起動とリクエストは、次のとおりです(ファイルの場所は省略)。
# 2bit(全層GPU)
llama-server -m Muse-Glimmer-30B-UD-IQ2_XXS.gguf -ngl 53 -c 8192 --parallel 1 --jinja -fa on

# 公式4bit+DFlash(本体32層+下書きモデルを全部GPUに)
llama-server -m Muse-Glimmer-30B-KQuant-17GB-Q4_K_M.gguf -ngl 32 -c 8192 --parallel 1 --jinja -fa on -md dflash-Muse-Glimmer-30B-Q4_K_M.gguf --spec-type draft-dflash --spec-draft-n-max 3 --spec-draft-ngl all
{
"messages": [{"role": "user", "content": "(質問)"}],
"max_tokens": 4096,
"temperature": 1.0, "top_p": 0.95, "top_k": 64,
"seed": 20261012, "cache_prompt": false, "stream": false,
"chat_template_kwargs": {"reasoning_strength": "low"}
}シードを固定しても、別の環境でまったく同じ回答になるとは限りません。思考文は応答の reasoning_content、最終的な回答は content に分かれて返ってきます。
断定していないこと
- RTX 4070 12GB + RAM 約32GiB という1環境、通常版 llama.cpp の1つの版(b11574)での実測です。他のGPU・他の版は測っていません
- 品質は各タスク1回・温度1.0・シード固定・思考 lowでの比較です。別のシードでのばらつきは見ていません。配布物どうしの比較で、差を量子化のビット数だけのせいにはしません
- 思考の強さ high はコード相談1回だけ、xhigh は測っていません
- DFlash はコード相談1回だけです。他のタスクで同じ倍率になるかは分かりません。2bitとの組み合わせは試していません
- 文脈は8Kだけ、入力は約185トークンの短いものだけです。長い文書を読ませたときの速度と、文脈を広げたときに2bitが載り続けるかは測っていません
- 公式4bitで34層と36層の間でプロンプト処理が落ちる理由は確かめていません。長い入力で34層前後が有利かどうかも推測です
- 2bitの llama-bench と公式4bitの
-ngl 99は、ブラウザなどを閉じる前の測定で、ほかの測定と常駐分がそろっていません - 常駐ソフトのVRAM使用量が変わる理由は特定していません
- 16GBの数字は、画面出力に使っていないGPUでの第三者の報告で、本サイトでは再現していません。16GB機・24GB機と画像入力は未実測です
まとめ
RTX 4070 12GB で Muse Glimmer 30B を使うなら、
- unsloth の2bit(UD-IQ2_XXS)を全層GPUに載せる。生成約38 tok/s、短い質問なら思考込みで約9〜15秒。12GBに載りきらない公式4bitの約10倍の速さです
- 品質は、同じ3タスクでは公式4bitに見劣りしませんでした(各1回)。旅行プランの地理は両方とも間違えたので、固有名詞や所要時間は自分で確かめてください
- 公式4bitを12GBで使うなら
-nglを詰め、DFlash を足す。今回試した llama-bench の構成では38層で生成が最速、DFlash でコード相談1件が約2倍になりましたが、それでも2bitの約5分の1です
「公式は24GB向け」の Muse Glimmer 30B も、2bitなら12GBで実用的な速さで動きました。公式4bitをそのまま速く使いたいなら16GB以上が候補ですが、全部載るかは常駐分の空きVRAMや文脈などの条件しだいです(本サイトでは未実測)。
関連記事
- Ternary Bonsai 2 27BをRTX 4070 12GBで実測|27Bが毎秒56トークン、24GBは要るか
- Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった
- llama-serverが応答しない原因はウイルス対策ソフトでした
- Qwythos-27BをRTX 4070 12GBで実測|1.7 tok/s、VRAM 93.3%、24GBが要る理由
llama.cppでの動かし方(思考の強さ、-ngl の読む/書くの境目、DFlash の起動オプション)は、Zennに技術メモとしてまとめています。
Muse Glimmer 30BをRTX 4070で動かす:2bitで全層GPU、思考の強さ、DFlash、-nglの落とし穴(Zenn)
コメント