本文へ移動

ローカルLLM実装

ローカルLLM実装

Recursive FlintはVRAM 6GBで約25 tok/s

総パラメータ39.8BのMoE「Recursive Flint」を、画面表示と兼用のVRAM 6GBのGPUとRAM 32GBのPCで実測。n-cpu-moeと速度、VRAM・RAMの余裕、同じ8問×3回の結果を掲載。
ローカルLLM実装
Nemotron 3.5 Bolt E4BはVRAM 6GBで約58 tok/s

Nemotron 3.5 Bolt E4Bの量子化3つを、画面表示と兼用のVRAM 6GBのGPUで実測。4GB未満だったのはllama-server単体の専用GPUメモリで、GPU全体は4GBを超えた。思考ONの損得も掲載。
ローカルLLM実装

LFM3-1.7BをVRAM 6GBで実測|Q4_K_Mで約152 tok/s

LFM3-1.7BのGGUF(Q4_K_M・QAD版Q4_0・Q8_0)をVRAM 6GBのPCとllama.cppで実測。生成は約152 tok/s(Q4_K_M)。同じ8問×3回の正答は15〜18本で、計算問題は全量子化で正解。前回のMiniCPM5-2Bとも並べました。
ローカルLLM実装

VRAM 6GB/12GBで動くローカルLLMまとめ(実測値)

このブログでは、これまでVRAM 6GBのGPUとRTX 4070(12GB)でローカルLLMを動かしてきまし...
ローカルLLM実装

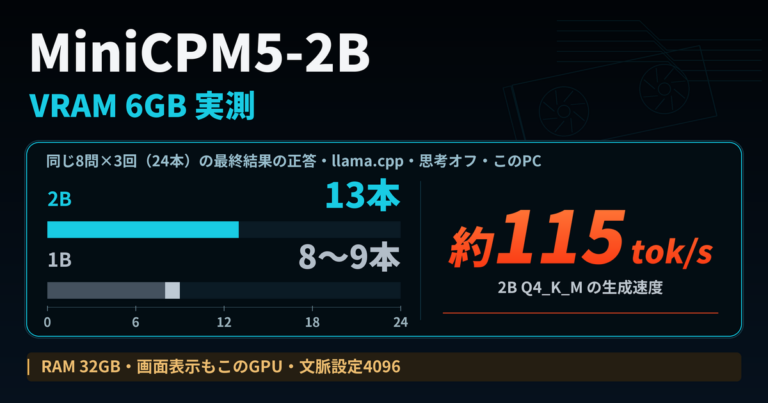
MiniCPM5-2BをVRAM 6GBで実測|約115 tok/s、同じ8問で1Bより正答が増えた

MiniCPM5-2Bの公式GGUFをVRAM 6GBのPCで実測。Q4_K_Mは約115 tok/s。同じ8問×3回で1Bと比較し、Ollamaの結果も掲載。思考オンと文脈・出力上限を増やした条件では、計算・コードの正答増加と約6〜7秒の待ち時間を確認しました。
ローカルLLM実装

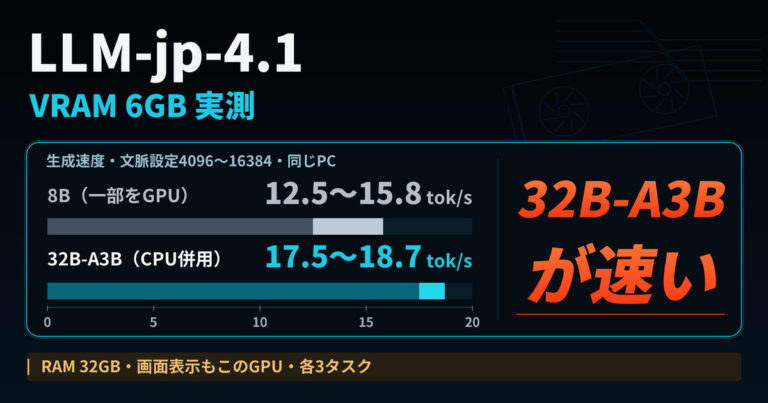
LLM-jp-4.1をVRAM 6GBで実測|CPU併用の32B-A3Bが8Bより速く約18 tok/s

LLM-jp-4.1の公式Q4_K_MをVRAM 6GB・RAM 32GBのPC 1台で実測。画面表示兼用、文脈設定4096〜16384では、CPU併用の32B-A3Bが17.5〜18.7 tok/s、8Bが12.5〜15.8 tok/s。待ち時間・品質・メモリの注意点も紹介。
ローカルLLM実装

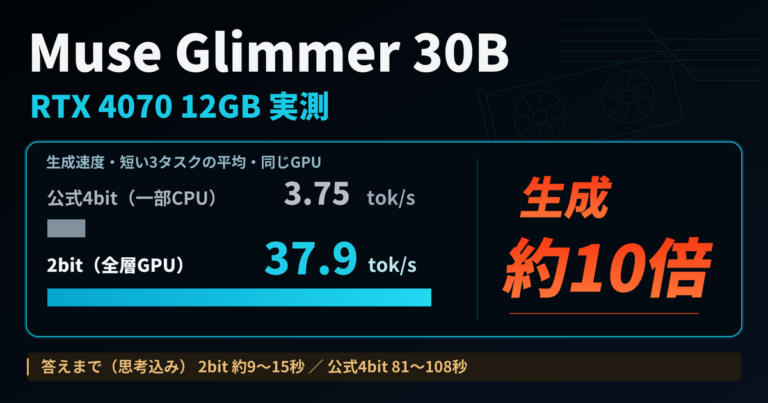
Muse Glimmer 30BをRTX 4070 12GBで実測|2bitは全層GPUで38 tok/s、公式4bitの約10倍

MetaのMuse Glimmer 30BをRTX 4070 12GBで実測。unslothの2bitは全層GPUで約38 tok/s、短い3タスクは思考込みで約9〜15秒。公式4bitは約3.7 tok/sで81〜108秒。品質とDFlashも比較。
ローカルLLM実装

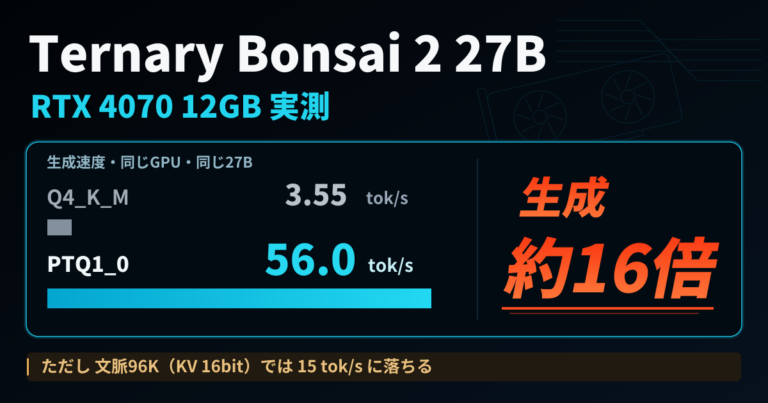
Ternary Bonsai 2 27BをRTX 4070 12GBで実測|27Bが毎秒56トークン、24GBは要るか

Ternary Bonsai 2 27BをRTX 4070 12GBで実測。思考オフの短い3タスクで、PTQ1_0は平均56 tok/s。12GBに載りきらないQ4_K_Mの約16倍でした。同じ3タスクの品質比較と、文脈枠・KV設定を変えたときの速度の変化を公開します。
ローカルLLM実装

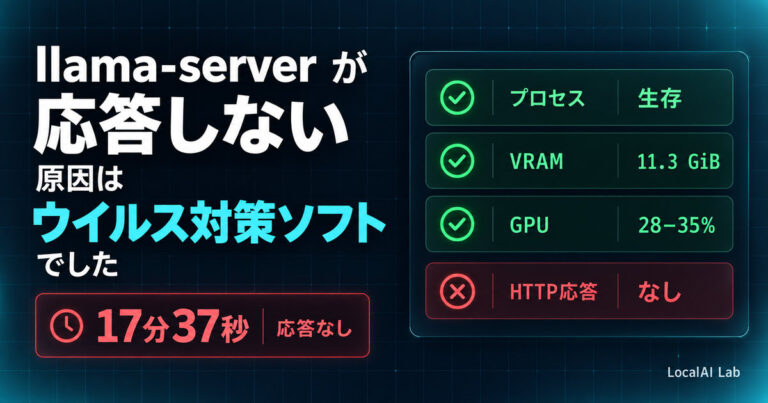
llama-serverが応答しない原因はウイルス対策ソフトでした|ローカルLLMで踏んだ3つの罠

llama-serverが起動しても応答を返さない。プロセスは生きていてVRAMも確保済み、GPUも回っているのにHTTPだけ返らない。手掛かりはウイルス対策ソフトの検出履歴でした。切り分け手順と、あわせて踏んだ2つの罠を実測値つきで公開します。
ローカルLLM実装

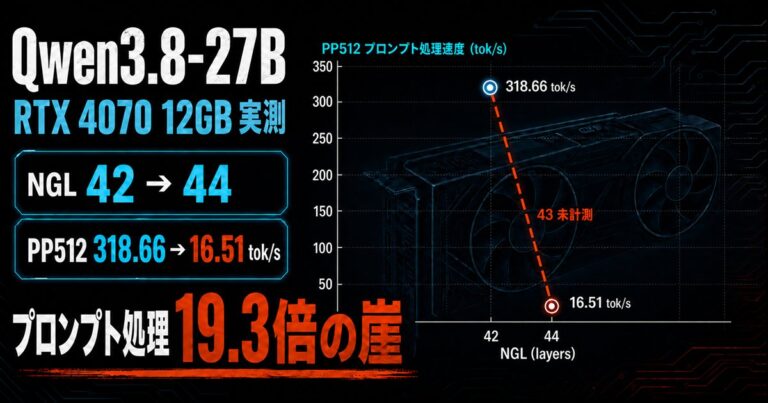
Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった

Qwen3.8-27B Q4_K_MをRTX 4070 12GBで実測。GPUに載せる層数を42から44に増やすだけでプロンプト処理が19分の1に崩落しました。llama-benchの生データと、別の27Bモデルでの再現結果を公開します。