シュン

ローカルLLM実装

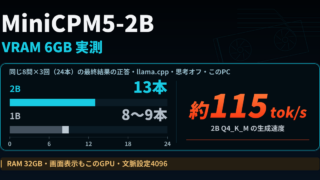
MiniCPM5-2BをVRAM 6GBで実測|約115 tok/s、同じ8問で1Bより正答が増えた

MiniCPM5-2Bの公式GGUFをVRAM 6GBのPCで実測。Q4_K_Mは約115 tok/s。同じ8問×3回で1Bと比較し、Ollamaの結果も掲載。思考オンと文脈・出力上限を増やした条件では、計算・コードの正答増加と約6〜7秒の待ち時間を確認しました。
ローカルLLM実装
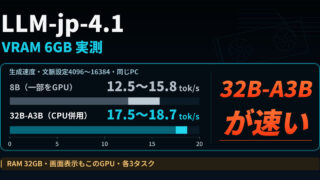
LLM-jp-4.1をVRAM 6GBで実測|CPU併用の32B-A3Bが8Bより速く約18 tok/s

LLM-jp-4.1の公式Q4_K_MをVRAM 6GB・RAM 32GBのPC 1台で実測。画面表示兼用、文脈設定4096〜16384では、CPU併用の32B-A3Bが17.5〜18.7 tok/s、8Bが12.5〜15.8 tok/s。待ち時間・品質・メモリの注意点も紹介。
ローカルLLM実装

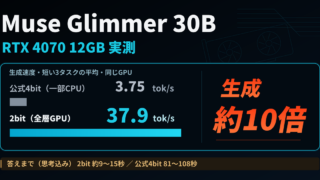
Muse Glimmer 30BをRTX 4070 12GBで実測|2bitは全層GPUで38 tok/s、公式4bitの約10倍

MetaのMuse Glimmer 30BをRTX 4070 12GBで実測。unslothの2bitは全層GPUで約38 tok/s、短い3タスクは思考込みで約9〜15秒。公式4bitは約3.7 tok/sで81〜108秒。品質とDFlashも比較。
ローカルLLM実装

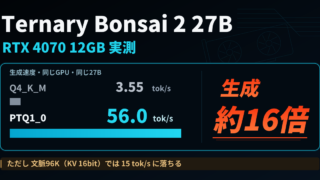
Ternary Bonsai 2 27BをRTX 4070 12GBで実測|27Bが毎秒56トークン、24GBは要るか

Ternary Bonsai 2 27BをRTX 4070 12GBで実測。思考オフの短い3タスクで、PTQ1_0は平均56 tok/s。12GBに載りきらないQ4_K_Mの約16倍でした。同じ3タスクの品質比較と、文脈枠・KV設定を変えたときの速度の変化を公開します。
ローカルLLM実装

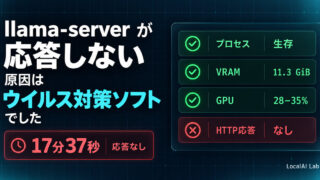
llama-serverが応答しない原因はウイルス対策ソフトでした|ローカルLLMで踏んだ3つの罠

llama-serverが起動しても応答を返さない。プロセスは生きていてVRAMも確保済み、GPUも回っているのにHTTPだけ返らない。手掛かりはウイルス対策ソフトの検出履歴でした。切り分け手順と、あわせて踏んだ2つの罠を実測値つきで公開します。
ローカルLLM実装

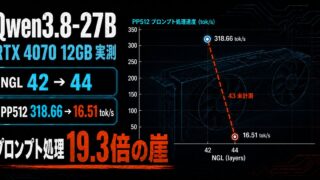
Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった

Qwen3.8-27B Q4_K_MをRTX 4070 12GBで実測。GPUに載せる層数を42から44に増やすだけでプロンプト処理が19分の1に崩落しました。llama-benchの生データと、別の27Bモデルでの再現結果を公開します。
ローカルLLM実装

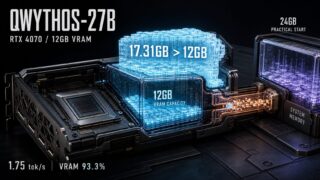
Qwythos-27BをRTX 4070 12GBで実測|1.7 tok/s、VRAM 93.3%、24GBが要る理由

Qwythos-27B-v1 Q4_K_M(実体17.31GB)をRTX 4070 12GBで実測。VRAM最大93.3%、生成1.7 token/s。全層GPU環境との比較から、量子化の選択よりVRAMに収まるかが支配的だと分かりました。
AI業界解説

Kimi K3とは?普通のPCで動かなくても、約1.56TBのオープンウェイトLLMを今保存する意味

Kimi K3は総2.8兆パラメータ、約1.56TBのオープンウェイトLLMです。特徴、ライセンス、必要容量、現在の実行環境、今保存する意味、Web・APIで使う方法を公式情報から整理します。
ローカルLLM実装

MiniCPM5-1Bを本格検証:656 MiBの小型LLMは日本語・コード・ゲーム生成に使える?

約10.8億パラメータ、Q4 656 MiBのMiniCPM5-1BをRTX 4070環境で検証。日本語、JSON、推論、コード、ツール呼び出し、4K~120K長文、ゲーム実操作、速度・VRAMをQwen/LFMと比較します。
ローカルLLM実装

Qwythos-9B v2でブラウザゲーム生成は改善した?v1 Q5/Q6/Q8・Claude Opus 4.8と比較

Qwythos-9Bの旧版Q5/Q6/Q8と新しいv2 Q8_0をRTX 4070で検証。同じ2Dシューティングを生成し、速度、VRAM、実ブラウザ動作、修正後の完成度をClaude Opus 4.8の参照結果とともにまとめます。