
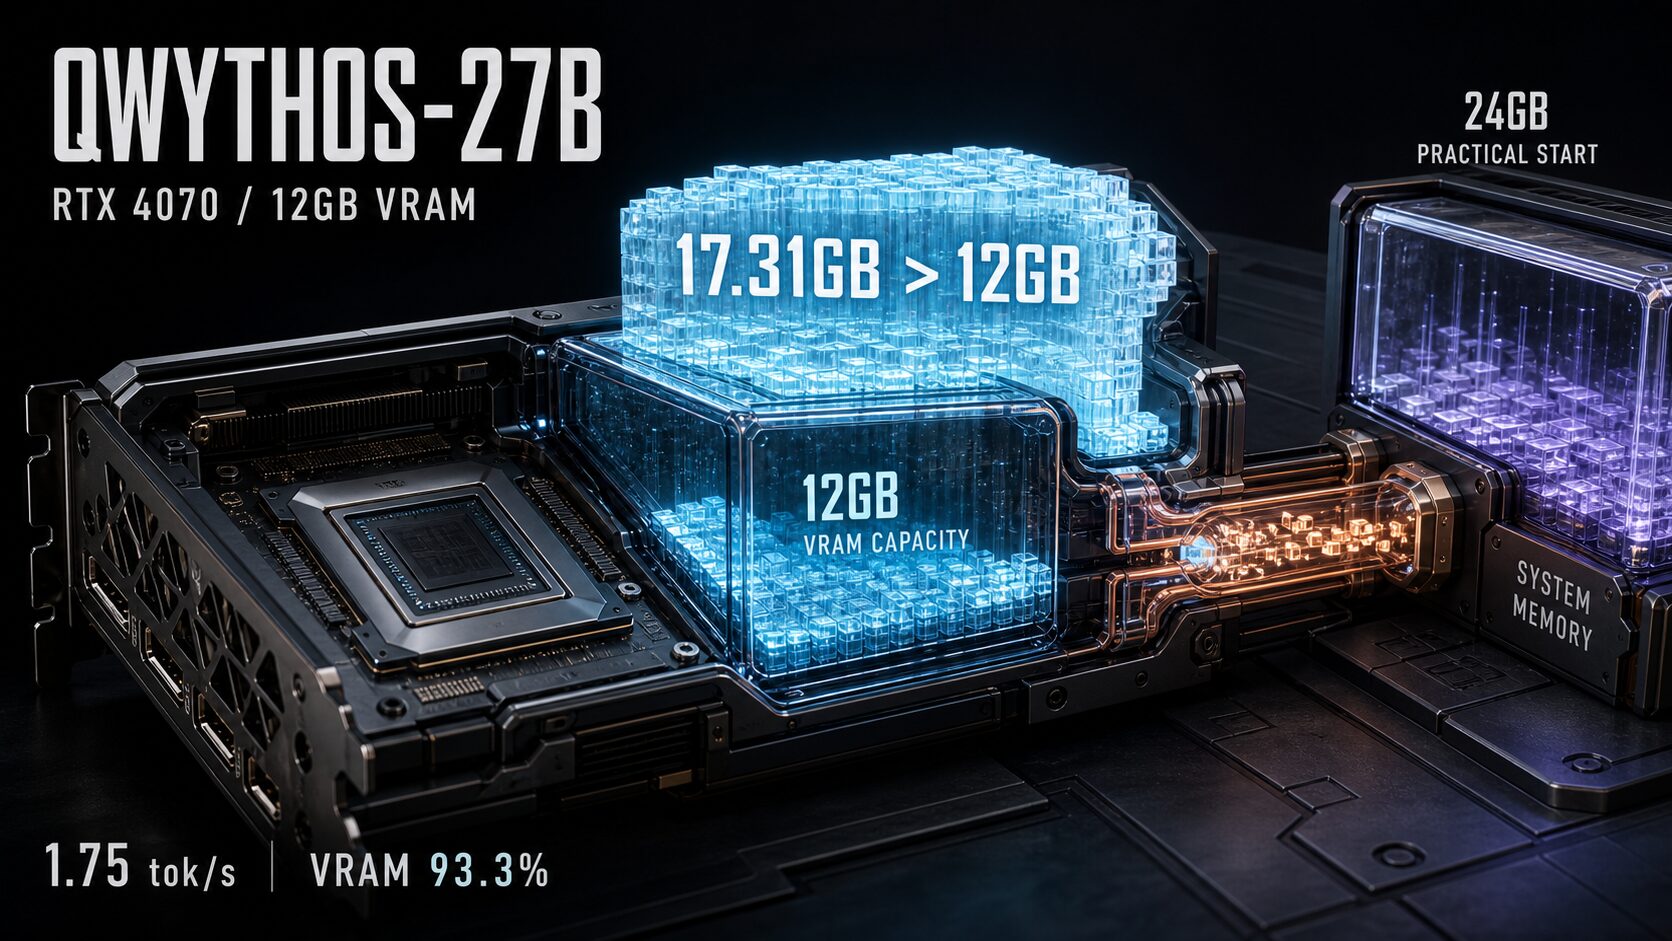
17GB級の27BモデルをVRAM 12GBのGPUで動かすと、実際どうなるのでしょうか。
※本記事にはアフィリエイトリンク(広告)が含まれます。
Qwythos-27B-v1のQ4_K_Mを、RTX 4070 12GBとRAM 32GBのPCで実測しました。結論から書きます。
起動はします。ただし生成は1.7 token/s。VRAMは93.3%まで埋まり、量子化を選ぶ以前に「VRAMへ収まるか」で結果がほぼ決まりました。
先に結果
| 項目 | 実測値 |
|---|---|
| モデル実サイズ | 17,314,170,272 bytes(約17.31GB) |
| VRAM最大使用 | 11,457 MiB / 12,282 MiB(93.3%) |
| GPU使用率 | 平均23.43%、最大100% |
| prompt処理速度 | 126.51 token/s |
| 生成速度 | 1.75 token/s |
| コンテキスト | 16,384 tokens |
【2026-09-02 追記】この 1.75 token/s は、GPUに載せる層数を自動フィットに任せた状態での値でした。同じモデル・同じGPUで層数を -ngl 42 に固定して測り直すと 3.03 token/s(1.73倍)が出ます。計測ツールとビルドが違う(本記事はllama-server/build 10241、追試はllama-bench/build 10456)ため単純比較ではありませんが、27BがRTX 4070で1.7 token/s止まりなのはモデルの限界ではなく、設定の問題でした。層数を2つ増やすとプロンプト処理が19分の1に落ちる崖も見つかっています。詳しくはQwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなったにまとめました。
同じQ4_K_Mを全層GPUに載せた公式の測定値(RTX 5090 32GB、4Kコンテキスト)は、prompt 約622 token/s、生成 約74 token/sです。
効くのは「収まるか」であって量子化ではない
公式値と並べると、差の出方が対称ではありません。
| 指標 | 本環境(部分オフロード) | 公式(全層GPU) | 差 |
|---|---|---|---|
| prompt処理 | 126.51 token/s | 約622 token/s | 約4.9倍 |
| 生成 | 1.75 token/s | 約74 token/s | 約42倍 |
prompt処理は5倍しか落ちていないのに、生成は42倍落ちています。
ただし、この比較は条件を統制したものではありません。GPUの世代(RTX 4070とRTX 5090)もコンテキスト長(16,384と4,096)も違うため、42倍という数字はオフロードだけの影響ではなく、GPU性能差を含んだ合計です。
それでも並べる意味があるのは、差の出方が揃っていないことにあります。純粋にGPUの差であれば、prompt処理と生成は似た比率で落ちるはずです。片方が4.9倍、もう片方が42倍というずれ自体が、オフロードが生成側だけを狙い撃ちしていることを示しています。
prompt処理は入力をまとめて計算に流せるため、計算能力が主なボトルネックになります。一方、生成は1トークンごとに全パラメータを読み直すので、重みをどこに置いたかが直撃します。GPUに載らなかった層はメインメモリ側にあり、生成のたびにそこを経由します。
GPU使用率が平均23.43%だったのも同じ理由です。GPUが遅いのではなく、GPUが待っている状態でした。
つまりQ4_K_MからQ5、Q6へ量子化を上げ下げする議論より先に、そのファイルがVRAMに収まるかどうかで結果の桁が変わります。
12GBに収まらない理由
| ファイル | サイズ |
|---|---|
| Qwythos-27B-Q4_K_M.gguf | 17,314,170,272 bytes(約17.31GB) |
| mmproj-Qwythos-27B-F16.gguf | 927,606,944 bytes(約0.93GB) |
モデル本体だけで12GBのVRAMを超えます。さらに16KコンテキストのKVキャッシュと実行時領域が必要です。
公式のハードウェア案内でも、Q4_K_Mは控えめなコンテキストで24GB GPUが実用上の開始点とされています。RTX 4070 12GBは「起動できるか」を試す構成であって、常用する構成ではありません。
なお、モデルカードの表ではQ4_K_Mが15.78GiB / 16.95GBと記載されていますが、公式のファイルAPI、HTTPヘッダー、実際に取得したファイルはいずれも17,314,170,272 bytesでした。この記事では実ファイルの値を使っています。MTP版との取り違えではありません(MTP版は17,603,699,008 bytes)。
検証環境
| 項目 | 内容 |
|---|---|
| OS | Windows 11 Pro |
| CPU | Intel Core i7-9700K 3.60GHz |
| RAM | 約32GB |
| GPU | NVIDIA GeForce RTX 4070(12,282 MiB) |
| llama.cpp | build 10241、CUDA 12.4版 |
| モデル | Qwythos-27B Q4_K_M、通常版 |
| コンテキスト | 16,384 tokens、1 slot |
| KVキャッシュ | q8_0、flash attention有効 |
| サンプリング | temp 0.6 / top_p 0.95 / top_k 20 / repeat 1.05 |
llama.cppの自動フィットでGPUに載る範囲をオフロードし、残りをCPU側で処理しました。両ファイルとも取得後に公式SHA256SUMSとの一致を確認しています。
MTP版という選択肢
このリポジトリには投機的デコード用のMTPヘッドを内蔵したQwythos-27B-MTP-Q4_K_M.ggufもあり、llama.cppの--spec-type draft-mtpで使えます。生成速度を改善できる可能性があります。
今回は通常版を使いました。MTP版は約0.29GB大きく、すでにVRAMを93.3%使い切っている構成ではオフロード比率がさらに悪化するためです。この環境でMTPがどれだけ効くかは未検証で、次の課題として残しています。
推論の質は落ちていない
速度は厳しいものの、出力の中身が崩れていたわけではありません。
架空の無人深海探査艇の事故調査を題材に、航行ログ、センサー仕様、整備記録、電力ログ、配線パネル画像など11点の資料を渡し、証拠だけで原因を特定させました。正解と100点の採点表は生成前に固定し、モデルには見せていません。
結果は89/100でした。圧力センサーの単位設定ミス(psiをkPaとして処理し、表示深度が実際の約1/6.89476になる)と、バラスト解放が試験回路側へ流れていた事実を、別々の証拠から一つの事故連鎖へまとめています。
一方で、深度のしきい値比較を取り違えた箇所、電圧の大小関係が逆になった箇所、証拠にない推測を混ぜた箇所が残りました。中核の推論は信頼できても、数値の大小と時系列は人間が確認する必要があります。
この出力には約55分かかりました(prompt 4,660 / completion 5,683 tokens)。
長文生成はこの構成では回らない
続けて、調査結果から1ファイルHTMLのダッシュボードを作らせました。こちらは完成しませんでした。
ただしこれはモデルの限界というより、構成の制約です。公式のサンプリング推奨はmax_new_tokensを16,384以上としていますが、VRAMが飽和していてコンテキストを16,384より広げられず、出力枠は8,192が上限でした。初回はpromptが7,510 tokensあり、残りは8,874 tokens。枠を使い切って途中終了しています。
仮に枠を確保できたとしても、1.7 token/sで16,384トークンなら1回に約2時間41分かかります。長いコードを何度も作り直す使い方は、速度の面でも成立しません。
どのGPUなら実用になるか
今回の結果から言えることです。
- 12GB:起動と単発の分析は可能。長文生成や試行錯誤には向かない
- 24GB:公式が示す実用上の開始点。Q4_K_Mを控えめなコンテキストで収められる
- 32GB:全層オフロードで約74 token/sという公式測定がある領域
実売価格の目安を確認するなら、次のあたりが起点になります。
- 24GB級を狙う場合:現行ならRTX 4090、価格を抑えるなら中古のRTX 3090(24GB)が候補です(いずれも本サイトでは未実測。公式案内の「24GBが実用開始点」に基づく選択肢です)。
【PR】楽天市場でRTX 3090の価格を見る
- 今回の検証構成(12GB):起動確認と単発分析までなら本記事の実測どおり動きます。
【PR】楽天市場でRTX 4070の価格を見る - 中古PCごと導入する場合:RTX 3090搭載の中古ゲーミングPCが24GB級の最安経路になることが多いです。
【PR】GP-ZEROで中古ゲーミングPCを見る
手元のGPUで試行回数を確保できるかは、モデルサイズを上げるかどうかと同じくらい重要です。9BクラスならRTX 4070のVRAMに全層載るため、同じ時間で何度も試せます。
関連記事:
Qwythos-9BはVRAM 6GBでどこまで動く?Q4/Q5/Q6を比較検証
Qwythos-9B v2でブラウザゲーム生成は改善した?v1 Q5/Q6/Q8・Claude Opus 4.8と比較
まとめ
- Qwythos-27B-v1 Q4_K_M(実体17.31GB)はRTX 4070 12GBで起動する
- VRAMは11,457 MiB / 12,282 MiB、93.3%まで埋まる
- 生成は1.75 token/s。全層GPU環境の約74 token/sに対して約42倍遅い
- 一方でprompt処理の差は約4.9倍にとどまる。生成側だけが重く沈む
- GPU使用率は平均23.43%。GPUは待っている
- 推論の質は保たれており、固定正解に対して89/100
- 長文生成は出力枠と待ち時間の両面で成立しない
今回の実測から得られた一番実用的な結論はこれです。量子化を1段下げるより、VRAMに収まるモデルを選ぶほうが効きます。

コメント