本文へ移動

ローカルLLM

ローカルLLM実装

VRAM 12GBで本当に使えるモデル|12Bは32Kでも約53 tok/s

VRAM 12GBのGPUで、gemma-4-12BのQ4は文脈32768でも約53 tok/s。Qwen3-14Bは16Kで約32 tok/s、27Bは約1.8 tok/s。
ローカルLLM実装
Recursive FlintはVRAM 6GBで約25 tok/s

総パラメータ39.8BのMoE「Recursive Flint」を、画面表示と兼用のVRAM 6GBのGPUとRAM 32GBのPCで実測。n-cpu-moeと速度、VRAM・RAMの余裕、同じ8問×3回の結果を掲載。
ローカルLLM実装

Nemotron 3.5 Bolt E4BはVRAM 6GBで約58 tok/s

Nemotron 3.5 Bolt E4Bの量子化3つを、画面表示と兼用のVRAM 6GBのGPUで実測。4GB未満だったのはllama-server単体の専用GPUメモリで、GPU全体は4GBを超えた。思考ONの損得も掲載。
ローカルLLM実装

LFM3-1.7BをVRAM 6GBで実測|Q4_K_Mで約152 tok/s

LFM3-1.7BのGGUF(Q4_K_M・QAD版Q4_0・Q8_0)をVRAM 6GBのPCとllama.cppで実測。生成は約152 tok/s(Q4_K_M)。同じ8問×3回の正答は15〜18本で、計算問題は全量子化で正解。前回のMiniCPM5-2Bとも並べました。
ローカルLLM実装

VRAM 6GB/12GBで動くローカルLLMまとめ(実測値)

このブログでは、これまでVRAM 6GBのGPUとRTX 4070(12GB)でローカルLLMを動かしてきまし...
ローカルLLM実装

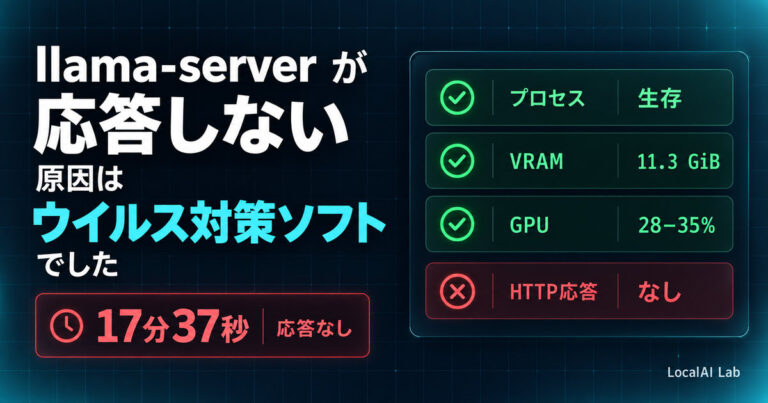
llama-serverが応答しない原因はウイルス対策ソフトでした|ローカルLLMで踏んだ3つの罠

llama-serverが起動しても応答を返さない。プロセスは生きていてVRAMも確保済み、GPUも回っているのにHTTPだけ返らない。手掛かりはウイルス対策ソフトの検出履歴でした。切り分け手順と、あわせて踏んだ2つの罠を実測値つきで公開します。
ローカルLLM実装

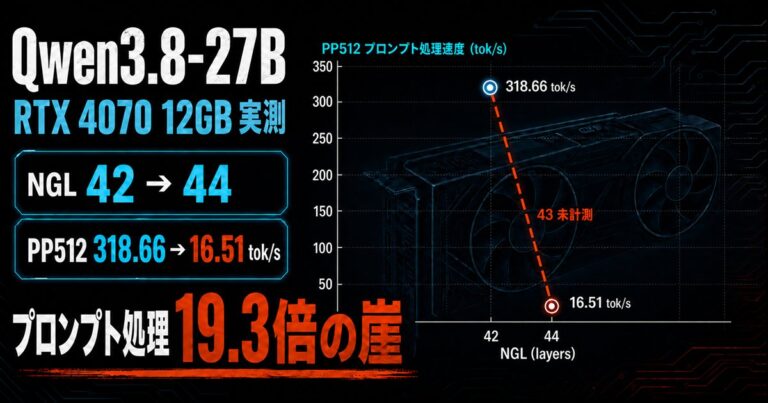
Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった

Qwen3.8-27B Q4_K_MをRTX 4070 12GBで実測。GPUに載せる層数を42から44に増やすだけでプロンプト処理が19分の1に崩落しました。llama-benchの生データと、別の27Bモデルでの再現結果を公開します。
ローカルLLM実装

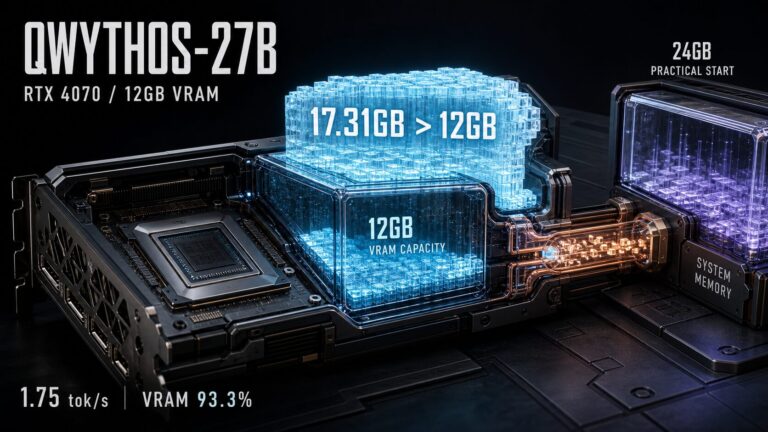
Qwythos-27BをRTX 4070 12GBで実測|1.7 tok/s、VRAM 93.3%、24GBが要る理由

Qwythos-27B-v1 Q4_K_M(実体17.31GB)をRTX 4070 12GBで実測。VRAM最大93.3%、生成1.7 token/s。全層GPU環境との比較から、量子化の選択よりVRAMに収まるかが支配的だと分かりました。
AI業界解説

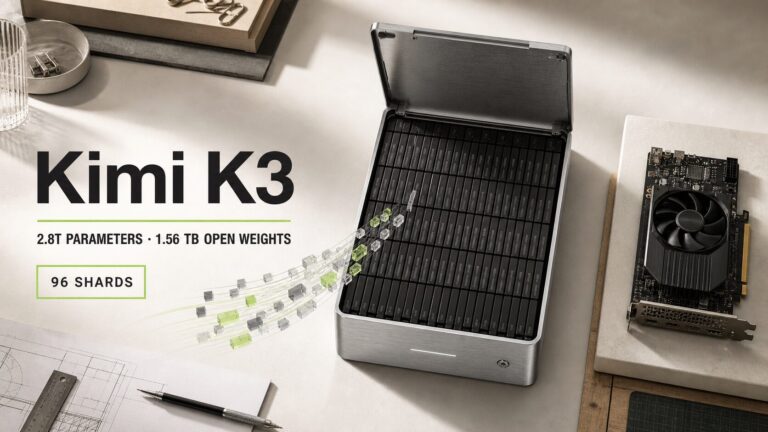
Kimi K3とは?普通のPCで動かなくても、約1.56TBのオープンウェイトLLMを今保存する意味

Kimi K3は総2.8兆パラメータ、約1.56TBのオープンウェイトLLMです。特徴、ライセンス、必要容量、現在の実行環境、今保存する意味、Web・APIで使う方法を公式情報から整理します。
ローカルLLM実装

MiniCPM5-1Bを本格検証:656 MiBの小型LLMは日本語・コード・ゲーム生成に使える?

約10.8億パラメータ、Q4 656 MiBのMiniCPM5-1BをRTX 4070環境で検証。日本語、JSON、推論、コード、ツール呼び出し、4K~120K長文、ゲーム実操作、速度・VRAMをQwen/LFMと比較します。