 ローカルLLM実装
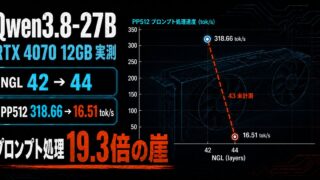
Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった
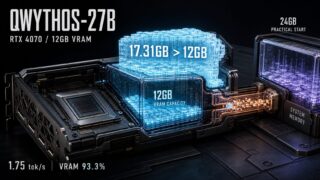
Qwen3.8-27B Q4_K_MをRTX 4070 12GBで実測。GPUに載せる層数を42から44に増やすだけでプロンプト処理が19分の1に崩落しました。llama-benchの生データと、別の27Bモデルでの再現結果を公開します。
 ローカルLLM実装
 ローカルLLM実装
 ローカルLLM実装
 ローカルLLM実装
 ローカルLLM実装
 ローカルLLM実装