
※本記事にはアフィリエイトリンク(広告)が含まれます。実測に使った機材と、実測していない代替機の価格リンクを分けて記載しています。
先に結論
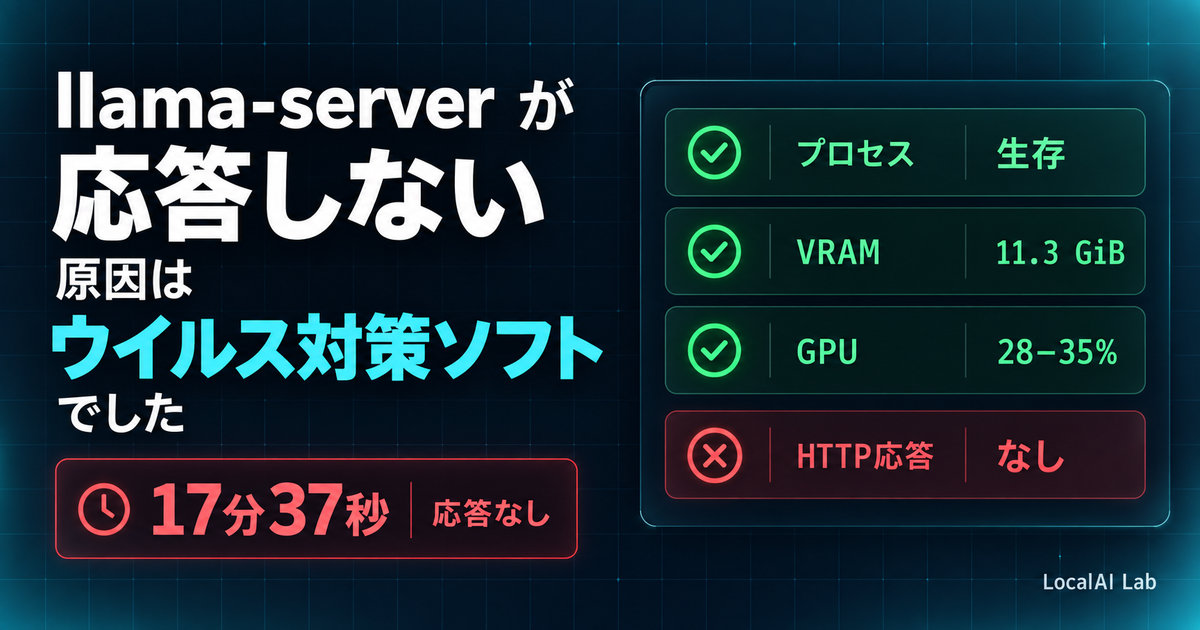
RTX 4070でローカルLLMを動かそうとして、llama-serverが2日間まったく応答しませんでした。原因は3つ重なっていました。
- ウイルス対策ソフトのふるまい検知が
llama-server.exeをブロックしていた - llama-benchで最速だった設定が、サーバでは起動すらしなかった
- PowerShellが206文字のプロンプトを46MBのJSONに膨らませていた
最初の2つは、原因を示す分かりやすいエラーが出ません。1番目に至っては、プロセスは生きていてVRAMも確保済み、GPUも回っている状態で、HTTPの応答だけが返らないという状態でした。3つ目は 413 エラーが出ますが、送っているのは206文字のプロンプトなので、最初は意味が分かりませんでした。
1と2は「起動して応答するまで」の問題、3は「起動したあとリクエストを送る」段階の問題です。
同じところで止まっている人向けに、切り分けの手順ごと残します。
検証環境
OS         : Windows 11 Pro (build 26200)
PowerShell : Windows PowerShell 5.1.26100.9278 (Desktop)
GPU        : RTX 4070 12GB / CPU: i7-9700K / RAM: 32GB
llama.cpp  : b10456 (commit f275595dd) win-cuda-12.4
モデル      : Qwen3.8-27B Q4_K_M (16.54 GiB)
ウイルス対策 : Norton 360(当時のバージョンは未記録)
罠1:ウイルス対策ソフトが、エラーを出さずに止めていた
症状
llama-server.exe を起動すると、こうなります。
- プロセスは生きている(タスクマネージャに出ている)
- VRAMも確保されている(
nvidia-smiで 11.3 GiB) - GPU使用率も 28〜35% で回り続けている
- なのに
/healthを叩いても、いつまでも返ってこない
決定的だったのは、起動ログがモデル読み込みの途中で止まっていたことです。
0.01.349.453 W model has unused tensor blk.64.nextn.eh_proj.weight -- ignoring
0.01.349.462 W model has unused tensor blk.64.nextn.enorm.weight -- ignoring
0.01.349.471 W model has unused tensor blk.64.nextn.hnorm.weight -- ignoring
0.01.349.498 W model has unused tensor blk.64.nextn.shared_head_norm.weight -- ignoring
(ここで終わり。以降17分間、1行も増えない)
起動から 1.35秒 の地点です。正常に起動する場合はこの数秒後に model loaded と listening on http://127.0.0.1:8080 が出ますが、そこまで到達していません。それでいてプロセスは死なず、VRAMを 11.3 GiB 掴んだまま、GPUを回し続けます。17分37秒待って諦めました。
原因
Norton 360 が llama-server.exe を IDP.Generic(ふるまい検知)として検出し、ブロックしていました。
セキュリティ履歴を見に行って、ようやく分かりました。検出時刻は 18:21:26。こちらがサーバを起動したのは 18:21:19 です。起動の7秒後に検出され、状態は「未解決」のまま放置されていました。画面の通知は出ていたのですが、別の作業をしている間に流れて消えていました。
なぜ気づけないのか
1. エラーが出ない。 今回のllama.cppのログには、セキュリティソフトによる検出を示すエラーは見当たりませんでした。起動ログが途中で止まるだけです。
2. llama-benchは素通りする。 同じフォルダの、同じCUDAコードを使う llama-bench.exe は検出されませんでした。ベンチが8構成すべて完走するので、「モデルもビルドもGPUも正常」という結論に行き着いてしまいます。実際、私は最初「Gated DeltaNetの融合カーネルが無効化されているせいでは」と疑って、まったく見当違いの方向を掘っていました。
3. 通知が流れる。 検出そのものは記録されているのに、リアルタイムでは気づけません。
対処
まず検出履歴を確認します。起動時刻の前後1分を見て、対象ファイル・検出名・実行された処置を控えてください。ここを見ないまま除外を入れるのは順序が逆です。
誤検出が疑われる場合は、定義を更新したうえでNorton公式の誤検出報告の手順を確認するのが本筋です。そのうえで除外が必要なら、対象の実行ファイルなど必要最小限の範囲に限定してください。
私がやったことは、そのまま真似しないでください。検証を急いで作業フォルダごと除外に入れましたが、この方法だとそのフォルダ配下に後から置いた無関係なファイルまで保護対象から外れます。検証専用と割り切れる環境でなければ、範囲は絞るべきでした。
なお設定画面の項目名は製品バージョンによって異なります。以下は私の環境で応答が戻ったときの記録であって、一般的な手順として保証できるものではありません。
除外前に試して、すべて応答がなかったのがこの4つです。
| 構成 | 結果 |
|---|---|
llama-server -ngl 42 -c 8192 |
17分37秒 応答なし |
llama-server -ngl 32 -c 8192 |
約9分 応答なし |
llama-cli -ngl 32 -c 4096 |
約7分 出力なし |
llama-cli -ngl 32 -c 512 |
約7分 出力なし |
除外を入れたあと、4構成を試し直しました。
| 構成 | 起動〜応答 | 生成速度 |
|---|---|---|
-ngl 99 -c 2048 |
50秒 | 0.81 tok/s |
-ngl 0 -c 2048 |
10秒 | 0.77 tok/s |
-ngl 32 -c 2048 |
10秒 | 1.39 tok/s |
-ngl 32 -c 512 -fa on |
10秒 | 1.36 tok/s |
正直に書いておくと、この2つの表は厳密なA/Bではありません。除外後はコンテキスト長を 8192 から 2048 に下げています(理由は罠2)。ただ、除外前はどの構成でも7分以上まったく応答がなく、除外後はすべて1分以内に応答しています。
そして注意すべき点として、-ngl 42 + -c 8192 は除外を入れたあとも動きません(罠2で詳しく書きます)。ではこの17分はどちらが効いていたのか。手掛かりはログの止まる位置です。除外前は1.35秒地点(モデル読み込みの途中)で止まり、model loaded に到達していません。除外後の同じ構成は、そこを通過して7.8秒地点まで進みます。この17分についてはウイルス対策ソフトの側だと考えていますが、除外の有無だけを変えた同一条件の比較はしていません。
私が疑っていた resolve_fused_ops の警告は、原因ではありませんでした。この警告は正常に応答する構成でも同じように出ますし、そもそも止まった実行のログは、その行が出るより前(1.35秒地点)で停止していました。推測を断定せずに「未確定」と書いて残しておいて助かりました。
ローカルLLMが「動くはずなのに無反応」なとき、セキュリティソフトの除外設定は最初に確認する価値があります。
罠2:llama-benchで最速だった設定が、サーバでは起動しなかった
原因1が消えたので、前回の記事でllama-benchの生成速度が最速だった -ngl 42 をそのままサーバに持ち込みました(プロンプト処理が最速だったのは -ngl 40 です)。実運用のつもりで -c 8192 を付けて起動します。
610秒待っても /health が ok になりませんでした。タイムアウトだったのか 503(モデル読み込み中)が返っていたのかは、生ログを残していないため区別できていません。
そのあいだのGPUを記録していました。
- VRAM: 11,893 MiB / 12,282 MiB(96.9%)
- GPU使用率: 286サンプルの平均98.7%
前回の記事で「崩壊域」と呼んだ ngl=99 の挙動(GPU使用率98%・処理は進まない)と、まったく同じ形です。
-ngl 32 + -c 2048 に落とすと、9秒で起動しました。
実際に測るとこうなります
同じ -ngl 32 で、llama-benchの値とサーバの実測値を並べます。
| 同じ ngl=32 | llama-bench | llama-server 実測 | 比 |
|---|---|---|---|
| プロンプト処理 | 292.57 tok/s | 58.57〜62.56 tok/s | 約5分の1 |
| 生成 | 2.25 tok/s | 2.06〜2.08 tok/s | 0.92倍 |
今回は生成速度がベンチ値に近く、プロンプト処理は約5分の1でした。
ただし差の原因までは切り分けられていません。プロンプト長が違いますし(ベンチは512トークン、実際は130トークン程度)、llama-benchにはバッチサイズや物理バッチサイズなど別の設定もあります。pp512 という名前だけで常に単一バッチとは限りません。言えるのは「ベンチ値をそのまま対話時の速度と見なすことはできない」ところまでです。
さらに -c を伸ばすとKVキャッシュぶんVRAMを食うので、ベンチで最速だった層数が、実運用のコンテキスト長では崖の向こう側に移動します。
-ngl を決めるときの手順としては、こうなります。
- llama-benchで当たりをつける(速いが、実運用の値ではない)
- 実際に使う
-cの値でllama-serverを起動して、動くことを確かめる - 動かなければ
-nglを下げる
2番を飛ばすと、私のように610秒待つことになります。
罠3:PowerShellが206文字を46MBに膨らませていた
罠1と罠2を潰しても、まだエラーが出ました。
(413) Payload Too Largeプロンプトは206文字です。何がPayload Too Largeなのか分かりませんでした。
切り分け
curl.exe で生のレスポンスボディを取ったら、一発で分かりました。
{"error":{"code":400,"message":"Expected 'content' to be a string or an array","type":"invalid_request_error"}}content が文字列として認識されていません。送っているJSONを保存して、サイズを見ます。
46,778,343 bytes46MBでした。 413 Payload Too Large は、文字どおり正しかったわけです。
原因
PowerShellの Get-Content -Raw が返す文字列には、PowerShellが付ける NoteProperty がぶら下がっています。
PSPathPSParentPathPSChildNamePSDrivePSProviderReadCount
ConvertTo-Json はこれを再帰的に展開します。PSDrive と PSProvider はオブジェクトなので、そこからさらに展開が続きます。結果、content は文字列ではなくこんな形になります。
{"messages":[{"content":{
  "value":"あなたは旅行プランを考えるアシスタントです。...",
  "PSPath":"C:\\[フォルダ名]\\prompts\\task1.txt",
  "PSParentPath":"C:\\[フォルダ名]\\prompts",
  ...(以下46MB)
}}]}
修正
# NG: NoteProperty が付いてくる
$prompt = Get-Content -Path $file -Raw -Encoding UTF8

# OK: クリーンな .NET string(BOMも除去される)
$prompt = [System.IO.File]::ReadAllText($file, [System.Text.Encoding]::UTF8)これはllama.cpp固有の話ではありません。ただしWindows PowerShell 5.1 固有です。Microsoft公式によると PowerShell 7.2以降では String と DateTime のETSプロパティがJSON化されなくなりました。手元の PowerShell 7.4.6 で確かめたところ、Get-Content -Raw にNotePropertyは付いたままですが、ConvertTo-Json の出力は ReadAllText と完全に同一の文字列になりました。
つまり刺さるのは 5.1で書かれた既存スクリプトです。心当たりがあれば、一度 ConvertTo-Json の出力サイズを確認してみてください。
動くようになって分かったこと
3つ潰して、ようやく実際のタスクを流せました。構成は llama-server -ngl 32 -c 2048 --parallel 1、モデルは Qwen3.8-27B Q4_K_M(16.54 GiB)、GPUは RTX 4070 12GB です。
| タスク | prompt | 出力 | 所要 | プロンプト処理 | 生成 |
|---|---|---|---|---|---|
| 日本語生成(旅行プラン) | 132 | 367 | 180.2秒 | 58.57 tok/s | 2.06 tok/s |
| 要約(300字以内) | 134 | 78 | 39.5秒 | 62.56 tok/s | 2.06 tok/s |
| コード相談(バグ修正) | 135 | 228 | 111.6秒 | 62.40 tok/s | 2.08 tok/s |
実行中のGPUは VRAM ピーク 9,362 MiB(76.2%)、使用率平均30.2%。前回の記事で「正常域は21〜29%」と書いた範囲とほぼ一致します。崩壊域の98%とは、はっきり別の状態です。
出力の質
コード相談は完全に正答しました。 id="countButton" と getElementById("button") の不一致を正しく指摘し、修正版コードも正しく、「大文字・小文字も区別される」という補足まで付けています。
要約も問題なし。 原文に忠実で、勝手な情報の追加もありません。ただし「重要な点を3つに整理する」という指示に対して、箇条書きではなく地の文になりました(3点は含まれています)。指示追従はやや弱めです。
日本語生成は、文章としては自然でしたが固有名詞が信用できませんでした。 1泊2日の旅行プランを頼んだところ、構成(1日目/2日目の分割、雨天の代替案2つ、字数)はきちんと守られています。ただし中身に、
- 「新幹線で松本まで行き」→ 松本に新幹線は通っていません
- 「信州高森町民家博物館」→ 実在が確認できない施設名
- 「『上高地』ではなく『白馬五竜スキー場』周辺ではなく」→ 二重否定で崩れている
といった問題が出ました。3つ目は presence-penalty 1.5 を高く設定しすぎたせいかもしれません(未検証です)。
まとめると、今回のコード相談(ID不一致の修正)と要約は、私の用途では 2 tok/s でも十分使えました。自由生成は日本語としては自然ですが、固有名詞をそのまま信じてはいけません。 3問だけの結果なので、タスク一般に広げられる話ではありません。そして 2 tok/s は、チャット用途としてはやはり遅いです。
同じところで止まったときの切り分け手順
順番に効きます。上から試してください。
- セキュリティソフトの検出履歴を見る。 起動時刻の前後1分を確認します。Nortonなら「セキュリティ履歴」。検出されていたら、まず定義更新と誤検出報告を検討し、除外するなら対象を必要最小限に絞る
-nglを大きく下げて起動する(例:-ngl 0)。 これで起動するなら層数の問題。上げながら限界を探る-cを下げる(例:-c 512)。 これで起動するならコンテキスト長の問題。KVキャッシュがVRAMを食っているcurl.exeで生のレスポンスボディを取る。 PowerShellのInvoke-RestMethodはHTTPステータスしか見せないことがあります。ヘルスチェックならこうです。
curl.exe -sS --connect-timeout 3 --max-time 10 -o health.json -w "http=%{http_code}\n" http://127.0.0.1:8080/health
http=000はサーバが返したステータスではなく、ステータスを取得できなかったという意味です。終了コード($LASTEXITCODE)も併せて記録してください。--max-timeは1回のリクエストの上限であって、モデル読み込み全体の失敗判定ではありません。413やcontentの型エラーを見るときは、実際のPOST先・ヘッダー・送信JSONを指定した別のコマンドが要ります- 送信しているJSONをファイルに保存してサイズを見る。 想定と桁が違うなら、シリアライズの問題
私は1と4に気づくのに2日かかりました。
この記事で断定していないこと
- Norton 360 での事例です。他のセキュリティソフトで同じことが起きるかは検証していません
- 17分37秒の無応答について、除外の有無だけを変えた同一条件の比較はしていません(ログの停止位置を根拠にしています)
- PowerShellの件は Windows PowerShell 5.1 での事例です。7.2以降では解消されています
- 46MBは当時の記録です。
-DepthやJSON構造で変わるため、誰でも必ず46MBになるわけではありません -ngl 42がサーバで動く-cの上限は測っていません(8192で不可、2048は-ngl 32で確認)presence-penalty 1.5が出力品質に与える影響は未検証です(下げて測り直していません)- 定性評価は各タスク1回のみ、temperature 0.7 のため再現性は取っていません
- RTX 4070 12GB + RAM 32GB という1環境での話です
速度に不満が出たら
今回の実測は RTX 4070 12GB です。Q4_K_Mの27Bモデルで 2 tok/s、実用にはなりますが対話には遅いという結論でした。なお -ngl 32 は「サーバで応答を確認できた設定」として採用した値で、載せられる層数の上限ではありません(llama-benchでは40層・42層でも動いています)。サーバで安定して使える層数の上限は測っていません。
以下は価格確認用のリンクです(広告)。
- 今回実測した機材です → 楽天市場でRTX 4070の価格を見る

- 未実測ですが、VRAM 16GBあれば載せられる層数が増えます → 楽天市場でRTX 4060 Ti 16GBの価格を見る
RTX 4060 Ti 16GB は私は測っていません。VRAMは増えますがメモリ帯域は RTX 4070 より狭いので、生成速度が素直に上がるとは限りません。買う前にご自身の用途でベンチを探すことをおすすめします。
まとめ
- ローカルLLMが無反応なら、まずセキュリティソフトの検出履歴を見る。 エラーもログも出ないので、他を疑っていると何日も溶けます
- llama-benchの最速設定は、そのままサーバに移植できません。 生成速度は移りますが、プロンプト処理は5分の1、コンテキストを伸ばすと起動すらしなくなります
- PowerShellの
Get-Content -RawをConvertTo-Jsonに渡さない。[System.IO.File]::ReadAllText()を使う - RTX 4070 12GB + Qwen3.8-27B Q4_K_M は 2 tok/s。今回試した3問では、コード相談と要約は用途を満たし、自由生成は固有名詞が怪しい
層数(-ngl)そのものの実測データは前回の記事にまとめています。
→ Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった
コメント