RTX 4070

ローカルLLM実装

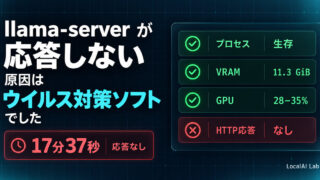
llama-serverが応答しない原因はウイルス対策ソフトでした|ローカルLLMで踏んだ3つの罠

llama-serverが起動しても応答を返さない。プロセスは生きていてVRAMも確保済み、GPUも回っているのにHTTPだけ返らない。手掛かりはウイルス対策ソフトの検出履歴でした。切り分け手順と、あわせて踏んだ2つの罠を実測値つきで公開します。
ローカルLLM実装
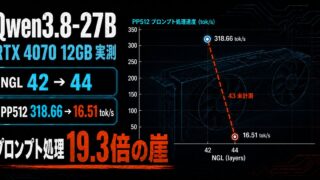
Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった

Qwen3.8-27B Q4_K_MをRTX 4070 12GBで実測。GPUに載せる層数を42から44に増やすだけでプロンプト処理が19分の1に崩落しました。llama-benchの生データと、別の27Bモデルでの再現結果を公開します。
ローカルLLM実装

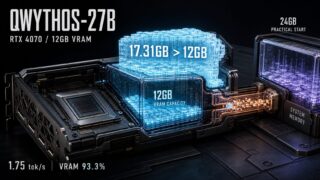
Qwythos-27BをRTX 4070 12GBで実測|1.7 tok/s、VRAM 93.3%、24GBが要る理由

Qwythos-27B-v1 Q4_K_M(実体17.31GB)をRTX 4070 12GBで実測。VRAM最大93.3%、生成1.7 token/s。全層GPU環境との比較から、量子化の選択よりVRAMに収まるかが支配的だと分かりました。
ローカルLLM実装

Qwythos-9B v2でブラウザゲーム生成は改善した?v1 Q5/Q6/Q8・Claude Opus 4.8と比較

Qwythos-9Bの旧版Q5/Q6/Q8と新しいv2 Q8_0をRTX 4070で検証。同じ2Dシューティングを生成し、速度、VRAM、実ブラウザ動作、修正後の完成度をClaude Opus 4.8の参照結果とともにまとめます。
ローカルLLM実装

Gemma 4をRTX 4070(12GB)で実測|12B・E4B・Qwen3 14B・Phi-4-mini・26Bを同じ試験でクラウドと比べた

RTX 4070(12GB)でGemma 4・E4B・Qwen3 14B・Phi-4-mini・26Bの5モデルをOllamaで実測。クラウドのOpus 4.8と同一テストで採点し、12GB級はコード15/15で同点。速度・VRAM・画像認識の差を実数値で比較した。