VRAMが少なめのGPUで、9BクラスのローカルLLMはどこまで動かせるのか。
※本記事にはアフィリエイトリンク(広告)が含まれます。
今回は、Qwythos-9B-Claude-Mythos-5-1M-GGUF を手元のVRAM 6GB環境で試してみました。
このモデルは、Q4_K_Mなら4GB台のVRAM使用量で動く可能性がありそうだと感じていたモデルです。ただし、今回使った実機はVRAM 6GB環境です。この記事では「4GB実機で確実に動く」とは断定せず、6GB環境で実際にどれくらいVRAMを使ったかを中心に見ます。
先に結論を書くと、Q4_K_MとQ5_K_Mは6GB環境でもかなり現実的でした。Q6_Kも起動と短いコード相談はできましたが、速度面では重さが目立ちます。
この記事では、Q4_K_Mを本命、Q5_K_Mを比較候補、Q6_Kを限界確認として扱います。
この記事の測定結果 llama-server のブラウザUIに表示された速度です。タスクは構成ごとに違います。
Qwythos-9B Q4_K_M 約5.63GB
5.59 tok/s
ブラウザUI・コード相談
-ngl 8(一部だけGPU)
Qwythos-9B Q5_K_M 約6.47GB
5.93 tok/s
ブラウザUI・旅行プラン
-ngl 8(一部だけGPU)
Qwythos-9B Q6_K 約7.36GB
2.98 tok/s
ブラウザUI・コード相談
-ngl 8(一部だけGPU)
Q4_K_MとQ5_K_Mは6GB環境でもかなり現実的でした。
- GPU
- VRAM 6GB の GPU(6144MiB)
- 実行環境
- llama.cpp / llama-server.exe(ブラウザUI)
Qwythos-9B-Claude-Mythosとは
Qwythos-9B-Claude-Mythosは、Empero AIが公開している9BクラスのローカルLLMです。
公式モデルカードでは、Qwen3.5-9B系をベースにしたGGUFモデルとして紹介されています。名前にClaudeと入っていますが、Claudeそのものではありません。Claude Mythos / Claude Fable系の出力傾向を意識して後学習された別モデルとして見るのが自然です。
公式モデルカードはこちらです。


今回試した通常版のファイルは次の3つです。
| 種類 | ファイルサイズ | 今回の扱い |
|---|---|---|
| Q4_K_M | 約5.63GB | 本命 |
| Q5_K_M | 約6.47GB | 上位量子化の比較 |
| Q6_K | 約7.36GB | 限界確認 |
公式モデルカードでは、Q4_K_Mが最初に選びやすい量子化として紹介されています。今回はそこから始め、少し重いQ5_K_M、さらに重いQ6_Kまで順番に見ました。
同じリポジトリにはMTP版もあります。MTP版は、通常版より賢い上位モデルというより、対応したllama.cppで生成速度を上げるための別枠です。この記事では通常版のQ4/Q5/Q6に絞ります。
出自の整理(2026年10月7日に元モデルのモデルカードを確認)
| 項目 | 内容 |
|---|---|
| 元のモデル | Qwen/Qwen3.5-9B(モデルカードの記載) |
| ライセンス | Apache 2.0(モデルカードの記載) |
| 名前の「Claude」 | Anthropic公式のモデルではありません。モデルカードに、Anthropicとの関係についての記載はありません |
| 学習データ | Claude Mythos・Claude Fableの対話記録を使ったと作者が説明しています(当サイトでは確認していません) |
| 性能向上の主張 | 元のモデルからMMLUが0.232→0.575(+34.3ポイント)と作者が説明しています(当サイトでは未検証) |
本記事は、このモデルがVRAM 6GBでどう動くかを測った記録で、利用を勧めるものではありません。仕事などで使う場合は、ライセンスに加えて学習データの出自も確認してください。
検証した環境
今回の環境は次の通りです。
GPU: VRAM 6GB の GPU
実行: llama.cpp / llama-server.exe
UI: ブラウザUI
OS: Windows
GPU offload: -ngl 8
URL: http://127.0.0.1:8080/
コンテキスト長は、短い文章作成やコード相談では主に -c 4096 から確認し、1ファイルHTMLゲームのように出力が長くなるタスクでは -c 8192 に広げました。
また、Qwythosはreasoning modelとして紹介されていますが、今回はVRAM 6GB環境での速度とVRAMを優先し、--reasoning off で確認しています。reasoningを有効にした場合の品質や速度は、この記事では未検証です。
速度やVRAMは、主にブラウザUIに表示された tokens / 秒 / t/s と、nvidia-smiの画面キャプチャーを見て記録しました。厳密なベンチマークというより、実際に手元で使ったときの体感に近い検証です。

llama.cppのブラウザUIで起動する
今回はCLIだけではなく、llama.cppのブラウザUIを使いました。
llama-server.exe を起動すると、ブラウザ上のローカル画面から、クラウドAIのような感覚でモデルに入力できます。
実行コマンドは、だいたい次の形です。
.\runtime\llama-server.exe `
  -m ".\models\Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf" `
  -c 4096 `
  -ngl 8 `
  --temp 0.6 `
  --top-p 0.95 `
  --top-k 20 `
  --repeat-penalty 1.05 `
  --reasoning off `
  --host 127.0.0.1 `
  --port 8080 `
--no-warmup長いHTMLやコードを作らせる場合は、-c 4096 では足りないことがありました。その場合は -c 8192 に広げて再実行しています。
主なパラメータの意味は次の通りです。
| パラメータ | 意味 | 今回の扱い |
|---|---|---|
-m |
使用するGGUFモデル | Q4_K_M / Q5_K_M / Q6_K |
-c |
コンテキスト長 | 通常は4096、長いHTML生成では8192 |
-ngl |
GPUに載せるレイヤー数 | 8 |
--reasoning off |
reasoning出力を切る | 今回は速度とVRAM優先でoff |
--temp / --top-p / --top-k |
サンプリング設定 | 公式モデルカードの推奨値に合わせた |
--host / --port |
ブラウザUIの待ち受け先 | 127.0.0.1:8080 |
毎回コマンドを打つのは面倒なので、サーバー起動用のbatファイルを1つ用意しておくと楽です。下のコードをメモ帳に貼り付け、ファイルの種類を「すべてのファイル」にして start_qwythos_browser_ui.bat という名前で保存します(拡張子が .txt にならないよう注意)。作業用フォルダの直下に置き、同じフォルダ内に runtime(llama.cpp一式)と models(GGUFモデル)を用意します。
@echo off
setlocal
pushd "%~dp0"

rem ---- Edit here if needed ----
rem If long output gets cut off, change CTX to 8192.
set MODEL=models\Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf
set CTX=4096
set GPU_LAYERS=8
set PORT=8080
rem ----------------------------

if not exist "runtime\llama-server.exe" (
  echo [NG] runtime\llama-server.exe not found.
  echo Put llama.cpp files in the runtime folder.
  pause
  exit /b 1
)

if not exist "%MODEL%" (
  echo [NG] %MODEL% not found.
  echo Put the GGUF model file in the models folder.
  pause
  exit /b 1
)

echo Starting Qwythos browser UI...
echo Model: %MODEL%
echo Context: %CTX%
echo GPU layers: %GPU_LAYERS%
echo URL: http://127.0.0.1:%PORT%/
echo.

runtime\llama-server.exe ^
  -m "%MODEL%" ^
  -c %CTX% ^
  -ngl %GPU_LAYERS% ^
  --temp 0.6 ^
  --top-p 0.95 ^
  --top-k 20 ^
  --repeat-penalty 1.05 ^
  --reasoning off ^
  --host 127.0.0.1 ^
  --port %PORT% ^
  --no-warmup

echo.
echo llama-server stopped.
pause
モデルを Q5_K_M や Q6_K に変えたいときは、set MODEL= の行を書き換えます。長い出力が途中で切れる場合は、set CTX= を 8192 に上げて再実行します。batをダブルクリックすると、モデルとllama.cppの有無を確認してからサーバーが起動するので、ブラウザで http://127.0.0.1:8080/ を開きます。
ブラウザUIは便利ですが、サーバーを止めるまでモデルはVRAMに載ったままになります。回答が終わってもVRAM使用量がすぐ下がらないのは自然な挙動です。
Q4_K_Mは本当に使えるか
まずは推奨スタートのQ4_K_Mから試しました。
結果として、VRAM 6GB環境でもブラウザUIで起動できました。VRAMはおおむね3.9GBから4.2GB前後です。
日本語文章作成
旅行プランを作るタスクを投げました。
出力: 272 tokens
時間: 45s
速度: 5.96 t/s
VRAM: 約3920〜3971MiB
文章は自然です。1日目、2日目、雨の場合の代替案という構成も作れています。
ただし、旅行プランとして見ると、移動経路や観光地の組み合わせには怪しい箇所がありました。文章の形を作る用途には使えますが、地理や施設情報は人間側の確認が必要です。

要約
要約タスクも試しました。
出力: 74 tokens
時間: 10s
速度: 7.06 t/s
VRAM: 約3973〜4061MiB
内容の取り違えは少なく、勝手な情報追加も目立ちませんでした。
一方で、「重要な点を3つに整理する」という形式指定は少し甘く、明確な3点リストにはなっていませんでした。実務で使うなら、出力形式をもう少し強く指定したほうがよさそうです。

コード相談
HTML/JavaScriptの短いバグ相談も試しました。
出力: 141 tokens
時間: 25s
速度: 5.59 t/s
VRAM: 約4058〜4137MiB
内容は、ボタンを押してもカウントが増えない原因を探すものです。
Q4_K_Mは、id="countButton" と getElementById("button") の不一致を正しく特定し、修正版コードも出せました。
短いHTML/JavaScriptの相談なら、Q4_K_Mでも十分使える印象です。

Claude Mythos系らしさはあるか
このモデル名で気になるのは、やはり「Claude Mythos系らしさ」があるのかです。
Q4_K_Mで、個人ブログの冒頭案を相談するタスクも試しました。
出力: 656 tokens
時間: 1min 31s
速度: 7.18 t/s
VRAM: 約4285〜4378MiB
結果として、文章のトーンはかなり丁寧でした。押しつけが強すぎず、いくつかの導入案を出して、最後におすすめ案をまとめる流れも自然です。
ただし、冒頭に「こんにちは、Qwythosです」「作成者はEmpero AIです」という自己紹介が入りました。これはブログ本文にそのまま使うには不要です。Claude本体のような自然な控えめさというより、モデルカード由来の自己紹介癖が少し出た印象です。
つまり、作業パートナー感や丁寧さはあります。ただし、出力をそのまま貼るというより、不要な自己言及を削って使う前提がよさそうです。

Q5_K_MはQ4より良いのか
次に、Q5_K_Mも試しました。
Q5_K_MはQ4_K_Mよりファイルサイズが大きいですが、今回の設定ではVRAM 6GB環境でもブラウザUI起動できました。
起動後VRAM: 約4432〜4583MiB / 6144MiBQ4よりVRAM使用量は増えますが、今回の条件では6GB内に収まっています。
日本語文章作成
Q5_K_Mでも、Q4と同じ旅行プラン作成を試しました。
出力: 227 tokens
時間: 38s
速度: 5.93 t/s
このテスト単体のVRAMキャプチャーは取り損ねましたが、同じQ5_K_M条件の起動確認・別タスクでは4.3〜4.6GB前後でした。
文章は自然で、Q4より少し短くまとまっています。条件指定もおおむね守れています。
ただし、観光地や移動経路には確認が必要です。Q5_K_Mでも、文章の形を作る用途には使えますが、地理や施設情報をそのまま信じる用途には向きません。

Q6_Kも起動するが、6GBでは重い
Q6_Kも試しました。
Q6_KのGGUFファイルサイズは約7.36GBです。ファイルサイズだけ見ると6GB VRAMに入りませんが、今回は -ngl 8 で一部だけGPUに載せる形にしました。
その結果、VRAM 6GB環境でもブラウザUI起動できました。
ブラウザUI起動: 成功
モデル表示: Q6_K.gguf
VRAM: 起動前 約2130〜2181MiB → 起動後 約4140〜4396MiB / 6144MiB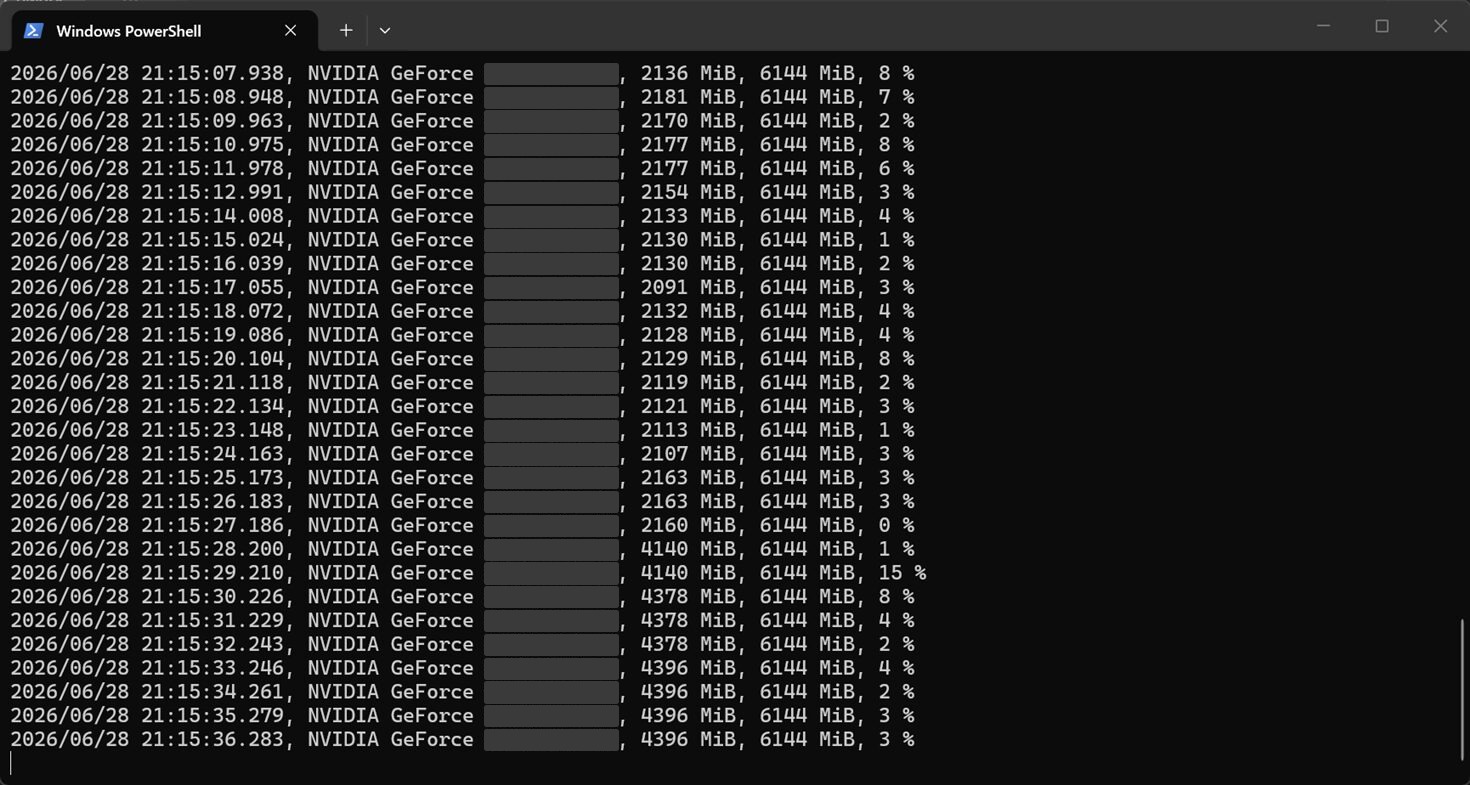
短いコード相談も試しました。
出力: 190 tokens
時間: 1min 3s
速度: 2.98 t/s
VRAM: 約4394〜4499MiB / 6144MiB
回答内容は正解でした。
Q4と同じく、countButton と button のID不一致を正しく見つけ、修正版コードも出せています。
ただし、速度はかなり重くなります。Q4_K_Mの同じコード相談タスクが 5.59 t/s だったのに対し、Q6_Kは 2.98 t/s でした。
Q6_Kも動きますが、VRAM 6GB の GPU で普段使いするなら、Q4_K_MかQ5_K_Mのほうが現実的です。

VRAM Fit Puzzleを作らせてみる
実用タスクとは少し別に、簡単なHTMLゲームも作らせました。
作らせたのは、GPUとモデルと量子化を選んで、VRAMに収まるかを判定する「VRAM Fit Puzzle」です。
1回目はctx 4096で失敗
最初は ctx 4096 で試しました。
HTMLは保存できましたが、画面にはタイトルやステータスバーだけが表示され、肝心のカード類が出ませんでした。

原因を確認すると、JavaScriptが途中で切れていました。サーバー側にも次のエラーが出ていました。
request (4179 tokens) exceeds the available context size (4096 tokens)長めの1ファイルHTMLを作らせるには、ctx 4096では足りなかったようです。
ctx 8192で動くところまで生成
次に ctx 8192 に広げて再実行しました。
この場合は、1ファイルHTMLゲームとして動くところまで生成できました。

数値はゲーム用の仮値ですが、GPUカード、モデルカード、クリック操作、成功判定までは表示されています。単なる文章生成だけでなく、1ファイルHTMLの小さなゲームを形にできるのは見どころです。
Q5_K_Mでは、さらに量子化を選ぶUIに近づきました。
出力: 2791 tokens
時間: 7min 38s
速度: 6.09 t/s
VRAM: 約4339〜4487MiB
この検証で分かったのは、長めのHTML/JavaScript生成ではモデルの能力だけでなく、ctx設定もかなり効くということです。
画像入力や動画入力は今回の対象外
Qwythosの公式モデルカードには、画像入力に使う mmproj についての説明もあります。
ただし、今回の検証はテキストモデルをllama.cppのブラウザUIで動かすところに絞りました。画像解析や動画解析は扱っていません。
画像入力を使う場合は、テキスト用のGGUFだけでなく、対応する mmproj ファイルやマルチモーダル対応の起動方法が必要です。動画についても、そのまま動画ファイルを渡すというより、フレーム抽出など別処理が必要になります。
Q4/Q5/Q6の比較まとめ
今回の結果をまとめると、次のようになります。
全タスクを3量子化で完全に横並びにしたわけではありません。今回は、Q4_K_Mを主役に、Q5_K_MとQ6_Kで「VRAM 6GB環境でもどこまで行けるか」を確認する形です。
| 項目 | Q4_K_M | Q5_K_M | Q6_K |
|---|---|---|---|
| GGUFサイズ | 約5.63GB | 約6.47GB | 約7.36GB |
| ブラウザUI起動 | 成功 | 成功 | 成功 |
| VRAM目安 | 約3.9〜4.3GB | 約4.3〜4.6GB | 約4.1〜4.5GB |
| 日本語文章 | 自然、要確認 | 自然、短め | 未実施 |
| 要約 | 使えるが形式指定は甘い | 未実施 | 未実施 |
| コード相談 | 正解、5.59 t/s | 未実施 | 正解、2.98 t/s |
| Claude Mythosらしさ | 丁寧だが自己紹介癖あり | 未実施 | 未実施 |
| ゲーム制作 | ctx 8192で動作 | Q4より仕様に近い | 未実施 |
| 6GBでの扱い | 本命 | 比較候補 | 限界確認 |
Q4_K_Mは、VRAM 6GB環境での本命として扱いやすいです。
Q5_K_MもVRAM内に収まり、今回のゲーム制作タスクではQ4より仕様に近い出力になりました。
Q6_Kも起動し、短いコード相談はできます。ただし速度はかなり重く、6GB環境では常用候補というより限界確認に近いです。
この結果から言えること:6GBで足りるか、買い足すか
Q4_K_Mで日本語の相談やコード相談を試すだけなら、VRAM 6GBのままで足ります(VRAM約3.9〜4.3GB、コード相談で5.59 tok/s)。買い足しを考えるのは、Q6_K以上の量子化や長いコンテキストを日常的に使いたくなったときです。
今回の検証では、Q4_K_M / Q5_K_Mは実用的に動いた一方、Q6_Kは6GBでは重いという結果でした。より大きい量子化や長いコンテキストを日常的に使うなら、VRAMの増設が一番効きます。
実測を踏まえた現実的な選択肢は次の2つです。
- VRAM 12GB(RTX 4070クラス):本記事の追加検証で実際に使った構成。9Bクラスなら全量子化が全層GPUに載り、生成を何度も試せます。
【PR】楽天市場でRTX 4070の価格を見る
- VRAM 16GB(RTX 4060 Ti 16GB):価格あたりのVRAM量を優先する選択肢。生成速度より「載るかどうか」を重視するローカルLLM用途と相性が良い構成です(本サイトでは未実測)。
【PR】楽天市場でRTX 4060 Ti 16GBの価格を見る
PCごと買い替えるなら、中古ゲーミングPCでVRAM 12GB以上のGPU搭載機を探す方法もあります。
【PR】GP-ZEROで中古ゲーミングPCを見る
追加検証:32K contextで長文を読ませる
このあと、Q4_K_Mを使って8K / 16K / 32K context設定の追加検証も行いました。長文入力を読ませたときのprefill速度、生成速度、VRAM使用量、合言葉取得を確認しています。
Qwythos-9Bは32K contextで読める?VRAM 6GB環境で8K/16K/32K prefillを追加検証
追加検証:RTX 4070でv2と旧版Q5/Q6/Q8を比較
RTX 4070 12GB環境では、旧版Q5/Q6/Q8に加えてQwythos-9B v2も検証しました。同じ2Dシューティングを生成し、速度、VRAM、実際のブラウザ動作、修正後の完成度を比較しています。
Qwythos-9B v2をRTX 4070で追加検証した記事
MTP版について
同じリポジトリには、MTP 付きのGGUFもあります。
MTP版は、通常版より賢い上位モデルというより、対応したllama.cppで生成速度を上げるための追加機能付きモデルです。使うには、MTPに対応した新しめのllama.cppと、--spec-type draft-mtp のような指定が必要になります。
今回は通常版の Q4_K_M、Q5_K_M、Q6_K を見たため、MTP版は別記事または追試候補にします。
まとめ
Qwythos-9Bは、VRAM 6GB環境でも動きました。
Q4_K_Mは本命として扱いやすく、Q5_K_Mも6GB内に収まりました。Q6_Kも起動と短いコード相談まではできますが、速度面では重さが目立ちます。
6GB実機でのVRAM使用量は、Q4_K_Mでおおむね4GB前後でした。4GB実機での確実な動作は今回未確認ですが、少ないVRAMで9Bクラスを動かす話としてはかなり現実味があります。
日本語文章、要約、コード相談、簡単なHTMLゲーム制作まで試した感触では、ローカルの作業相手として面白いモデルです。一方で、地理や施設情報のような事実確認が必要な内容は、そのまま信用しないほうがよさそうです。
また、今回はreasoningを切って測定しています。公式モデルカードが想定しているようなreasoningありの使い方、長文推論、画像入力、MTP版は別途確認が必要です。
VRAM 6GB環境で現実的に使うなら、まずはQ4_K_Mから始めるのがよさそうです。少し品質を見たい場合はQ5_K_M、Q6_Kは「動くかどうか試す」くらいの位置づけがちょうどいいと感じました。
次は、MTP版や別GPU環境でどこまで速度が変わるかも試してみたいところです。