【PR】この記事にはアフィリエイトリンクを含みます。実測に使った機材と、実測していない機材は、リンクごとに区別して記載しています。
結論
OpenBMB の小型モデル MiniCPM5-2B を、VRAM 6GB の GPU を積んだPCで動かした実測結果です。公式の GGUF(Q4_K_M と Q8_0)を、ひとつ小さい MiniCPM5-1B と同じPC・同じ条件で比べました。実行環境は llama.cpp と Ollama の2つです。
- このPCの文脈設定4096・思考オフでは、全層を GPU に載せて余裕がありました。画面表示などで最初から約1.8 GiB 使われている状態から、2B の Q4_K_M で約1.6 GiB、Q8_0 で約2.5 GiB 増えただけです
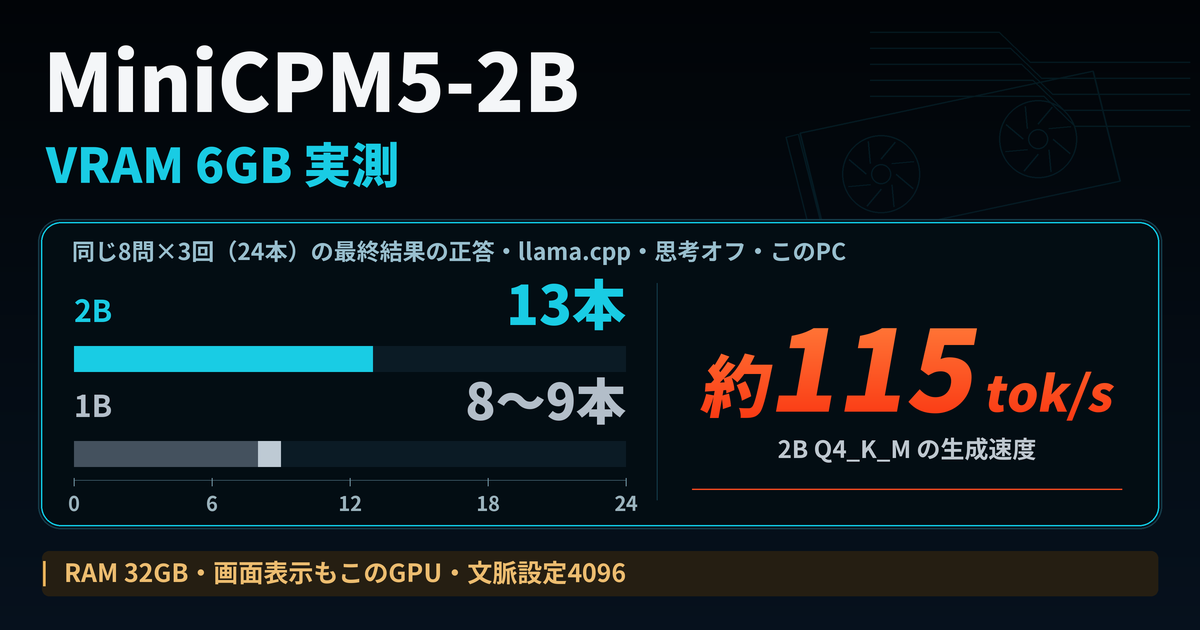
- 速さは、2B の Q4_K_M で約115 tok/s、Q8_0 で約81 tok/s(llama.cpp の生成の中央値)。1B はその約2倍(Q4_K_M で約228 tok/s)でした。Ollama でも観測した速さはほぼ同じです
- 同じ8問を3回ずつ(24本)解かせると、最終結果が正しかったのは 2B が 13本、1B が 8〜9本でした(llama.cpp・思考オフ)。出力の形式や説明まで含めて指定条件を満たしたのは、2B が 7本、1B が 0〜2本です
- 思考オンに加え、文脈設定を4096から8192、出力上限を1024から4096トークンに増やした条件では、q5〜q8(計算・推論・Python・JavaScript)の4問×3回で、Q4_K_M・Q8_0 とも最終結果が12/12正答でした。思考オフは各7/12です。答えまでの中央値は約6〜7秒で、思考だけの効果を分けた比較ではありません
- 思考オフの 2B は、計算問題(q5)と注文の合計金額(q4)を、Q4_K_M・Q8_0 を合わせて各6本、計12本すべて間違えました。要約(q2)でも、利用条件などを落としました
このPCと今回の条件では、VRAM 6GB でも MiniCPM5-2B は速く動き、今回の8問では 1B より正答が増えました。
MiniCPM5-2Bとは
OpenBMB が2026年9月に公開した、端末上で動かすことを狙った小型の言語モデルです(公式の GGUF のモデルカード)。MiniCPM5 シリーズの2つ目で、1つ目は1B です。ライセンスは Apache 2.0、文脈長は 131,072 トークン。答える前に考える「思考」をオン・オフできます。
当サイトでは7月に、ひとつ小さい MiniCPM5-1B を RTX 4070 のPCと Ollama で検証しました(MiniCPM5-1Bを本格検証)。今回はその続きとして、2B で何が変わるかを、6GB のPCで確かめました。課題・PC・実行環境が違うので、7月の記事の数字とは並べず、今回同じPC・同じ条件で測り直した 1Bと比べています。
| モデル | Q4_K_M | Q8_0 |
|---|---|---|
| MiniCPM5-2B | 1,561,318,368 bytes(1.45 GiB) | 2,679,710,688 bytes(2.50 GiB) |
| MiniCPM5-1B | 688,065,920 bytes(0.64 GiB) | 1,153,529,216 bytes(1.07 GiB) |
4つとも公式の GGUF で、SHA256 を照合しました。Ollama には同じファイルを ollama pull hf.co/openbmb/MiniCPM5-2B-GGUF:Q4_K_M の形で取り込み、中身が同じことも確かめています。
検証環境と条件
| 項目 | 内容 |
|---|---|
| GPU | VRAM 6GB の GPU(6,144 MiB)。画面表示もこのGPU。ドライバ 610.88 |
| CPU・RAM | 4コア8スレッド、32GB(DDR4-3200) |
| OS | Windows 11 Pro |
| 実行環境 | llama.cpp b11574(通常版)と Ollama 0.40.6 |
| 測定日 | 2026年10月20日(夜間) |
- llama.cpp は llama-server で、全層を GPU に(
-ngl 99。2B は 43/43 単位が GPU に載ったことをログで確認)、文脈設定4096、flash attention 有効、同時1件、プロンプトのキャッシュなし - サンプリングは temperature 0.2、top_p 0.95、top_k 40、min_p 0.0、repeat_penalty 1.0。シードは 11・23・37 の3つで、各課題を3回ずつ。出力の上限は1024トークン
- temperature 0.2 は、7月の 1B の記事に合わせた比較の条件です。モデルカードの推奨(temperature 1.0、top_p 0.95、min_p 0.0)とは違います。min_p を 0.0 にしたのは、モデルカードが「llama.cpp の既定の min_p=0.05 は繰り返しの出力につながることがある」と注意しているためです
- 思考は、llama.cpp ではリクエストの
"chat_template_kwargs": {"enable_thinking": false}で切りました(後半の「思考オン」の条件だけ true)。送る前に、テンプレートを展開したプロンプトで思考オフの形になっていることを確かめています - Ollama は、配信のままのテンプレートで
"think": falseを付けて送りました。応答に思考の欄は出ませんでした - ブラウザなど GPU を使うアプリは閉じ、ウイルス対策ソフト(Norton)は保護を有効にしたまま測りました
用語を先に整理します。
- tok/s:1秒あたりに生成するトークン数。トークンはモデルが文章を扱う単位で、1文字とは限りません
- 最終結果の正答:今回の採点基準で、抽出値・要約の要点・答えなどが合っているもの。コード課題は、用意したテストの全件合格で判断します。q5・q6 の計算や推論の説明、q8 の原因説明の正しさは、この数には含めません
- 指定条件まで合格:最終結果が正しく、出力形式に加えて、課題で求めた説明の内容も基準を満たすもの(最終結果の正答の一部)。文章の意味は検証時のレビュー評価で判定し、コードは実行テストで確認しました
- 答えまでの秒数:リクエストを送ってから応答が全部返るまでの時間。モデルの読み込みと2回の短い暖機のあとに測りました
速度とVRAM
次の2つの表の生成速度(llama.cpp、Ollama、llama-bench tg128)の単位は tok/s です。
| 構成 | llama.cpp 生成 | Ollama 生成 |
|---|---|---|
| 2B Q4_K_M | 114.59(110.30〜115.65) | 116.67(86.17〜130.37) |
| 2B Q8_0 | 81.20(80.21〜81.73) | 82.84(80.99〜89.85) |
| 1B Q4_K_M | 227.53(216.53〜229.99) | 232.48(228.28〜237.25) |
| 1B Q8_0 | 165.69(163.79〜167.17) | 169.14(163.24〜172.15) |
| 構成 | llama-bench tg128 | VRAM 最大(増えた分) |
|---|---|---|
| 2B Q4_K_M | 117.14 | 3,459 MiB(+1,655) |
| 2B Q8_0 | 82.22 | 4,395 MiB(+2,591) |
| 1B Q4_K_M | 240.84 | 2,571 MiB(+767) |
| 1B Q8_0 | 172.41 | 2,917 MiB(+1,113) |
llama.cpp と Ollama の生成速度は、正常終了した8問×3回の中央値で、かっこ内は最小〜最大です。llama.cpp は API の報告値、Ollama は生成トークン数÷生成時間を使いました。llama-bench の tg128 は、128トークンを生成する別の測定の5回平均です。Ollama はテンプレートやキャッシュの扱いも異なるため、ここでは今回観測した速度を並べています。VRAM は、llama.cpp で8問×3回を解いている間に、2秒おきに観測した GPU 全体の使用量の最大値で、かっこ内は直前に何も動かしていないときの使用量(1,804 MiB)との差です。
- 2B の Q4_K_M でも Q8_0 でも、文脈設定4096では 6GB に全部載って余裕がありました。Q8_0 でも GPU 全体の最大は約4.3 GiB でした。Ollama の
ollama psも、4つとも「100% GPU」と表示しています - Q8_0 は Q4_K_M より約3割遅く、1B は 2B の約2倍の速さでした
- llama.cpp と Ollama で観測した生成の速さは、ほぼ同じでした
今回の正常終了した短い8課題では、回答が返るまでの中央値は約0.5〜1.2秒でした(2B Q4_K_M 0.93秒、Q8_0 1.15秒、1B 約0.5〜0.6秒)。多くは出力が数十〜200トークンほどの課題です。長い出力や、ほかの 6GB の GPU での待ち時間は、この結果だけでは判断できません。
品質: 同じ8問を3回ずつ解かせた
日本語・構造化・推論・コードの8問を用意し、各構成で3回ずつ(シード 11・23・37)解かせました。
- q1 抽出JSON:お知らせから日付・時刻・場所などを取り出して JSON で出す
- q2 要約:図書館の夜間貸出の記事を、40字以内の3行に要約する
- q3 条件つきの文:システム障害のお知らせを、150字以内・です・ます・必須の4項目つきで書く
- q4 注文JSON:注文文を JSON にし、合計金額(9,800円)も計算して入れる
- q5 計算:りんごとみかんの代金から10%引いた支払額(3,960円)を求め、考え方も書く
- q6 推論:3人の傘の色を、手がかりから当て、考え方も書く
- q7 Python:英単語を数えて上位 n 個を返す関数を書く(テスト5件)
- q8 JavaScript の修正:平均を返す関数のバグの原因を1〜2文で説明して直す(テスト8件)
q7・q8 は、モデルが書いたコードを、ほかのファイルやネットワークから切り離した環境でテストし、全件合格を最終結果の正答としました。q1〜q6 と、q5・q6・q8 の説明は、決めておいた基準に沿って1本ずつ理由をつけて判定しています(文章の意味の判定を含むので、完全な機械採点ではありません)。
llama.cpp・思考オフ(同じ条件の比較)
| 課題 | 2B Q4_K_M | 2B Q8_0 | 1B Q4_K_M | 1B Q8_0 |
|---|---|---|---|---|
| q1 抽出JSON | 3(3) | 3(3) | 3(0) | 3(0) |
| q2 要約 | 0(0) | 0(0) | 0(0) | 0(0) |
| q3 条件つきの文 | 3(3) | 3(3) | 3(0) | 3(0) |
| q4 注文JSON | 0(0) | 0(0) | 0(0) | 0(0) |
| q5 計算 | 0(0) | 0(0) | 0(0)※ | 2(2) |
| q6 推論 | 3(0) | 3(0) | 1(0)※ | 0(0) |
| q7 Python | 1(1) | 1(1) | 0(0) | 0(0) |
| q8 JavaScript | 3(0) | 3(0) | 2(0) | 0(0) |
| 合計 | 13(7) /24 | 13(7) /24 | 9(0) /22 | 8(2) /24 |
数字は3回のうち最終結果の正答の数、かっこ内は指定条件まで合格の数です。※の 1B Q4_K_M の q5・q6 は、1回ずつ出力の上限(1024トークン)まで書き続けて止まったので、採点から除き、その2本を分母から外しました(合計の分母が22)。
- 今回の8問では、2B の正答数が 1B より増えました(13本 対 8〜9本)。差が出たのは q6(推論)・q8(JavaScript)・q7(Python)です。一方、q5(計算)だけは 1B の Q8_0 が2回正解し、2B は0回でした
- 出力形式や説明まで含む指定条件の合格数は、2B が 7本、1B が 0〜2本でした。特に、抽出JSONの q1 と障害のお知らせの q3 では、2B が指定条件まで各3/3合格でした。1B は JSON を
```jsonの囲みに入れたり、お知らせの前後に「以下のシステム障害のお知らせを書きます。」のような前置きを付けたりして、指定の形を外しました - 2B の Q4_K_M と Q8_0 は、合計も課題ごとの数も同じでした
2B が間違えたところ
- q5 計算は、思考オフでは6回とも不正解でした。Q4_K_M は3回とも「計算は簡単。答え: 数字」のように、指示の「答え: 数字」という書式をそのまま写しました。Q8_0 は数字を出しましたが、2484・1964・2688 と、どれも 3960 ではありませんでした
- q4 注文JSON では、品目・数量・単価は取り出せましたが、合計金額は6本とも不正解でした。10020・10320・8555 などと答え、正しくは 9800円です。Q4_K_M の3本は、店名も「山田商店」から「山田」に変わっていました
- q2 要約は、3行・各40字以内には収まりましたが、市内在住という利用条件や、利用者数・トラブル件数で本格導入を判断する点を落とした応答がありました。また、「予約の受け取りはできない」を「予約不可」と広く言い換えたものもあります。今回選んだ要点に対しては6本とも不合格でしたが、これが唯一の正しい要約の基準という意味ではありません
- q6 推論は、答えは6回とも正しいものの、「考え方は簡単。」「色はそれぞれ違うので」のような一言だけで、手がかりからなぜその色になるかを説明しなかったので、指定条件まで合格にはなりませんでした
- q7 Python では、大文字を小文字にそろえる前に落としてしまう、単語ではなく1文字ずつ数える、数字を区切りにせず前後の文字をつなぐ、といった誤りがありました。思考オフの 2B は、Q4_K_M・Q8_0 とも全テスト合格が3本中1本でした
- q8 JavaScript は、2B の6本すべてが実行テスト8件を通りました。一方、説明まで含む基準では6本とも不合格でした。配列の外を読む原因を誤って説明したものに加え、空の配列では0を返す必要を文章で説明していないものがありました。1B は、空の配列で NaN を返すものや、元のバグ(
i <= nums.length)が残ったものがありました
思考オン+文脈・出力上限の拡大で、今回の計算とPythonが改善
2B で、q5〜q8(計算・推論・Python・JavaScript)を、思考をオンにして解かせました。思考の分だけ出力が長くなるので、文脈設定を4096から8192に、出力の上限を1024から4096トークンに増やしています。比べるのは、思考オフの同じ課題・同じシードの12本です。
| 構成・条件 | 最終結果の正答 | 指定条件まで合格 | 答えまで(中央値) | 答えまで(範囲) |
|---|---|---|---|---|
| 2B Q4_K_M・思考オフ/文脈4096/出力上限1024 | 7/12 | 1/12 | 0.79秒 | 0.28〜2.32秒 |
| 2B Q4_K_M・思考オン/文脈8192/出力上限4096 | 12/12 | 7/12 | 5.95秒 | 2.63〜10.78秒 |
| 2B Q8_0・思考オフ/文脈4096/出力上限1024 | 7/12 | 1/12 | 1.05秒 | 0.34〜2.05秒 |
| 2B Q8_0・思考オン/文脈8192/出力上限4096 | 12/12 | 9/12 | 7.35秒 | 3.63〜12.66秒 |
- q5 計算は 0/3 → 3/3、q7 Python は 1/3 → 3/3 になりました(Q4_K_M・Q8_0 とも、最終結果の正答)。q6 推論と q8 JavaScript は、思考オフでも最終結果は3/3でした
- 思考オンの q5 の答えの例(Q4_K_M・シード11。一部を省略して抜粋)。「りんご:7 × 320 = 2240 円」「みかん:12 × 180 = 2160 円」「合計:2240 + 2160 = 4400 円」「クーポン:4400 × 10% = 440 円」「支払い金額:4400 – 440 = 3960 円」と途中の式を書き、最後の行を「答え: 3960」にしました
- 代わりに、思考を含めた出力は中央値で約580〜650トークン(思考オフは約60)に増え、答えまでの時間は中央値で約6〜7秒、長いもので約11〜13秒かかりました。生成の速さ自体(約114 tok/s・約81 tok/s)は変わっていません
- この条件(文脈設定8192)でも、このPCの GPU 全体の VRAM 使用量は、本測定中の観測最大で Q4_K_M が 3,564 MiB、Q8_0 が 4,502 MiB でした
- 思考オンでも、説明まで正しくなるとは限りません。q8 の修正コードは6本すべてがテストを通りましたが、説明まで含む合格は Q4_K_M が 0/3、Q8_0 が 1/3 でした。たとえば Q4_K_M には、JavaScript で空の配列を割り算すると ZeroDivisionError が出る、という誤った説明が残りました
この比較は、思考の指定だけでなく文脈設定と出力の上限も変えた条件どうしの比較です。差を、思考の指定だけの効果とは言い切れません。注文の合計を求める q4 は、この条件では測っていません。
Ollamaで配信のまま使うと
同じ8問×3回を、Ollama 0.40.6 に配信のままのテンプレートで流しました("think": false)。観測した生成の速さは、上の表のとおり llama.cpp とほぼ同じです。
| Ollama・思考オフ | 2B Q4_K_M | 2B Q8_0 | 1B Q4_K_M | 1B Q8_0 |
|---|---|---|---|---|
| 最終結果の正答(指定条件まで合格) | 10(6)/24 | 12(7)/24 | 8(0)/23 | 6(4)/23 |
1B の2つは、1回ずつ出力の上限まで書き続けて止まった試行を分母から外しています。
ここは llama.cpp の表と同じ条件の比較ではありません。Hugging Face から Ollama に配られるテンプレートが 2B と 1B で違い(2B には思考を空にする部分と、停止の文字列 <think> がある)、入力のキャッシュなどの扱いも llama.cpp とそろえていないためです。2B が 1B より正答が多い傾向は同じでしたが、数本の差を実行環境の優劣とは考えていません。
文脈を長くすると: 131072では6GBを超える計算になった
2B は文脈長 131,072 トークンに対応しています。文脈設定を 32768 と 131072 にして起動し、短い質問(q1)を1本ずつ解かせました。
| 構成・文脈設定 | KVキャッシュ | VRAM 最大 | 共有GPUメモリの観測増分 |
|---|---|---|---|
| 2B Q4_K_M・32768 | 1,344 MiB | 4,588 MiB | 約+130 MiB(本測定・判定基準未満) |
| 2B Q4_K_M・131072 | 5,376 MiB | 5,573 MiB | +2,702 MiB(読み込み時) |
| 2B Q8_0・32768 | 1,344 MiB | 5,383 MiB(暖機) | 約+130 MiB(本測定・判定基準未満) |
| 2B Q8_0・131072 | 5,376 MiB | 5,714 MiB | +3,672 MiB(読み込み時) |
| 構成・文脈設定 | 生成 | 入力の処理 |
|---|---|---|
| 2B Q4_K_M・32768 | 114.94 tok/s | 478.39 tok/s |
| 2B Q4_K_M・131072 | 100.81 tok/s | 300.67 tok/s |
| 2B Q8_0・32768 | 80.96 tok/s | 470.96 tok/s |
| 2B Q8_0・131072 | 73.95 tok/s | 306.09 tok/s |
共有GPUメモリは GPU 全体の値で、直前のアイドルの中央値との差です。今回は200 MiB 以上の増加に印を付ける手順にしました。32768 では本測定中、131072 では読み込み時の観測値を載せています。131072 の短い本測定中は、共有メモリの観測点を取得できていません。増分は、モデルが退避した量そのものではありません。
- 文脈設定131072では、GPU 向けのモデル(Q4_K_M で 1,341 MiB)と KVキャッシュ(5,376 MiB)の確保量だけで 6GB を超える計算になり、読み込み時に共有GPUメモリ(PC のメモリ)の使用量も大きく増えました(約2.6〜3.6 GiB)
- それでも起動と短い質問はでき、生成は 32768 のときより約9〜12% 遅いだけでした。入力の処理は約35〜37% 遅くなりました
- ただし、試したのは177トークンの短い質問1本だけです。131072 トークンに近い長い文書を読ませたときの速さは測っていません
Windows では、GPU のメモリが足りないと、一部が PC のメモリに置かれることがあります。長い文書を扱うつもりなら、タスクマネージャーの「パフォーマンス」→「GPU」で共有 GPU メモリが増えていないか見てください。
この結果から言えること
- VRAM 6GB の GPU をすでに持っている人:このPCの文脈設定4096・思考オフでは、MiniCPM5-2B は画面表示と兼用の 6GB でも全部 GPU に載り、Q4_K_M で約115 tok/s でした。GPU を買い足さなくても試せます。Q8_0 でも VRAM は余り、今回の8問では Q4_K_M と正答の数が同じでした。速さを取るなら Q4_K_M から試すのがよさそうです
- 1B を使っている人:2B にすると速さは約半分になりますが、それでも約115 tok/s でした。今回の8問では、2B の正答数が 1B より増えました。特に、抽出JSONの q1 と障害のお知らせの q3 では、2B が指定条件まで各3/3合格でした。一方、計算付きの注文JSONである q4 は、2B でも全部不正解でした
- 計算やコードを試したい人:今回の q5 の計算と q7 の Python は、思考オンと文脈・出力上限の拡大を組み合わせた条件で正答が増えました。数秒〜十数秒待てる用途で試す候補です。注文の合計を求める q4 は、この条件では測っていません
- 長い文書を読ませたい人:文脈設定131072では、6GB に入りきらない計算になり、共有GPUメモリの使用量が増えました。この構成では、KVキャッシュとモデル、作業用の領域だけで約6.7 GiB(Q4_K_M。ログの確保量の合計)、この測定の直前に使われていた分(約1.7 GiB)を足すと約8.4 GiB になる計算で、VRAM 12GB の GPU なら収まる見込みです(推測・未実測)。
【PR】楽天市場でRTX 4070の価格を見る (MiniCPM5-2B の長い文脈は、RTX 4070 では未実測です)
動かすときの注意
- min_p を 0.0 にする。 モデルカードは、llama.cpp の既定の min_p=0.05 では繰り返しの出力になることがあると注意しています。推奨は temperature 1.0、top_p 0.95、min_p 0.0 です(今回は比較のため temperature 0.2 で測りました)
- 思考のオン・オフはリクエストで指定する。 llama.cpp では
--jinja付きでサーバを起動し、chat_template_kwargsのenable_thinkingを JSON の真偽値(true/false)で送ります。思考は応答のreasoning_content、最終的な回答はcontentに分かれて返ってきました - Ollama のテンプレートは 2B と 1B で違う。 2B のテンプレートには思考を空にする部分があり、1B には無いことを、
ollama show --modelfileで確かめました。同じ「思考オフ」のつもりでも、中身が同じとは限りません - llama-server が応答しないときは、ウイルス対策ソフトを疑ってください。私は9月にこれでつまずきました(llama-serverが応答しない原因はウイルス対策ソフトでした)
今回の起動とリクエストは、次のとおりです(ファイルの場所と、測定用の記録の指定は省略)。
# 2B Q4_K_M(全層を GPU に。文脈設定4096)
llama-server -m MiniCPM5-2B-Q4_K_M.gguf -ngl 99 -c 4096 --parallel 1 --jinja -fa on --cache-ram 0
{
"messages": [{"role": "user", "content": "(質問)"}],
"temperature": 0.2, "top_p": 0.95, "top_k": 40, "min_p": 0.0, "repeat_penalty": 1.0,
"seed": 11, "max_tokens": 1024, "cache_prompt": false, "stream": false,
"chat_template_kwargs": {"enable_thinking": false}
}思考オンのときは、-c 8192 で起動し、"max_tokens": 4096、"enable_thinking": true にしました。Ollama では、/api/chat に "think": false と、options に同じサンプリングの値(num_ctx 4096、num_predict 1024)を付けて送っています。
断定していないこと
- VRAM 6GB の GPU(画面表示と兼用)+ 4コア8スレッドのCPU + DDR4-3200 32GB の1台での実測です。llama.cpp は b11574、Ollama は 0.40.6 の1つの版だけで測りました。他の GPU・他の版では確かめていません
- 品質は、この8問・この採点の基準での結果です。3回は同じ8問の出力の揺れを見るための繰り返しで、24個の別々の課題ではありません。「2B は日本語が得意/苦手」「JSON の出力に向く」とまでは言えません。q2 の要点は今回選んだもので、唯一の正しい要約ではありません
- 文章の意味の判定は、決めておいた基準に沿ったレビューの判定です。判断が分かれそうなものは厳しい側(不合格)にしています
- temperature 0.2 で測りました。モデルカードの推奨(1.0)で使ったときの正答の数は確かめていません
- 思考オンの比較は、文脈設定と出力の上限も同時に変えた条件どうしの比較で、2B の4問×3回だけです。思考だけの効果は分けていません。1B の思考オンと、q4 の思考オンは測っていません
- Ollama の結果は、配信のままのテンプレートでの結果です。2B と 1B でテンプレートが違うので、Ollama の 1B と 2B の差を、モデルの大きさだけの差とは考えていません
- 文脈設定131072は、短い質問1本だけで測りました。長い文書を読ませたときの速さと、12GB の GPU で収まるかは未実測です
- 7月の 1B の記事(RTX 4070・Ollama 0.32.0・別の課題)の数字とは比べていません
まとめ
画面表示にも使う VRAM 6GB の GPU のこのPCで、MiniCPM5-2B は
- このPCの文脈設定4096・思考オフでは、全層を GPU に配置でき、VRAM の観測増分は約1.6〜2.5 GiB でした。生成は Q4_K_M で約115 tok/s、Q8_0 で約81 tok/sです
- 同じ8問×3回で、最終結果が正しかったのは 2B が 13本、1B が 8〜9本。指定条件まで合格したのは 2B が 7本、1B が 0〜2本でした
- 思考オンに加え、文脈設定を4096から8192、出力上限を1024から4096トークンに増やした条件では、q5〜q8 の4問×3回で、Q4_K_M・Q8_0 とも最終結果が12/12正答でした(思考オフは各7/12)。答えまでの中央値は約6〜7秒で、思考だけの効果を分けた比較ではありません
今回の8問では、2B は 1B より正答が増えました。短い抽出や定型文では思考オフ、今回の計算や Python では思考オンと文脈・出力上限を増やした条件が試す候補になります。生成された答えと説明は、用途に合わせて確かめて使ってください。
関連記事
- MiniCPM5-1Bを本格検証:656 MiBの小型LLMは日本語・コード・ゲーム生成に使える?
- LLM-jp-4.1をVRAM 6GBで実測|CPU併用の32B-A3Bが8Bより速く約18 tok/s
- Qwythos-9Bは32K contextで読める?VRAM 6GB環境で8K/16K/32K prefillを追加検証
- llama-serverが応答しない原因はウイルス対策ソフトでした
llama.cpp と Ollama での動かし方(思考の切り方、min_p、Ollama のテンプレートの違い)は、Zennに技術メモとしてまとめています。
MiniCPM5-2BをVRAM 6GBで動かす:約115 tok/s、思考の切り方・min_p・Ollamaテンプレートの注意(Zenn)
コメント