2026-10

ローカルLLM実装

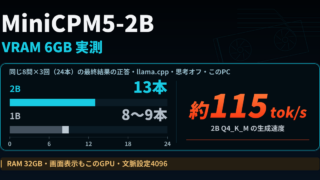
MiniCPM5-2BをVRAM 6GBで実測|約115 tok/s、同じ8問で1Bより正答が増えた

MiniCPM5-2Bの公式GGUFをVRAM 6GBのPCで実測。Q4_K_Mは約115 tok/s。同じ8問×3回で1Bと比較し、Ollamaの結果も掲載。思考オンと文脈・出力上限を増やした条件では、計算・コードの正答増加と約6〜7秒の待ち時間を確認しました。
ローカルLLM実装
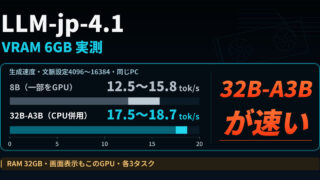
LLM-jp-4.1をVRAM 6GBで実測|CPU併用の32B-A3Bが8Bより速く約18 tok/s

LLM-jp-4.1の公式Q4_K_MをVRAM 6GB・RAM 32GBのPC 1台で実測。画面表示兼用、文脈設定4096〜16384では、CPU併用の32B-A3Bが17.5〜18.7 tok/s、8Bが12.5〜15.8 tok/s。待ち時間・品質・メモリの注意点も紹介。
ローカルLLM実装

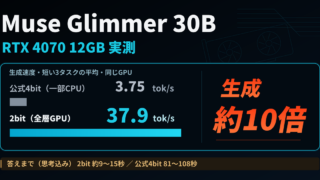
Muse Glimmer 30BをRTX 4070 12GBで実測|2bitは全層GPUで38 tok/s、公式4bitの約10倍

MetaのMuse Glimmer 30BをRTX 4070 12GBで実測。unslothの2bitは全層GPUで約38 tok/s、短い3タスクは思考込みで約9〜15秒。公式4bitは約3.7 tok/sで81〜108秒。品質とDFlashも比較。
ローカルLLM実装

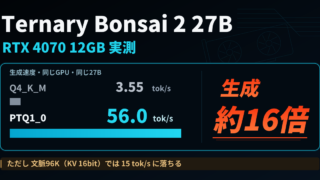
Ternary Bonsai 2 27BをRTX 4070 12GBで実測|27Bが毎秒56トークン、24GBは要るか

Ternary Bonsai 2 27BをRTX 4070 12GBで実測。思考オフの短い3タスクで、PTQ1_0は平均56 tok/s。12GBに載りきらないQ4_K_Mの約16倍でした。同じ3タスクの品質比較と、文脈枠・KV設定を変えたときの速度の変化を公開します。