
※本記事にはアフィリエイトリンク(広告)が含まれます。
先に結果
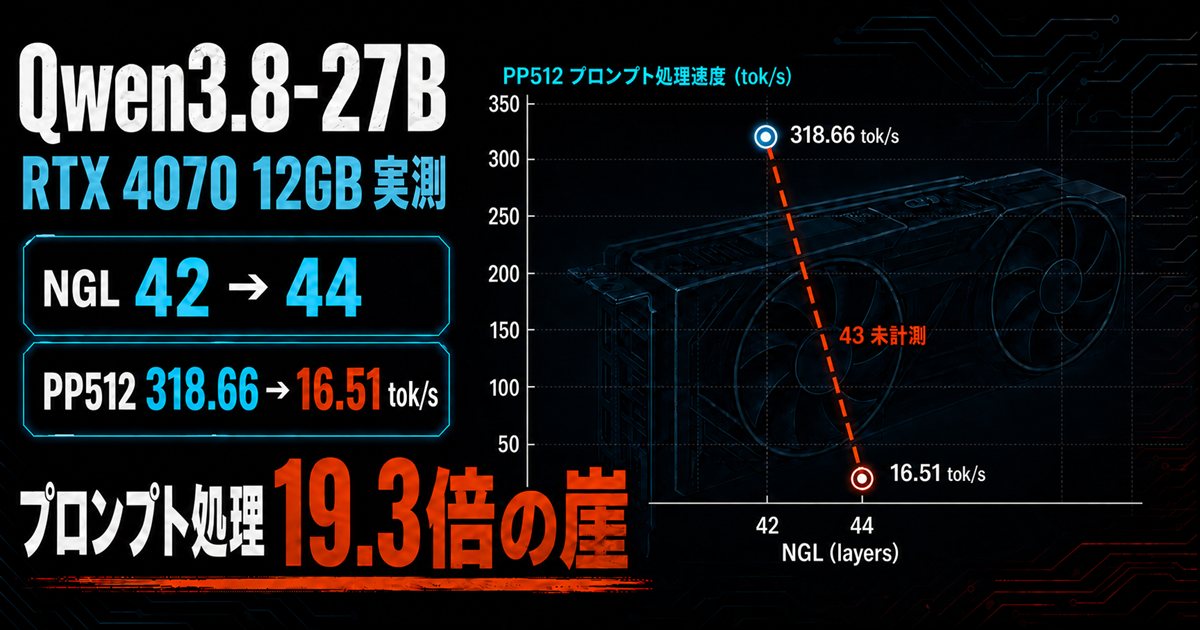
RTX 4070(VRAM 12GB)で Qwen3.8-27B の Q4_K_M(16.54 GiB)を動かした実測です。GPUに載せる層数(-ngl)だけを変えて8点測りました。
- 生成が最速なのは
-ngl 42(3.00 tok/s)。プロンプト処理が最速なのは-ngl 40(341.32 tok/s)。ねらい目は40〜42層 -ngl 44にした瞬間、プロンプト処理が 16.51 tok/s に落ちる。19.3分の1-ngl 99(全層指定)は最悪。生成 1.31 tok/s、プロンプト処理 27.30 tok/s- しかもエラーは出ません。OOMで落ちないので、遅くなったことに気づけません
「VRAMに載るだけ載せる」が正解だと思っていた人ほど、損をしている可能性があります。
検証環境
| 項目 | 値 |
|---|---|
| GPU | NVIDIA GeForce RTX 4070 / 12,282 MiB |
| ドライバ | 610.62(CUDA UMD 13.3) |
| CPU | Intel Core i7-9700K @ 3.60GHz |
| RAM | 31.9 GB |
| OS | Windows 11 Pro(build 26200) |
| llama.cpp | build 10456(commit f275595dd)win-cuda-12.4 |
| モデル | bartowski/Qwen3.8-27B-GGUF Qwen3.8-27B-Q4_K_M.gguf |
| ファイルサイズ | 17,772,537,440 bytes(16.54 GiB)※SHA256照合済み |
| 計測 | llama-bench -p 512 -n 128(各5回試行、±は標準偏差) |
アイドル時にデスクトップが約1,219 MiB使っています。以下のVRAM値はこれを含む実測値です。
llama.cppのバージョンに注意
Qwen3.8のGGUFは b10419以降が必要です。さらにCUDA側でGated DeltaNet層の出力が壊れる不具合があり、build 10450前後で修正されています。古いビルドだと「動くけれど出力がおかしい」という厄介な壊れ方をします。今回は b10456 を使いました。
実測:GPUに載せる層数を変えて8点
Qwen3.8-27Bは64層(+MTP層1つ)なので、-ngl 99 は「全部載せろ」の意味になります。
| ngl | プロンプト処理 pp512 (tok/s) | 生成 tg128 (tok/s) | VRAMピーク | GPU使用率 |
|---|---|---|---|---|
| 24 | 280.39 ± 5.26 | 1.90 ± 0.01 | 8,140 MiB (66.3%) | 21% |
| 32 | 292.57 ± 4.36 | 2.25 ± 0.03 | 9,904 MiB (80.6%) | 24% |
| 40 | 341.32 ± 10.50 | 2.79 ± 0.02 | 11,885 MiB (96.8%) | 29% |
| 42 | 318.66 ± 10.30 | 3.00 ± 0.03 | 11,861 MiB (96.6%) | 29% |
| 44 | 16.51 ± 0.09 | 1.96 ± 0.08 | 11,828 MiB (96.3%) | 68% |
| 48 | 31.71 ± 0.47 | 2.13 ± 0.20 | 11,877 MiB (96.7%) | 65% |
| 56 | 40.07 ± 0.39 | 1.84 ± 0.15 | 11,872 MiB (96.7%) | 82% |
| 99 | 27.30 ± 11.73 | 1.31 ± 0.17 | 11,886 MiB (96.8%) | 98% |
読み方は単純です。42までは上げるほど速く、44から先は別世界。各列の太字が最高値で、プロンプト処理は40層、生成は42層でピークになります。実用上のねらい目は40〜42層です。
崖は「2層」の幅で起きる
-ngl 42:プロンプト処理 318.66 tok/s-ngl 44:プロンプト処理 16.51 tok/s
差は19.3倍。動かした条件は層数だけです。43層は試していませんが、少なくとも42と44のあいだに崖があることは実測で確定しています。
生成速度のほうは 3.00 → 1.96 tok/s と、崩れ方がゆるやかです。プロンプト処理のほうが先に、そして激しく壊れます。長いプロンプトを投げる使い方をしている人ほど、この崖の被害が大きくなります。
気づけない理由1:GPU使用率は「上がる」
崖の手前と向こうで、GPU使用率が逆転します。
- 正常域(ngl 24〜42):21〜29%
- 崩壊域(ngl 44〜99):65〜98%
遅いほうがGPU使用率が高い。タスクマネージャーやnvidia-smiを見て「GPUがちゃんと働いている」と判断すると、真逆の結論になります。GPU使用率は、この崖の判定材料になりません。
なぜ使用率が上がるのかは、今回の検証では特定できていません。「VRAMからあふれた分の転送で忙しいのだろう」と考えたくなりますが、次の実測はその読みと噛み合いませんでした。
気づけない理由2:VRAM使用率でも判別できない
| ngl | VRAM% | 判定 |
|---|---|---|
| 40 | 96.8% | 正常(プロンプト処理が最速) |
| 42 | 96.6% | 正常(生成が最速) |
| 44 | 96.3% | 崩壊 |
| 99 | 96.8% | 崩壊 |
どれも96%台です。 nvidia-smiのVRAM使用率を見ても、崖のこちら側にいるのか向こう側にいるのかは分かりません。速度を測るしかありません。
さらに引っかかるのは、崩壊した44層のVRAM(11,828 MiB)が、正常な42層(11,861 MiB)や40層(11,885 MiB)より少ないことです。「VRAMからあふれたから遅い」という説明なら、崩壊時こそ上限に張り付くはずで、実測は逆を示しました。nvidia-smiが共有メモリへの退避を計上していない可能性はありますが、それは推測であり、今回は確かめていません。
気づけない理由3:エラーが出ない
-ngl 99 はOOMで落ちません。静かにロードされ、静かに動き、静かに遅いだけです。落ちてくれたほうがまだ親切でした。
別の27Bモデルでも再現しました
「これはQwen3.8だけの話では?」を確かめるため、以前このサイトで検証した Qwythos-27B の Q4_K_M(16.11 GiB)を、同じGPU・同じllama.cppビルド・同じコマンドで測り直しました。
| ngl | Qwen3.8-27B pp / tg | Qwythos-27B pp / tg |
|---|---|---|
| 32 | 292.57 / 2.25 | 296.88 / 2.28 |
| 42 | 318.66 / 3.00 | 321.69 / 3.03 |
| 44 | 16.51 / 1.96 | 27.16 / 3.09 |
| 99 | 27.30 / 1.31 | 48.42 / 1.69 |
2つ分かります。
1. プロンプト処理の崖は共通。 Qwythos-27Bでも 42→44 で 321.69 → 27.16 tok/s、11.8分の1に落ちます。少なくともQwen3.8固有ではありません。ただし試したのは同じ12GB・同じQ4_K_Mの27Bが2本だけなので、「27B全般で起きる」と言い切るには足りません。
2. 生成速度への影響はモデルで違う。 Qwythos-27Bは ngl=44 でも生成 3.09 tok/s を維持しました(ただし標準偏差±0.33と不安定)。Qwen3.8-27Bは1.96 tok/sまで落ちます。0.43 GiBのサイズ差が、崖のどちら側に落ちるかを分けたと考えられますが、この因果は未検証です。
そしてもうひとつ。同じngl設定なら、2モデルの速度はほぼ同じでした(ngl=42で3.00 vs 3.03 tok/s)。27Bクラスの速度を決めているのはモデルの中身ではなく、VRAMに何層載っているかだということです。
前回の「1.75 tok/s」について
このサイトのQwythos-27B記事では、生成速度 1.75 tok/s と書きました。今回の掃引で、その数字の正体が分かりました。
同じモデルを -ngl 99 で測ると 1.69 tok/s。前回の値とほぼ一致します(差3.4%)。つまり前回は、自動フィット設定で崖の向こう側に落ちた状態を測っていたことになります。
同じモデルを -ngl 42 にすると 3.03 tok/s。1.73倍です。
前回の計測が間違っていたわけではありません。設定が違えばその数字が出ます。ただ「27BはRTX 4070では1.75 tok/sが限界」という読み方は、設定次第で1.7倍動くというのが今回の実測です。
※前回はllama-server実運用(-c 16384 / KVキャッシュ q8_0 / Flash Attention on / build 10241)での計測、今回はllama-bench(build 10456)です。コンテキスト長・KV量子化・ビルドが違うため、1.75と1.69の一致は「同じものを測った」証明ではありません。ただし同一ツール・同一ビルドでngl=99と42を比べた1.73倍の差は、条件を揃えた実測です。
実運用では別の壁がありました(原因判明・追記あり)
llama-benchの数字は出ましたが、llama-server と llama-cli では応答を得られませんでした。
| 試行 | 結果 |
|---|---|
| llama-server(-ngl 42 / -c 8192) | 約18分間、HTTPに応答なし |
| llama-server(-ngl 32 / -c 8192) | 約9分間、同じく応答なし |
| llama-cli(-ngl 32 / -c 4096 / -n 24) | 約7分経過しても出力なし |
| llama-cli(-ngl 32 / -c 512 / -n 16) | 約7分経過しても出力なし |
いずれもVRAMは確保済み(9.3〜11.5 GiB)、GPU使用率は約40%で一定、プロセスは生きています。同じモデル・同じnglでllama-benchは8構成すべて完走しているので、モデルやビルドが壊れているわけではありません。
サーバの起動ログにはこの警告が出ています。
resolve_fused_ops: layer 0 is assigned to device CPU but fused Gated Delta Net (chunked)
                   is assigned to device CUDA0 (usually due to missing support)
resolve_fused_ops: fused Gated Delta Net (chunked) not supported, set to disabled
Qwen3.8のGated DeltaNet(線形アテンション)層が、部分オフロード時に融合カーネルを無効化されています。ただし、これが停滞の原因だと断定できる追加検証はしていません。
この記事で言えるのはここまでです。llama-benchで良い数字が出ても、対話用途で同じ速度が出るとは限りません。 導入を検討している方は、ベンチの数字だけで判断せず、自分の使い方で一度動かしてみてください。
追記 2026-09-03:応答しなかった原因が判明しました
上の「未解決」は解決しました。原因はセキュリティソフトのふるまい検知でした。Norton 360 が llama-server.exe を IDP.Generic として検出し、起動直後にブロックしていたのです。
厄介なのは症状の出かたです。プロセスは生きたまま、VRAMも確保したまま、GPUも回ったまま、HTTPの応答だけが返りません。エラーメッセージは出ません。検出はサーバ起動の7秒後に記録されていましたが、画面の通知は流れて消えていて気づけませんでした。さらに llama-bench は素通りします — 同じフォルダの同じCUDAコードなのに bench 側は検出されないので、「モデルもビルドも正常」に見えてしまいます。
決定的だったのは、止まった実行の起動ログが、モデル読み込み途中の1.35秒地点で完全に止まっていたことです。model loaded も listening も出ていません。それでいてプロセスは死なず、VRAMを 11.3 GiB 掴んだまま、GPU使用率28〜35%で17分37秒回り続けていました。
Nortonの「自動保護、スクリプト制御、SONAR保護、ダウンロードインテリジェンスの検出から除外する項目」に C:\[フォルダ名]\* を追加したところ、応答が返るようになりました。
ただし、作業フォルダごと除外するのはおすすめしません。そのフォルダ配下に後から置いた無関係なファイルまで保護対象から外れます。まずは検出履歴の確認と誤検出報告を検討し、除外するなら対象の実行ファイルなど必要最小限に絞ってください。設定画面の項目名は製品バージョンによって異なります。
| 除外後に試した構成 | 起動〜応答 | 生成速度 |
|---|---|---|
-ngl 99 -c 2048 |
50秒 | 0.81 tok/s |
-ngl 0 -c 2048 |
10秒 | 0.77 tok/s |
-ngl 32 -c 2048 |
10秒 | 1.39 tok/s |
-ngl 32 -c 512 -fa on |
10秒 | 1.36 tok/s |
正直に書いておくと、これは上の「応答なし」の表と厳密なA/Bではありません(除外後はコンテキスト長を 8192 から 2048 に下げています。理由は次の見出しで書きます)。ただ、除外前はどの構成でも7分以上まったく応答がなく、除外後はすべて1分以内に応答しています。
そして、この記事で疑っていた resolve_fused_ops の警告は原因ではありませんでした。この警告は正常に応答する構成でも同じように出ますし、そもそも止まった実行のログは、その行が出るより前で停止していました。推測を断定せずに「未確定」と書いて残しておいてよかった、という話でもあります。
あわせて分かったこと:ベンチの最速設定は、サーバではそのまま動きません
原因が消えたので測り直したところ、もうひとつ分かりました。llama-benchで生成速度が最速だった -ngl 42(プロンプト処理の最速は -ngl 40)をサーバに持ち込み -c 8192 で起動すると、610秒待っても /health が ok になりません(VRAM 11,893 MiB、GPU使用率は286サンプルの平均で98.7%)。これは上の表の ngl=99(崩壊域・98%)とまったく同じ形です。一方 -ngl 32 + -c 2048 なら9秒で起動します。
実際に動かして測った値がこちらです。
| 同じ ngl=32 | llama-bench | llama-server 実測 |
|---|---|---|
| プロンプト処理 | 292.57 tok/s | 58.57〜62.56 tok/s(約5分の1) |
| 生成 | 2.25 tok/s | 2.06〜2.08 tok/s(0.92倍) |
生成速度はだいたい移植できますが、プロンプト処理は移植できません。ベンチの pp512 は512トークンを1バッチで流すので、実際の130トークン程度のプロンプトとは1トークンあたりの効率がまるで違います。-ngl を決めるときは、llama-benchで当たりをつけたあと、実際に使う -c の値でサーバを起動して確かめるのが安全です。
この構成(-ngl 32 -c 2048)で日本語生成・要約・コード相談の3本を実際に流した結果と、あわせて踏んだPowerShell側の罠については、llama-serverが応答しない原因はウイルス対策ソフトでした|ローカルLLMで踏んだ3つの罠にまとめました。
この記事で断定していないこと
- RTX 4070 12GB + RAM 32GB という1環境、Q4_K_Mという1量子化での実測です。他のGPU・他の量子化は測っていません
- 速度はllama-bench(
-p 512 -n 128、5回試行)の値です。実運用の対話速度は今回取得できていません - 崖の正確な位置は「42と44のあいだ」までです。43層は測っていません
- Qwen3.8とQwythosで生成速度の崩れ方が違う理由(サイズ差0.43 GiB)は推測であり、検証していません
- 崖が起きる仕組みそのものを特定していません。VRAMの実測は「あふれたから遅い」という説明とは逆の傾向を示しています
- 再現を確認したのは同一GPU・同一量子化の27Bが2モデルだけです。他サイズ・他量子化への一般化は確かめていません
- 公式のベンチマークスコアには依拠していません
- MTP(
--spec-type draft-mtp)による投機デコードは未検証です
結局、どのGPUなら快適か
今回分かったのは「12GBでも27Bは動くが、設定を外すと19倍損をする」ということです。設定を詰めても生成3 tok/s前後なので、長文を待てる用途向けです。
- RTX 4070 12GB(本記事の実測環境):27B Q4_K_Mが
-ngl 42で生成3.00 tok/s。動きますが、対話用途には遅い - VRAM 16GB以上:27B Q4_K_M(16.5 GiB)が丸ごと載る帯域。崖を気にしなくてよくなるはず(未実測)
- VRAM 24GB:コンテキストを伸ばしても余裕がある帯域(未実測)
実売価格の目安です。
【PR】楽天市場でRTX 4070の価格を見る (本記事の実測環境)
【PR】楽天市場でRTX 4060 Ti 16GBの価格を見る(VRAM16GB帯の参考。本記事では未実測)
【PR】GP-ZEROで中古ゲーミングPCを見る(本記事では未実測)
自分の環境で最適な層数を探す
42という数字は、このGPU・このモデル・このコンテキスト長での値です。そのまま使える人はほとんどいません。ただ、探すのは簡単です。
まず両端と真ん中を測ります。
llama-bench -m <モデル.gguf> -ngl 99 -p 512 -n 128
llama-bench -m <モデル.gguf> -ngl 32 -p 512 -n 128
llama-bench -m <モデル.gguf> -ngl 40 -p 512 -n 128
-ngl 99 が -ngl 32 より遅ければ、その環境にも崖があります。あとは二分探索です。正常だった最大の層数と、崩壊した最小の層数のあいだを詰めていきます。今回は 32 → 40 → 42 → 44 の順で位置が決まりました。
1構成あたり5〜10分。30分あれば、自分のGPUと自分のモデルでの最適値が出ます。モデルを変えたら測り直してください。ファイルサイズが変われば崖の位置も動きます。
注意が1つあります。llama-benchは小さいコンテキストで測るため、実際にサーバを長いコンテキストで動かすとKVキャッシュがVRAMを使い、同じ層数でも余裕は減ります。llama-benchで出した最適値は、そのままサーバ設定に流用できるとは限りません(今回、ngl=42・8192コンテキストのサーバは11,457 MiBを確保した状態で応答を返しませんでした)。
まとめ
RTX 4070 12GBでQwen3.8-27B Q4_K_Mを動かすなら、
-ngl 40〜42あたりを探す。全部載せてはいけない- GPU使用率とVRAM使用率では崖を検知できない。速度を測る
- llama-benchの数字と、実際の対話速度は別物として扱う
同じことは別の27Bモデルでも起きました。モデルを変えるより、載せる層数を測り直すほうが効きます。
コメント