Qwen3

ローカルLLM実装

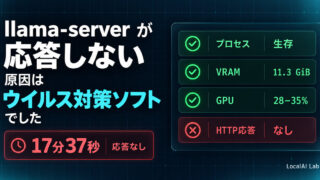
llama-serverが応答しない原因はウイルス対策ソフトでした|ローカルLLMで踏んだ3つの罠

llama-serverが起動しても応答を返さない。プロセスは生きていてVRAMも確保済み、GPUも回っているのにHTTPだけ返らない。手掛かりはウイルス対策ソフトの検出履歴でした。切り分け手順と、あわせて踏んだ2つの罠を実測値つきで公開します。
ローカルLLM実装
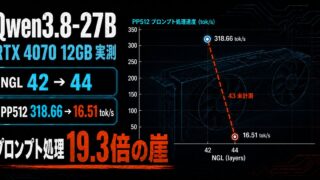
Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった

Qwen3.8-27B Q4_K_MをRTX 4070 12GBで実測。GPUに載せる層数を42から44に増やすだけでプロンプト処理が19分の1に崩落しました。llama-benchの生データと、別の27Bモデルでの再現結果を公開します。
ローカルLLM実装

自分のGPUでローカルLLMを使う手順|OllamaでGemma 4・Qwen3を動かす

OllamaでローカルLLMを使い始める手順を、GPU/VRAM別のモデル選び、プロンプト入力例、画像解析、速度やVRAM確認まで初心者向けに整理します。