【PR】この記事にはアフィリエイトリンクを含みます。実測に使った機材と、実測していない機材は、リンクごとに区別して記載しています。
この記事の測定結果 llama-server の生成の中央値と、回答中の VRAM 最大(GPU 全体の値)です。
LFM3-1.7B Q4_K_M
152.13 tok/s
llama-server・中央値
全層GPU 25/25 単位がGPU
読み込み前 1,794 測定中の最大 3,045 VRAM 6,144 MiB
LFM3-1.7B QAD 版 Q4_0
152.01 tok/s
llama-server・中央値
全層GPU 25/25 単位がGPU
読み込み前 1,794 測定中の最大 2,991 VRAM 6,144 MiB
LFM3-1.7B Q8_0
107.08 tok/s
llama-server・中央値
全層GPU 25/25 単位がGPU
読み込み前 1,794 測定中の最大 3,806 VRAM 6,144 MiB
LFM3-1.7B は 6GB に余裕を残して動き、今回の8問の正答は前回の MiniCPM5-2B より多い結果です。
- GPU
- VRAM 6GB の GPU(6,144 MiB)。画面表示もこのGPU
- CPU・メモリ
- 12th Gen Intel(R) Core(TM) i3-12100
- 実行環境
- llama.cpp b12005(llama-server と llama-bench)
結論
LFM3-1.7B の量子化3つを、画面表示と兼用の VRAM 6GB の GPU で実測した結果です。条件は llama.cpp(b12005)の llama-server、思考オフ、文脈設定4096 だけ。
- 3つとも全層が GPU に載った。回答中の VRAM 最大は Q4_K_M 3,045 MiB、QAD 版 Q4_0 2,991 MiB、Q8_0 3,806 MiB
- GPU 全体の値。画面表示などで最初から使われていた 1,794 MiB を含む
- 生成は Q4_K_M・QAD 版 Q4_0 とも約152 tok/s、Q8_0 は約107 tok/s(llama-server の中央値)
- 同じ8問を3回ずつ(24本)解かせた最終結果の正答は Q4_K_M 15本、QAD 版 Q4_0 16本、Q8_0 18本。形式や説明の指定条件まで合格は 9本・12本・12本
- 計算(q5)は9本すべて正解、要約(q2)と注文の合計金額(q4)は9本すべて不合格。JavaScript の修正(q8)はコードが9本ともテストに通り、説明まで含めると0本
- 前回の MiniCPM5-2B は前回記事の値で 13本(指定条件まで7本)。条件が違うため、倍率では比べていない(後述)
LFM3-1.7B は 6GB に余裕を残して動き、今回の8問の正答は前回の MiniCPM5-2B より多い結果です。
検証環境と条件
| 項目 | 内容 |
|---|---|
| GPU | VRAM 6GB の GPU(6,144 MiB)。画面表示もこのGPU。ドライバ 610.88 |
| CPU | 12th Gen Intel(R) Core(TM) i3-12100 |
| RAM | 34,136,092,672 bytes |
| OS | Windows 11(10.0.26300) |
| 実行環境 | llama.cpp b12005(llama-server と llama-bench) |
| 測定日 | 2026年10月31日(夜) |
モデルは次の3つの GGUF(サイズと SHA256 の一致を確認済み)。
| 量子化 | ファイル名・サイズ |
|---|---|
| Q4_K_M | LFM3-1.7B-Q4_K_M.gguf 1,099,627,808 bytes |
| QAD 版 Q4_0 | LFM3-1.7B-QAD-Q4_0.gguf 1,049,615,680 bytes |
| Q8_0 | LFM3-1.7B-Q8_0.gguf 1,846,238,496 bytes |
QAD 版は、ファイル名に QAD と付いた Q4_0 です(作り方は未確認)。読み込みログの表示は3つともパラメータ数 1.73 B、学習時の文脈長(n_ctx_train)262,144。
- llama-server:全層 GPU(3つともログで 25/25 層を確認)、文脈設定4096、flash attention 有効、同時1件
- 思考オフ。チャットテンプレートに思考の切り替え分岐(enable_thinking)があり、展開したプロンプトの末尾が空の思考ブロック(
<think></think>)になると3つとも起動時に確認できた - 8問の文面は前回の MiniCPM5-2B の記事と文字列まで一致。シード 11・23・37 で各課題3回
- 量子化ごとの手順:30秒待機 → llama-bench → 30秒待機 → llama-server 起動 → 暖機 → 24本の回答 → 停止
- llama-bench:全層 GPU(
-ngl 99)、flash attention 有効、4スレッド - q7(Python)・q8(JavaScript)のコードは別の Linux 機でテスト
- ネットワークを切った隔離環境で、解答ごとに使い捨てのフォルダ
- 1本あたり実時間10秒・メモリ 1GiB などの上限付き
- テスト前に、模範解答で q7 5/5、q8 8/8 を確認済み
用語の定義。
- tok/s:1秒あたりに生成するトークン数。トークン(モデルが文章を扱う単位)は1文字とは限らず、区切り方(トークナイザー)はモデルごとに違う
- 最終結果の正答:今回の採点基準で内容が合っていると判定した回答。q7・q8 はテストの全件合格が条件
- 指定条件まで合格:最終結果の正答のうち、出力の形式や課題で求めた説明も基準を満たした回答
- 答えまでの秒数:リクエストを送ってから応答が全部返るまで。読み込みと暖機のあとに測定
速度
生成は Q4_K_M と QAD 版 Q4_0 がほぼ同じで、Q8_0 だけ遅い。次の2表の単位は tok/s。
| 量子化 | llama-server 生成 | 入力の処理 |
|---|---|---|
| Q4_K_M | 152.13(149.43〜154.16) | 620.63 |
| QAD 版 Q4_0 | 152.01(149.73〜153.45) | 614.99 |
| Q8_0 | 107.08(103.41〜107.99) | 594.99 |
| 量子化 | llama-bench pp512 | llama-bench tg128 |
|---|---|---|
| Q4_K_M | 719.90 ± 23.86 | 154.71 ± 3.05 |
| QAD 版 Q4_0 | 718.57 ± 19.27 | 155.36 ± 4.38 |
| Q8_0 | 706.08 ± 30.82 | 108.47 ± 2.03 |
- llama-server の列:応答に含まれる値の中央値(24本すべて正常終了)。かっこ内は最小〜最大
- llama-bench:pp512 は512トークンの入力処理、tg128 は128トークンの生成。値は平均±標準偏差
| 量子化 | 答えまで(中央値と範囲) | ロード |
|---|---|---|
| Q4_K_M | 0.97秒(0.48〜3.43秒) | 27.58秒 |
| QAD 版 Q4_0 | 0.88秒(0.46〜2.00秒) | 27.05秒 |
| Q8_0 | 1.27秒(0.59〜3.10秒) | 27.49秒 |
ロードは llama-server の起動から応答できるまでの秒数。同じモデルの bench 直後の値で、OS のファイルキャッシュは未制御。PC 起動後に初めて読み込むときの時間とは別物。
- 入力の処理(pp512)は、生成ほど量子化による開きがない
- 答えまでの最長は Q4_K_M の q6(シード23)の 3.43秒で、489トークンを出力(注意点を参照)
VRAM
VRAM の値は GPU 全体の使用量(画面表示分を含む)です。llama-server だけの使用量ではありません。
- 外部記録:測定の外側で 1 秒おきに記録していた nvidia-smi(同じPC)
- コマンド:
nvidia-smi --query-gpu=timestamp,memory.used,memory.total,utilization.gpu,temperature.gpu,power.draw --format=csv -lms 1000 - 区間:測定ログの開始・終了時刻で切り出し
- 手順に組み込んだ1秒おきの VRAM 記録は、ファイルが6本とも0バイト。実行中の連続測定は取れていない(原因は未特定)
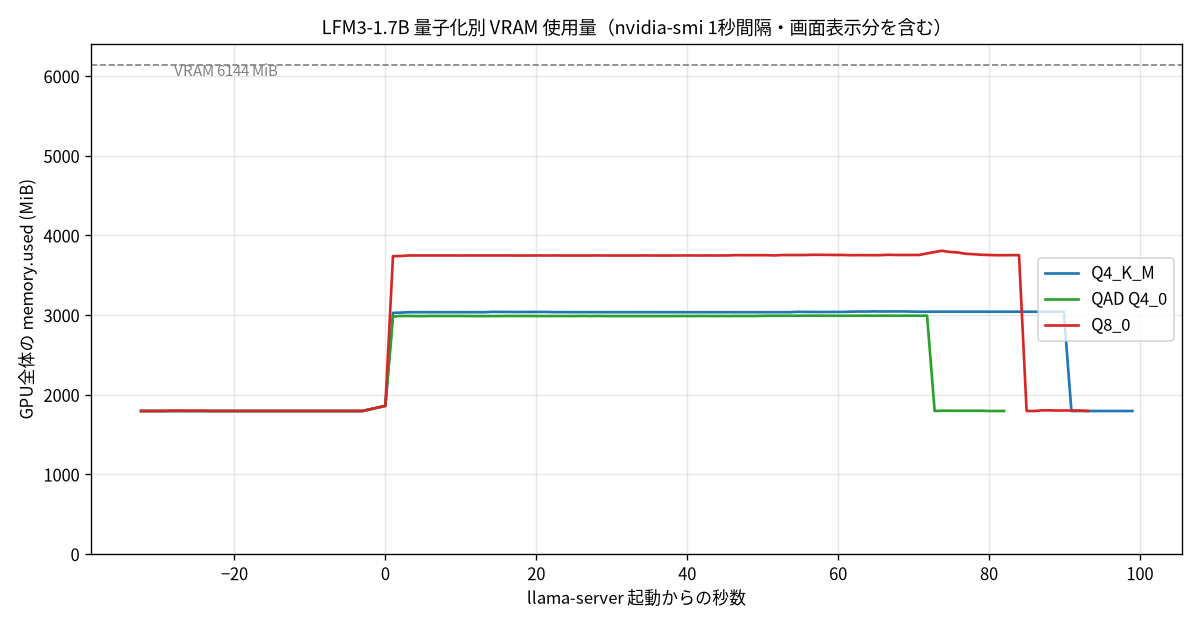
| 量子化 | 待機 | 本測定中の最大(増加) | 残り |
|---|---|---|---|
| Q4_K_M | 1,794 MiB | 3,045 MiB(+1,251) | 3,099 MiB |
| QAD 版 Q4_0 | 1,794 MiB | 2,991 MiB(+1,197) | 3,153 MiB |
| Q8_0 | 1,794 MiB | 3,806 MiB(+2,012) | 2,338 MiB |
| 量子化 | llama-bench 中の最大(増加) | 残り |
|---|---|---|
| Q4_K_M | 3,209 MiB(+1,415) | 2,935 MiB |
| QAD 版 Q4_0 | 3,157 MiB(+1,363) | 2,987 MiB |
| Q8_0 | 3,916 MiB(+2,122) | 2,228 MiB |
- 待機:llama-server 起動直前30秒の中央値
- 本測定中の最大:24本の回答区間の最大値
- 増加:「最大−待機」
- 残り:「6,144 MiB−最大」
- llama-bench の表の増加:bench 直前30秒の中央値(3つとも 1,794 MiB)からの差
- 本測定区間の観測点:Q4_K_M 28点、QAD 版 Q4_0 22点、Q8_0 32点
- 3つとも 6GB に収まった。いちばん大きい Q8_0 でも残りは 2,338 MiB
- llama-bench 中の最大は、本測定中より少し大きい
- llama-server 停止後は 1,794〜1,802 MiB に戻った
- 前回記事とは観測方法と間隔が違う(後述)
品質: 同じ8問を3回ずつ解かせた
8問は日本語・構造化・推論・コードの課題です。
- q1 抽出JSON:お知らせから日付・時刻・場所などを取り出して JSON で出す
- q2 要約:図書館の夜間貸出の記事を、40字以内の3行に要約する
- q3 条件つきの文:システム障害のお知らせを、150字以内・です・ます・必須の4項目つきで書く
- q4 注文JSON:注文文を JSON にし、合計金額(9,800円)も計算して入れる
- q5 計算:りんごとみかんの代金から10%引いた支払額(3,960円)を求め、考え方も書く
- q6 推論:3人の傘の色を、手がかりから当て、考え方も書く
- q7 Python:英単語を数えて上位 n 個を返す関数を書く(テスト5件)
- q8 JavaScript の修正:平均を返す関数のバグの原因を1〜2文で説明して直す(テスト8件)
採点の方法。
- q7・q8:コードのテスト
- q1・q4:値と形式の機械判定
- q2・q3・q5・q6 と q8 の説明(45本):決めておいた基準による1本ずつの理由つき判定。完全な機械採点ではない
llama.cpp・思考オフ(量子化3つ)
| 課題 | Q4_K_M | QAD 版 Q4_0 | Q8_0 |
|---|---|---|---|
| q1 抽出JSON | 3(3) | 3(3) | 3(3) |
| q2 要約 | 0(0) | 0(0) | 0(0) |
| q3 条件つきの文 | 3(0) | 3(2) | 3(1) |
| q4 注文JSON | 0(0) | 0(0) | 0(0) |
| q5 計算 | 3(3) | 3(3) | 3(3) |
| q6 推論 | 1(1) | 3(3) | 3(2) |
| q7 Python | 2(2) | 1(1) | 3(3) |
| q8 JavaScript | 3(0) | 3(0) | 3(0) |
| 合計 | 15(9) /24 | 16(12) /24 | 18(12) /24 |
数字は3回のうち最終結果の正答数、かっこ内は指定条件まで合格した数。72本すべてで最終回答が正常に返り、採点から外した回答はない。
- q1 と q5 は3つとも指定条件まで 3/3。q5 は9本とも計算の過程を示して 3,960円に到達
- 量子化で合否が分かれたのは q3・q6・q7。q3 と q6 には、Q4_K_M が落とし QAD 版 Q4_0 が合格したシードがあった(3回ずつの観察で、統計的な差とは言えない)
- 正答数の合計は Q8_0 18本、QAD 版 Q4_0 16本、Q4_K_M 15本
間違えたところ
9本とも落ちたのは q2 要約と q4 注文JSON の合計金額。q3・q8 は9本とも最終結果は正答で、落ちたのは指定条件。q6・q7 は一部の回答だけ誤り。
q2 要約:9本とも不合格
- 不合格の理由(例)
- 館内で予約を受け取れないことを「予約不可」と広げた
- 「来年度から本格導入するかを判断する」の時期の関係を変えた
- 判断材料(利用者数とトラブル件数)を落とした
- Q4_K_M の3本には40字超の行(42〜44文字)もあった
- 今回選んだ要点での判定で、唯一の正しい要約という意味ではない
q4 注文JSON:合計金額が9本とも不正解
店名・品目・数量・単価は9本とも正しい。合計金額は正しくは 9,800円で、回答は次のとおり(単位は円)。
| 量子化 | シード11 | シード23 | シード37 |
|---|---|---|---|
| Q4_K_M | 14,400 | 12,960 | 13,880 |
| QAD 版 Q4_0 | 11,440 | 11,700 | 12,900 |
| Q8_0 | 10,500 | 12,480 | 10,200 |
q3 条件つきの文:落ちたのは指定条件だけ
必要な情報は9本とも入っていた。指定条件で落ちた原因は3つ。
- 見出し付きで項目を並べただけで、です・ます調のお知らせでなく、末尾に読者への作成依頼が付いた(Q4_K_M 2本、QAD 版 Q4_0 1本)
- 採点で確認する語句「ログインできない」がない(Q4_K_M 1本、Q8_0 2本)
- 感嘆符が入った(QAD 版 Q4_0 1本、Q8_0 2本)
q6 推論:Q4_K_M が3本中2本で不合格
- Q4_K_M シード11:手がかり「B は緑でもない」を読み落とし、B=緑・C=赤 と回答
- Q4_K_M シード37:最後の行は正しいが、B=緑・C=赤 も成り立つと並べたため内容も不合格
- Q8_0 シード11:答えは正しいが、途中で「A は青でもない」と誤った条件を混ぜた。判断が分かれるため、指定条件は厳しい側(不合格)で判定
q7 Python:不合格3本は同じテストケースで落ちた
不合格は3本(Q4_K_M 1本、QAD 版 Q4_0 2本)。すべて同じテストケース top_words("a1b2 a", 5) で落ちた。
| 対象 | 返り値 |
|---|---|
| 期待値 | [("a", 2), ("b", 1)] |
| Q4_K_M(シード23) | [("a", 1)] |
| QAD 版 Q4_0(シード11・37) | [("a", 1), ("ab", 1)] |
- 期待値は、数字を区切りに a・b・a と数えた結果
- 不合格の3本はいずれも、数字を単語の区切りとして扱っていない
- 3本ともほかの4件は合格(4/5)。時間切れや環境の失敗は0件
q8 JavaScript:コードは9本とも合格、説明まで含めると0本
修正したコードは9本ともテスト8件に全部合格。一方、原因の説明まで含めた指定条件は3つとも 0/3。
- QAD 版 Q4_0 の3本:説明の文がない
- Q4_K_M・Q8_0 の6本:説明に次の不足があった
- 範囲の外から読んだ値が合計や平均を壊すつながりを説明していない(Q4_K_M のシード23、Q8_0 のシード23・37)
- 範囲外になる添字を「length より1つ大きい」と誤って説明し、計算が壊れる説明もない(Q4_K_M のシード11)
- 「範囲外の未定義の値を加算している」とは書いた。合計や平均が壊れるまで説明できているかは判断が分かれ、厳しい側で不合格(Q8_0 のシード11)
- 空の配列で0を返す必要を説明していない(Q4_K_M のシード37)
- Q4_K_M の2本と Q8_0 の3本:説明が3文で、「1〜2文」の指定も外れた
前回の MiniCPM5-2B との比較
前回記事「MiniCPM5-2BをVRAM 6GBで実測|約115 tok/s、同じ8問で1Bより正答が増えた」の 2B と並べます。
8問の文面、GPU の VRAM 容量(6,144 MiB)、ドライバの版(610.88)は前回記事と同じ。違うのは次の点です。
- llama.cpp の版:今回 b12005、前回 b11574。版の違いだけを見る測定(A1)を省いたため、版による差は不明
- VRAM の観測:今回は測定の外側で1秒おき、前回は測定の中で2秒おき。どちらも GPU 全体(画面表示分を含む)
- トークナイザー:違うため、tok/s は「同じ文章を何倍の速さで出せるか」を表さない
- 採点:前回の数字は前回記事の値で、今回の基準での再採点はなし。今回の q6 は、最後の答えは正しいが途中の推論が誤った1本(Q4_K_M・シード37)も内容で不合格にした
このため倍率は付けていません。
| 構成 | llama-bench tg128 | 生成の中央値 |
|---|---|---|
| LFM3-1.7B Q4_K_M(今回・b12005) | 154.71 | 152.13 |
| LFM3-1.7B QAD 版 Q4_0(今回・b12005) | 155.36 | 152.01 |
| LFM3-1.7B Q8_0(今回・b12005) | 108.47 | 107.08 |
| MiniCPM5-2B Q4_K_M(前回・b11574) | 117.14 | 114.59 |
| MiniCPM5-2B Q8_0(前回・b11574) | 82.22 | 81.20 |
| 構成 | 待機 | 本測定中の最大(増加) |
|---|---|---|
| LFM3-1.7B Q4_K_M(今回・1秒おき・外部記録) | 1,794 MiB | 3,045 MiB(+1,251) |
| LFM3-1.7B QAD 版 Q4_0(今回・1秒おき・外部記録) | 1,794 MiB | 2,991 MiB(+1,197) |
| LFM3-1.7B Q8_0(今回・1秒おき・外部記録) | 1,794 MiB | 3,806 MiB(+2,012) |
| MiniCPM5-2B Q4_K_M(前回・2秒おき) | 1,804 MiB | 3,459 MiB(+1,655) |
| MiniCPM5-2B Q8_0(前回・2秒おき) | 1,804 MiB | 4,395 MiB(+2,591) |
単位は上の表が tok/s、下の表が MiB(GPU 全体)。
| 課題 | LFM3-1.7B Q4_K_M/QAD 版 Q4_0/Q8_0 | MiniCPM5-2B (前回記事の値) |
|---|---|---|
| q1 抽出JSON | 3(3)/3(3)/3(3) | 3(3) |
| q2 要約 | 0(0)/0(0)/0(0) | 0(0) |
| q3 条件つきの文 | 3(0)/3(2)/3(1) | 3(3) |
| q4 注文JSON | 0(0)/0(0)/0(0) | 0(0) |
| q5 計算 | 3(3)/3(3)/3(3) | 0(0) |
| q6 推論 | 1(1)/3(3)/3(2) | 3(0) |
| q7 Python | 2(2)/1(1)/3(3) | 1(1) |
| q8 JavaScript | 3(0)/3(0)/3(0) | 3(0) |
| 合計 | 15(9)/16(12)/18(12) 各/24 | 13(7) /24 |
MiniCPM5-2B の列は前回記事の品質の表(llama.cpp・思考オフ)の値。前回は Q4_K_M と Q8_0 で課題ごとの数がすべて同じだったため、1列にまとめた。どちらも3回のうちの数で、合計は各 13(7)/24。
- いちばん大きな違いは q5 の計算。MiniCPM5-2B は思考オフで6本すべて不正解だった
- 逆に q3 の指定条件は MiniCPM5-2B が各3/3、LFM3-1.7B は 0〜2/3。q6 の MiniCPM5-2B は答えは正しく、説明を含めると0本
- q2・q4 は両モデルとも全部不合格、q8 は両方とも説明まで含めると0本
- 数字の上では LFM3-1.7B の tok/s が大きく VRAM の最大が小さいが、上の違いがあるため倍率では言えない
この結果から言えること
- VRAM 6GB の GPU をすでに持っている人:画面表示と兼用でも3つとも全部載った
- 速さなら Q4_K_M か QAD 版 Q4_0(約152 tok/s)、正答数なら Q8_0(18本)が候補
- 量子化の差は数本で、3回ずつの結果
- MiniCPM5-2B を使っている人:計算(q5)で大きな差が出た
- 決まった形のお知らせ(q3)は MiniCPM5-2B のほうが指定条件を多く満たした
- llama.cpp の版も違うので、用途に近い問題で両方を試してから決めてください
- 計算やコードを試したい人:q5 の計算は9本とも正解、q8 の修正コードもテストに通った
- ただし q8 の原因の説明は基準に届かず、q7 にも誤りが3本あった
- 生成されたコードは、テストで確かめてから使ってください
- 長い文書を読ませたい人:測定は文脈設定4096 だけ。学習時の文脈長は 262,144 だが、長い文脈での VRAM と速さは未測定
- PCごと替える人:今回の数字はこのPC 1台での値
- 中古のゲーミングPCを選ぶときも、VRAM の容量と画面表示で最初から使われる量を確かめてください
- GP-ZERO で扱っているPCでの動作は未実測
- OZ GAMING のPCでの動作も未実測

予算を抑えるなら中古:【PR】GP-ZEROで中古ゲーミングPCを見る

【PR】もっと大きいモデルや長い文脈を試すなら、GPU の VRAM を増やす手もある。手ごろなのは RTX 3060 12GB。この GPU での動作は未実測。
GIGABYTE GV-N3060WF2OC-12GD:Amazonで見る/楽天市場で見る/Yahoo!ショッピングで見る
注意点と、測っていないこと
- 検証環境の表の1台で、1晩に1回測った結果。llama.cpp も b12005 の1つの版だけで、ほかの GPU・版は未確認
- 品質はこの8問・3つのシード・この採点基準での結果。3回は出力の揺れを見る繰り返しで、24個の別々の課題ではない
- 文章の意味の判定は、判断が分かれそうなものを厳しい側(不合格)にした
- 量子化どうしの差は、統計的な差とは言えない
- VRAM は実行中の連続測定を取得できなかった(VRAM の節)
- ロード時間は OS のファイルキャッシュ未制御
- 思考オフでも、Q4_K_M の q6(シード23)の回答本文に閉じタグ
</think>と長い検討の文が出た- 思考の欄(reasoning_content)は空で、開きタグ
<think>もない - 削らずに採点し、最終結果は正答
- 思考の欄(reasoning_content)は空で、開きタグ
- 思考オンは未測定。Ollama での実行、文脈設定4096 以外の条件、Windows の共有GPUメモリの記録もない
- 手順書にあった追加の測定 A1〜A3 は未測定(版の差は切り分けられていない)
- q7・q8 のテストは別の Linux 機で実行
- QAD 版の作り方・通常の Q4_0 との違いは未確認
- 送信時のサンプリングの値は記載なし。モデルの推奨設定での正答数も未確認
コメント