【PR】この記事にはアフィリエイトリンクを含みます。実測に使った機材と、実測していない機材は、リンクごとに区別して記載しています。
結論
国立情報学研究所の LLM-jp-4.1 を、VRAM 6GB の GPU を積んだPCで動かした実測結果です。公式の4bit(Q4_K_M)の 8B と 32B-A3B を、同じPC・同じプロンプトで比べました。比べるために、RTX 4070(12GB)の別のPCでも測っています。
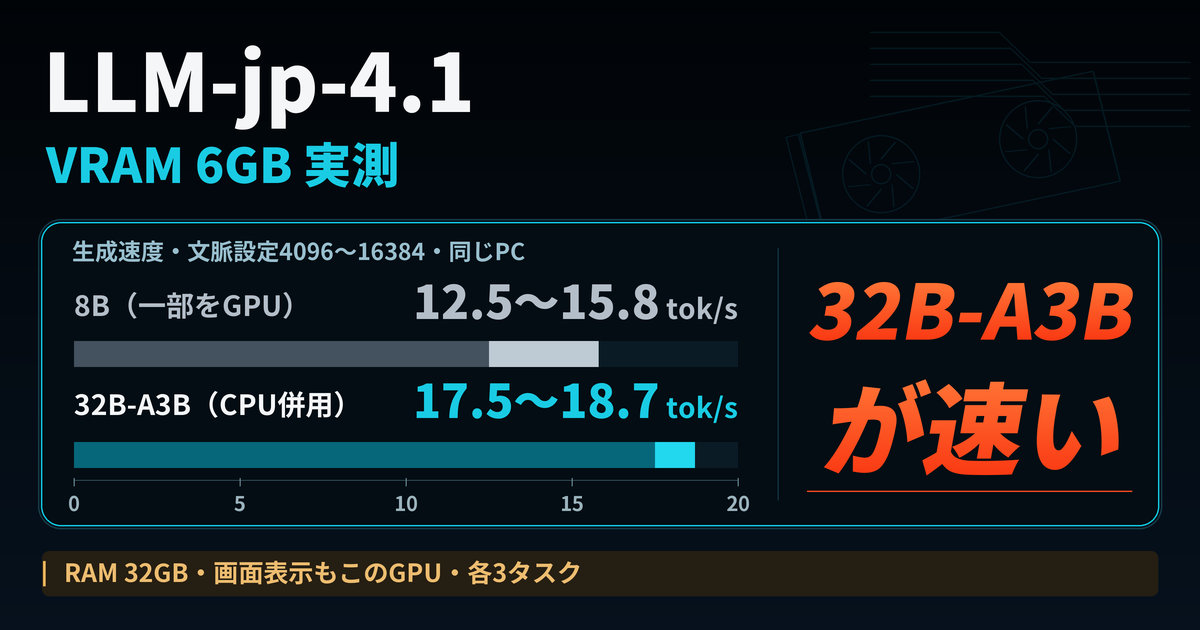
- 画面表示にも使う VRAM 6GB の GPU と RAM 32GB のこのPCでは、32B-A3B のほうが 8B より速く文章を生成しました。32B-A3B は、エキスパート(MoE の専門家の部分)の大半を CPU 側に置く設定で約17.5〜18.7 tok/s。8B は全部は GPU に載らず、12.5〜15.8 tok/sでした。同じ日に、文脈設定を 4096・8192・16384 の3通りにして各3タスクを測り、9組すべてで 32B-A3B が約1.14〜1.43倍速い結果です
- 文脈設定を短くすると 8B は速くなりましたが、32B-A3B は抜けませんでした。このPCでは llama.cpp を動かす前から VRAM が約0.9〜1.5 GiB使われていて、8B を多く載せようとすると、6GB を使い切る前に共有GPUメモリの使用量が増えたためです
- 今回の2日間の観測では、28〜30層ぶんのエキスパートを CPU 側に置いた 32B-A3B の生成は、いずれも約18 tok/s でした
- 答えが返るまでの秒数は、出力の長さしだいで、どちらが早いかが入れ替わりました(6GBのPCで、思考込みで約24〜61秒)
- 今回の RTX 4070(12GB)のPCでは、8B が全33層とも GPU に載り、約41 tok/s(6GB のPCの 8B の、文脈設定ごとの平均比で約2.6〜3.3倍)。答えまで約12〜19秒でした
このPCと今回の条件では、VRAM 6GB で LLM-jp-4.1 を使うなら、32B-A3B のエキスパートを CPU 側に置く使い方が有効でした。ただし、RAM は 32GB で、32B-A3B の実行中の空きは最小約1.1 GiB まで減りました。
LLM-jp-4.1とは
国立情報学研究所 大規模言語モデル研究開発センターが、2026年9月28日に公開した国産の言語モデルです(LLM-jp の発表)。8B、32B-A3B(MoE)、33B の3つがあり、どれも答える前に考える「思考(thinking)」型です。ライセンスは Apache 2.0(モデルカード)。公式の GGUF が Hugging Face で配られています。
| モデル | 種類 | 今回使ったファイル |
|---|---|---|
| 8B | dense(毎回すべての重みを使う) | Q4_K_M、5,499,918,304 bytes(5.12GiB) |
| 32B-A3B | MoE(総32B。1トークンごとに一部のエキスパートだけを使う) | Q4_K_M、21,522,488,192 bytes(20.04GiB) |
32B-A3B はファイルが約20GiB あり、6GB にも 12GB にも全部は載りません。そこで llama.cpp の --n-cpu-moe で、エキスパートの重みを CPU 側(PC のメモリ)に置き、それ以外を GPU に載せました。MoE は1トークンで使うエキスパートが一部だけなので、CPU に置いても速度が落ちにくい、というのが今回の見込みでした。
動かすときに知っておきたい点が2つあります。
- 思考の強さを選べます。 low / medium / high があり、既定は medium です。今回は主に medium で測りました(指定のしかたは後述)
- llama.cpp の対応状況の書き方が、資料によって違います。 GGUF のモデルカードには、10月18日時点でも「llama.cpp のフォーク(別のリポジトリで改修した版)が必要」と書かれています。一方、通常版の llama.cpp には、LLM-jp-4.1 の出力(思考・最終的な回答など)を解析する処理が10月1日に取り込まれ(PR #29681)、公式の手引き(LLM-jp-4 cookbook)も通常版の v0.6.0 以降を案内しています。今回は通常版の b11574 で、両モデルとも思考と回答が正しく分かれて返ってきました
検証環境
| 項目 | 6GBのPC(主役) | 12GBのPC(比較) |
|---|---|---|
| GPU | VRAM 6GB の GPU(6,144 MiB)。画面表示もこのGPU | GeForce RTX 4070 12GB(12,282 MiB)。画面表示もこのGPU |
| ドライバ | 610.88 | 617.42 |
| CPU | 4コア8スレッド | 8コア8スレッド |
| RAM | 32GB(16GB×2、DDR4-3200) | 32GB(8GB×4、DDR4-2133 で動作) |
| GPU の接続 | PCIe 3.0 x16(負荷中) | llama-bench の実行中の表示は PCIe 3.0 x1(後述) |
| 測定日 | 10月16日と18日 | 10月18日 |
- 実行環境は両方とも、通常版 llama.cpp b11574(Windows CUDA 12.4版)。モデルは公式の Q4_K_M(2つとも SHA256 を照合済み)
- サーバは llama-server、flash attention 有効(
-fa on)、--jinja、KVキャッシュは16bit(既定)、同時1件 - リクエストは思考の強さ medium、シード 20261013 固定、非ストリーミング、プロンプトのキャッシュなし。温度などはリクエストで指定せず、llama.cpp の既定値(temperature 0.8、top_k 40、top_p 0.95、min_p 0.05)。参照したモデルカードと手引きには、推奨のサンプリング値は見つけられませんでした
- 10月16日の6GBのPCは、ブラウザなど GPU を使うアプリを閉じてから測りました。ウイルス対策ソフト(Norton)は保護を有効にしたままです
用語を先に整理します。
- tok/s:1秒あたりに生成するトークン数。トークンはモデルが文章を扱う単位で、1文字とは限りません。生成のトークンには思考の部分も含みます
- 文脈設定:入力・思考・回答に使える枠の大きさ(
-c)。大きくするほど VRAM を使います。今回は約190〜210トークンの同じ短い質問を使い、文脈設定を 4096・8192・16384 に変えました。各設定で、共有GPUメモリの判定条件を満たす GPU 配置を選び直しています - 答えまでの秒数:リクエストを送ってから応答が全部返るまでの時間。モデルの読み込みと2回の短い暖機を済ませたあとに測りました。入力を読む時間と思考の時間を含みます。10月18日の文脈設定を変えた測定では、約190〜210トークンの入力を読むのに、8B で約1.4〜1.7秒、32B-A3B で約5.1〜5.3秒かかりました
速度: 6GBで8Bと32B-A3Bを比べた
同じ3つのプロンプト(長野1泊2日の旅行プランを500字以内、ローカルLLMの説明文を300字以内に要約、ボタンが動かないHTML/JavaScriptの相談)を、各1回投げました。10月18日の夜に、文脈設定を変えて同じ日に測った結果です。GPU に載せる量は、試した候補のうち、共有GPUメモリの判定条件(後述)を満たし、GPU への配置量が最も多い構成にしました。8B は主に2層刻み、32B-A3B は1〜2層刻みで試しています。
文脈設定 4096
| モデル(設定) | 旅行 | 要約 | コード |
|---|---|---|---|
| 8B(GPUに21/33層) | 14.49 | 14.87 | 15.00 |
| 32B-A3B(エキスパート28/32層をCPU) | 17.85 | 18.71 | 18.67 |
文脈設定 8192
| モデル(設定) | 旅行 | 要約 | コード |
|---|---|---|---|
| 8B(GPUに22/33層) | 15.39 | 15.37 | 15.79 |
| 32B-A3B(エキスパート30/32層をCPU) | 17.83 | 17.49 | 17.97 |
文脈設定 16384
| モデル(設定) | 旅行 | 要約 | コード |
|---|---|---|---|
| 8B(GPUに17/33層) | 12.51 | 12.67 | 12.68 |
| 32B-A3B(エキスパート30/32層をCPU) | 17.92 | 17.82 | 17.89 |
単位は tok/s(生成の速さ)です。18本すべて正常に完了しました。8B の「33」は、32層に出力層を加えた llama.cpp の数え方です。32B-A3B は -ngl 99(全33単位を GPU 側に指定)に加えて、32層のうち表の数の層のエキスパートを --n-cpu-moe で CPU 側に置いています。
- 9組すべてで 32B-A3B のほうが速く生成しました。比は文脈設定4096で約1.23〜1.26倍、8192で約1.14〜1.16倍、16384で約1.41〜1.43倍です
- 8B は文脈設定16384では、試した候補のうち判定条件を満たした17層の構成を採用し、生成は12.5〜12.7 tok/s でした。8192 では22層の構成で 15.5 tok/s 前後(16384 の構成より3タスクの平均で約23%速い)、4096 では21層の構成で 15 tok/s 前後でした。4096 では23層が判定できず(後述)、22層は試していません
- 32B-A3B は、どの文脈設定でも約17.5〜18.7 tok/s でした
答えまでの秒数は、出力の長さで入れ替わる
| 文脈設定・モデル | 旅行 | 要約 | コード |
|---|---|---|---|
| 4096・8B | 60.6秒(858) | 41.5秒(596) | 37.0秒(531) |
| 4096・32B-A3B | 52.8秒(853) | 24.4秒(363) | 26.7秒(402) |
| 8192・8B | 59.9秒(901) | 61.4秒(922) | 36.4秒(550) |
| 8192・32B-A3B | 46.8秒(741) | 38.7秒(589) | 31.0秒(464) |
| 16384・8B | 53.6秒(653) | 43.5秒(532) | 42.3秒(516) |
| 16384・32B-A3B | 46.5秒(741) | 38.1秒(589) | 31.1秒(464) |
かっこ内は出力トークン数(思考を含む)です。この日は9組とも 32B-A3B のほうが早く答えました。ただし、2日前(10月16日)に文脈設定16384で測ったときは、3本とも 8B のほうが早く答えています。
| 10月16日(文脈設定16384) | 旅行 | 要約 | コード |
|---|---|---|---|
| 8B(GPUに19/33層)生成 | 13.79 | 14.18 | 13.85 |
| 8B 答えまで | 45.5秒(607) | 25.5秒(342) | 28.1秒(367) |
| 32B-A3B(エキスパート28/32層をCPU)生成 | 18.02 | 18.24 | 18.15 |
| 32B-A3B 答えまで | 54.4秒(871) | 39.5秒(609) | 36.4秒(547) |
シードを固定していても、GPU に載せる量が変わると出力の中身と長さが変わりました。今回の答えまでの秒数は、生成の速さよりも「どれだけ長く考えて書いたか」に左右されました。速さの比較は生成の tok/s で見るのが確かです。
GPUを使わない8B
参考に、8B を GPU を使わない設定(--device none。ロードログで GPU 側の確保なし)でも動かしました(10月16日、コード相談1本、文脈設定16384)。生成は 6.25 tok/s、答えまで 101.1秒(出力591トークン)でした。CPU は 4コア8スレッド、メモリは DDR4-3200 です。遅いですが、GPU が無くても動きました。
RTX 4070 12GBのPCと比べると
8B: 全部載って約41 tok/s
今回の RTX 4070 のPCでは、8B の Q4_K_M が文脈設定16384で全33層とも GPU に載りました。生成は 40.89 / 41.21 / 41.06 tok/s、答えまで 19.3秒(787トークン)/11.7秒(480)/14.8秒(604)です。6GB のPCの 8B と比べると、文脈設定ごとの3タスク平均の比で約2.6〜3.3倍でした。GPU 単体の性能比ではなく、この2台・今回の配置での比です。
このときの GPU 全体の使用量のピークから直前の使用量を引くと、文脈設定16384で約7.0 GiB(8,730 − 1,573 = 7,157 MiB)、8192で約6.0 GiB(7,326 − 1,202 = 6,124 MiB)でした。背景の変化も含みうる差分の目安で、モデル単体の必要量を直接測った値ではありません。8GB の GPU で 8B が全部載るかは、画面などが使う分しだいで、本サイトでは未実測です。ほかの 12GB の GPU での速度も未確認です。
32B-A3B: 今回の 4070 のPCでは比べられない
RTX 4070 のPCでは、32B-A3B(文脈設定16384)は 約9.0〜9.2 tok/s で、6GB のPCの約半分でした。ただし、次の条件が重なっていて、GPU の差とは言えません。
- 配置を詰め切れていません。 サーバはエキスパートを全部 CPU に置く設定(
--n-cpu-moe 32)で測りました。llama-bench での配置の探索は、時間の上限で途中で打ち切りました。あとから llama-bench で探すと、18層ぶんだけ CPU に置く設定で生成 14.99 tok/s まで上がっています(サーバでは未実測) - GPU の接続が PCIe 3.0 x1 と表示されました(llama-bench の実行中に
nvidia-smiで確認)。6GB のPCは x16 です。エキスパートを CPU に置く方法は、PC のメモリと GPU の間のやり取りが増えるので、接続の幅が影響する可能性があります(推測) - メモリが DDR4-2133 で動いていて、6GB のPC(DDR4-3200)より遅い設定でした。エキスパートを CPU に置くと、生成の速さはメモリの速さにも左右されます(推測)
- アプリを閉じても、GPU 全体の使用率が30〜50%ほどある状態が続いていました(Windows のカウンターでは、画面表示の処理 dwm.exe の3Dエンジンが28〜75%)。この負荷が速さにどれだけ影響したかは確かめていません。llama-bench も同じ条件で測っています
MoE のエキスパートを CPU に置いて使うなら、GPU だけでなく、PC のメモリの速さと GPU の接続の幅も確かめておくと安心です。
思考の強さを変えると
コード相談で、思考の強さを low / medium / high に変えました(各1回、10月16日、6GBのPC・文脈設定16384)。
| モデル | low | medium | high |
|---|---|---|---|
| 8B(GPUに19/33層) | 18.6秒(238トークン) | 28.1秒(367) | 51.3秒(672) |
| 32B-A3B | 35.0秒(549) | 36.4秒(547) | 38.1秒(613) |
- 8B は、強さに応じて出力が短く・長くなりました
- 32B-A3B は、low にしても出力がほとんど短くなりませんでした(この1問では)
RTX 4070 のPCの 8B でも、low は4.0秒(156トークン)で、medium の14.8秒(604)、high の14.4秒(601)より大きく短くなりました。今回のコード相談1問では、8B は low にすると待ち時間を短くできました。RTX 4070 の 8B の回答は、low・medium・high とも正しくコードを直せていました(6GB の low・high の回答の質は確認していません)。
品質: 同じ3タスクを並べた
6GB のPC(10月16日)と 4070 のPC(10月18日)で、各モデル各タスク1回ずつ、計2回ずつの回答を見ました。品質は思考ではなく最終的な回答で判断しています。
- コード相談:4回とも、ボタンの
id="countButton"とgetElementByIdの引数の食い違いを原因として挙げ、正しい修正コードを出しました(回答を読んで確認。ブラウザでの実行はしていません) - 要約:4回とも、3つの要点と注意点1つの形と300字以内を守りました。一方で、4回とも原文にない補足が入りました。RTX 4070 のPCの回では、8B の補足(原文にない「遅延低減」)が目立ち、32B-A3B よりやや劣ると判断しました
- 旅行プラン(長野1泊2日):4回とも、交通や施設に誤りがありました。たとえば 8B は「新宿から特急あずさで長野駅へ」、32B-A3B は「小布施へJR篠ノ井線乗換」と書きました。特急あずさの運行区間に長野駅は含まれず(JR東日本)、小布施の玄関口は長野電鉄の小布施駅です(小布施町)
コード相談と旅行プランでは、8B と 32B-A3B の差は見えませんでした。要約は1回だけ 8B がやや劣りました(各タスク各モデル2回の範囲)。固有名詞や所要時間は、どちらのモデルでも自分で確かめる前提です。
この結果から言えること
- VRAM 6GB の GPU をすでに持っている人:このPCでは、32B-A3B のエキスパートを CPU 側に置く使い方が、8B より速く生成しました。文脈設定8192と16384では、30層ぶんのエキスパートを CPU に置く設定(
-ngl 99 --n-cpu-moe 30)で約18 tok/s。4096 の掲載値は28層ぶんを CPU に置いた設定で測ったものです。まず試す設定としては30層ぶんを挙げます。RAM は 32GB で動きましたが、空きは最小約1.1 GiB まで減りました。同時に使うアプリの分も見込んでください。他の 6GB GPU での速度は未確認です。
【PR】楽天市場で DDR4-3200 32GB(16GB×2)のメモリを見る (今回のPCと同じ規格・容量の検索結果です。今回使った1組以外は未実測)
- PC のメモリが 16GB の人:今回の 32B-A3B の CPU 側配置では、メモリ容量が厳しいと考えられます(CPU 側に置いた重みだけで約17〜18 GiB)。16GB の PC での動作と速度は未確認で、まず 8B が候補です
- GPU を買い替えるか迷っている人:今回の RTX 4070(12GB)では、8B の Q4_K_M を文脈設定16384で全層 GPU に載せられ、約41 tok/s でした。ほかの 12GB GPU の速度は未確認です。32B-A3B を 12GB でどこまで速くできるかは、今回のPCでは測り切れていません。
【PR】楽天市場でRTX 4070の価格を見る - GPU が無い、または古い人:8B は GPU を使わない設定でも 6.25 tok/s で動きました(4コア8スレッドのCPU)。出力591トークンの答えまで約100秒かかったので、気長に使う前提です
くわしく: 8Bは文脈設定を短くすると速くなった。それでも逆転しなかった
ここから下は、上の結果の裏付けと、動かすときに役立つ細かい観測です。
測る前は「文脈設定を短くすれば、8B の層を多く GPU に載せられて、32B-A3B を抜く」と予想していました。文脈がほぼ無い llama-bench では、8B を全部 GPU に載せて生成 39.61 tok/s が出ていたからです。実際のサーバでは、GPU への配置を17層から22層に増やせた文脈設定8192の構成で、16384の構成より3タスク平均で約23%速くなりましたが、32B-A3B は抜けませんでした。
6GB のうち、画面表示や常駐ソフトが使う分が大きい
このPCは画面表示にも同じ GPU(VRAM 6GB)を使っています。llama.cpp を動かす前の VRAM 使用量は、10月16日の夜(アプリを閉じた状態)が約920 MiB、18日の夜が約1,330〜1,550 MiB でした(2日の差の内訳は確かめていません)。6GB のうち約0.9〜1.5 GiB が、最初から使われている状態です。
同じ 8B・文脈設定16384でも、16日は19層を載せて余裕があり、18日は19層で共有GPUメモリの判定が「増加あり」になったので17層に下げました。生成は 13.8〜14.2 → 12.5〜12.7 tok/s です。6GB では、ほかに使われている数百MiBの差で、載せられる層数が変わりました。
6GBを使い切る前に、共有GPUメモリの使用量が増え始めた
Windows では、GPU のメモリが足りなくなると、一部が PC のメモリ(タスクマネージャーの「共有 GPU メモリ」)に置かれることがあります。今回は、llama-server 自身の共有GPUメモリの使用量を Windows のカウンターで読み、同じモデル・同じ文脈設定で VRAM を大きく余らせた構成の値(通常の起動時の確保で、約0.1 GiB)との差を見ました。以下の「増加なし/あり」は、この差による、今回の測定手順上の判定です。退避したページを直接数えた値ではなく、「なし」も差がゼロという意味ではありません。判定の目安は、8B・文脈設定4096 の1層の容量(約138 MiB)をもとに事前に決めた「69 MiB 未満なら増加なし、138 MiB 以上なら増加あり、その間は判定できず」です。
| 構成(10月18日) | 候補選定区間のGPU全体ピーク | 基準との差 | 手順上の判定 |
|---|---|---|---|
| 8B・16384・19層 | 5,639 MiB | 166 MiB | 増加あり |
| 8B・16384・17層 | 5,432 MiB | 0 MiB | なし |
| 8B・8192・24層 | 5,618 MiB | 166 MiB | 増加あり |
| 8B・8192・22層 | 5,621 MiB | 64 MiB | なし(69 MiB 未満) |
| 8B・4096・23層 | 5,480 MiB | 128 MiB | 判定できず |
| 8B・4096・21層 | 5,406 MiB | 0 MiB | なし |
ピークは候補を選ぶための起動と暖機の区間の値で、上の速度表の本測定の区間とは別です。共有の差は、暖機のあとの待機中の中央値で見ました。8192・22層は、本測定のために起動し直したあとは差が 0 MiB でした。
GPU 全体の使用量のピークが約5.3〜5.5 GiB(5,406〜5,639 MiB)のあたりで、判定が分かれました。ただし、全体の値だけでは見分けられません(22層の「なし」が5,621 MiB、24層の「増加あり」が5,618 MiB)。6,144 MiB をすべて使える前提で層数を計算すると、載せすぎになりました。
文脈設定4096の32B-A3B(28層ぶんを CPU)では、llama-server 自身の差は 38 MiB で「なし」でしたが、ほかのプロセスの共有GPUメモリも約120 MiB 増えていて、画面などのメモリの退避が疑われました。
今回、増加を検出した構成でも、エラーは出ませんでした。速さが急に落ちたら、タスクマネージャーの「パフォーマンス」→「GPU」で共有 GPU メモリが増えていないか見てください。
共有メモリの増加が大きい構成でも、短い生成の速さはほぼ同じだった
32B-A3B では、エキスパートを CPU に置く層を1つ減らすごとに、GPU 側のモデルの確保が約656 MiB 増えます。10月16日に使った「28層ぶんのエキスパートを CPU」は、文脈設定16384で、GPU 全体の共有GPUメモリの増え方が「30層ぶんを CPU」の構成(約110 MiB)より約400 MiB 大きくなっていました(この日はプロセス別ではなく GPU 全体の値で、区間の長さも違う参考値です)。それでも、起動確認の短い生成の速さは、28層ぶんが 18.97〜19.37 tok/s、30層ぶんが 19.06 tok/s でほぼ同じでした。文脈設定16384なら、30層ぶんのエキスパートを CPU に置く設定から試すのがよさそうです。
エキスパートを CPU に置くか、層ごと CPU に置くか
32B-A3B を、エキスパートではなく層ごと CPU に置く従来の方法(-ngl だけ。6層を GPU)でも測りました(10月16日、コード相談、文脈設定16384)。生成は 14.15 tok/s で、エキスパートを CPU に置いた構成(18.15 tok/s)のほうが約28%速い結果でした。
動かすときの注意
- llama.cpp は LLM-jp-4.1 に対応した版を使う。 今回は通常版の b11574 で動きました。モデルカードの「フォークが必要」という注意は、10月18日時点でまだ残っています
- 思考の強さはリクエストで指定する。 既定は medium です。リクエストに
"chat_template_kwargs": {"reasoning_effort": "low"}を付けると low になります。サーバは--jinja付きで起動します -nglと-cを自分で決める。 このPCの 8B は、文脈設定16384で17〜19層、8192で22層、4096で21層でした。ほかに使われている VRAM で変わるので、起動前にnvidia-smiで使用量を見てください- 共有 GPU メモリを見る。 今回は増加を検出した構成でもエラーは出ませんでした。タスクマネージャーで共有 GPU メモリが増えていないか確かめてください
- llama-server が応答しないときは、ウイルス対策ソフトを疑ってください。私は9月にこれでつまずきました(llama-serverが応答しない原因はウイルス対策ソフトでした)
今回の起動とリクエストは、次のとおりです(ファイルの場所と、測定用の記録の指定は省略)。
# 32B-A3B(30層ぶんのエキスパートを CPU に。6GB・文脈設定16384)
llama-server -m llm-jp-4.1-32b-a3b-thinking-Q4_K_M.gguf -ngl 99 --n-cpu-moe 30 -c 16384 --parallel 1 --jinja -fa on

# 8B(22層を GPU に。6GB・文脈設定8192)
llama-server -m llm-jp-4.1-8b-thinking-Q4_K_M.gguf -ngl 22 -c 8192 --parallel 1 --jinja -fa on
{
"messages": [{"role": "user", "content": "(質問)"}],
"max_tokens": 8192,
"seed": 20261013, "cache_prompt": false, "stream": false,
"chat_template_kwargs": {"reasoning_effort": "medium"}
}max_tokens は、文脈設定16384のときが8192、8192のときが7680、4096のときが3584です。思考は応答の reasoning_content、最終的な回答は content に分かれて返ってきます。
断定していないこと
- 6GB は GPU(VRAM 6GB)+ 4コア8スレッドのCPU + DDR4-3200 32GB の1台、12GB は RTX 4070 + 8コア8スレッドのCPU + DDR4-2133 32GB の1台での実測です。通常版 llama.cpp の1つの版(b11574)だけで測りました。他の GPU・他の版・Ollama などは確かめていません
- 速度も品質も各タスク1回です。品質は2台の回答を合わせても各2回で、「今回はこうだった」までです
- 6GB で載せられる層数は、画面表示や常駐ソフトなどが使う VRAM で変わります。今回の層数がほかの PC でも同じとは限りません
- 共有GPUメモリの「増加なし/あり」は、Windows のカウンターと、余裕のある構成との差による手順上の判定です。退避が一切ないことの証明でも、退避した量そのものでもありません
- RTX 4070 のPCの 32B-A3B は、配置を詰め切れておらず、PCIe の接続の幅・メモリの速さ・画面の負荷の条件も違います。遅かった理由は確かめていません
- 入力は約190〜210トークンの短いものだけです。長い文書を読ませたときの速さは測っていません
- 33B と、KV キャッシュの量子化(
-ctk q8_0など)は試していません
まとめ
画面表示にも使う GPU(VRAM 6GB)と RAM 32GB のこのPCで LLM-jp-4.1 を使うなら、
- 32B-A3B のエキスパートを CPU 側に置いて使う。文脈設定4096〜16384の各3タスクで約18 tok/s と、一部だけ GPU に載る 8B より1.14〜1.43倍速く生成しました
- 8B は、ほかに使われている VRAM で載せられる層数が変わり、12.5〜15.8 tok/s でした。急に遅くなったら共有 GPU メモリを見てください
- RAM は 32GB で動きましたが、32B-A3B の実行中の空きは最小約1.1 GiB まで減りました。同時に使うアプリの分も見込んでください
画面表示にも使う VRAM 6GB の GPU と RAM 32GB の今回のPCでは、小さいモデルを詰め込むより、大きい MoE を CPU と GPU に分けて動かす使い方が有効でした。
なお、8B を速く使いたいなら、今回の RTX 4070(12GB)のPCでは全部載って約41 tok/s でした。
コメント