【PR】この記事にはアフィリエイトリンクを含みます。実測に使った機材と、実測していない機材は、リンクごとに区別して記載しています。
結論
RTX 4070(VRAM 12GB)で Ternary Bonsai 2 27B を動かした実測結果です。比べる相手は、同じ日・同じGPUで測った元のモデル Qwen3.8-27B の Q4_K_M です。
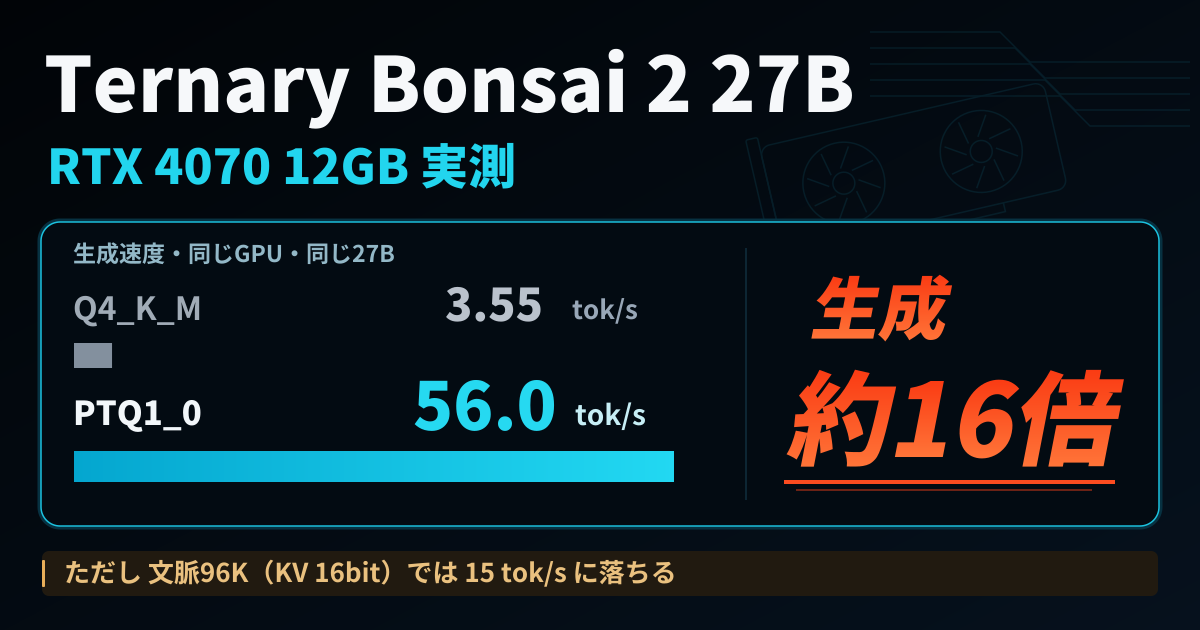
- 全層がGPUに載り、実運用(llama-server)の生成は PTQ1_0 で 56.0 tok/s、PQ2_0 で 49.0 tok/s。Q4_K_M は12GBに載りきらず、試した中で速いほうの設定(
-ngl 42)でも 3.55 tok/s。約16倍/約14倍です - 同じ3タスク(日本語生成・要約・コード相談、思考オフ)では、Q4_K_M との明確な品質差は見えませんでした(各1回なので傾向まで)
- ただし文脈枠を広げると、12GBでもう一度「崖」が出ます。
-ngl 99と-cだけを指定した場合(KVキャッシュ16bit)、PQ2_0 は48Kまで、PTQ1_0 は64Kまでは速度が落ちず、PQ2_0 は64K、PTQ1_0 は96Kで生成が約3〜4分の1に落ちました。その間のどこが境目かは測っていません。エラーは出ません(短い入力で確認。文脈を実際に32K埋めると、それだけで約2割遅くなります) -fa on -ctk q8_0 -ctv q8_0(flash attention と8bitのKVキャッシュ)を付けると、PQ2_0 は64Kまで正常(128Kでは落ちた)、PTQ1_0 は試した最大の128Kでも正常な速度でした- RTX 4070 では PTQ1_0 がおすすめです。生成が速く、長い文脈も入ります
「27Bを動かすには24GBのGPUが要る」と考えていた人へ。このモデルに関しては、今回のRTX 4070 12GBで、思考オフの短い3タスクなら実用的な速度(生成56 tok/s)が出ました。他の12GB GPUや、長い入力・思考モードは未実測です。より大きなVRAMが効いてきそうなのは、長い文脈枠を16bitのKVキャッシュのまま使いたい場合、通常の4bit版を全層GPUに載せたい場合、画像入力を併用する場合などです(必要な容量と24GB機の速度は未実測)。
Ternary Bonsai 2 27Bとは
Prism ML が 2026年9月に公開したモデルです。中身は Qwen3.8-27B で、重みを {−1, 0, +1} の三値に縮めています。ライセンスは Apache 2.0 です。
| 形式 | サイズ | 1重みあたり |
|---|---|---|
| PTQ1_0 | 5.95 GB | 1.75 bit |
| PQ2_0 | 7.21 GB | 2.13 bit |
| (参考)Qwen3.8-27B Q4_K_M | 17.77 GB | 約5 bit |
PTQ1_0 と PQ2_0 は、同じ三値の重みを、ぎっしり詰めるか(PTQ1_0)、1つずつ2bitの枠に入れるか(PQ2_0)の違いです(メーカー資料)。通常の量子化のように「ビットが少ないほうが劣化する」関係ではありません。
メーカーは「思考モードで測った14種類のテストの平均で 84.78、元の FP16(86.32)の 98.2% を維持」としています。第三者による確認は見つかっておらず、この記事もこの数字には依拠しません。 確かめたのは「同じGPUで、同じ3タスクを、元のモデルと並べるとどうか」です。
注意点がひとつあります。通常の llama.cpp では PTQ1_0 / PQ2_0 を読み込めません。 メーカーの資料によれば、現行の Ollama など、通常版の llama.cpp を内蔵したツールでも動きません(2026年10月時点)。LM Studio は確認していません。Prism ML が公開している改造版の llama.cpp が必要です(後述)。
検証環境
| 項目 | 値 |
|---|---|
| GPU | NVIDIA GeForce RTX 4070 / 12,282 MiB |
| ドライバ | 617.42 |
| CPU | Intel Core i7-9700K @ 3.60GHz |
| RAM | 31.9 GB |
| OS | Windows 11 Pro(build 26300) |
| 実行環境(Bonsai) | PrismML版 llama.cpp prism-b10754(Windows CUDA 12.4版) |
| 実行環境(Q4_K_M) | 通常版 llama.cpp b10456 |
| モデル | prism-ml/Ternary-Bonsai-2-27B-gguf の PQ2_0 / PTQ1_0(SHA256照合済み) |
| 計測 | llama-bench -p 512 -n 128(各5回、±は標準偏差)と、llama-server での実タスク |
デスクトップが常に約1.2GBのVRAMを使っています。以下のVRAM値はこれを含みます。
用語を先に整理します。トークンはモデルが文章を扱う単位で、1トークン=1文字ではありません。tok/s は1秒あたりに生成(または処理)するトークン数です。文脈枠(-c)は入力と出力を収める枠の大きさで、実際に入れた文章の長さとは別のものです。この記事の 32K・64K などの K は 1,024 トークン単位(64K=65,536)で、メーカーが示す上限 262K は 262,144 トークンです。KVキャッシュは、それまでの文脈の計算結果を保持しておくメモリで、文脈枠が大きいほどVRAMを使います。
速度の比較は「同じ日に測り直した」Q4_K_M で
9月1日に同じPCで測った Q4_K_M は、生成 3.00 tok/s でした(9月1日の記事)。今回、同じ条件で測り直すと 3.55 tok/s で、18%速くなっていました。この間にGPUドライバとWindowsが更新されています。条件が変わったので、この記事の速度の比較はすべて同じ日(10月7日)の値で行います。
速度: llama-bench
| 構成 | プロンプト処理 pp512(512トークン、tok/s) | 生成 tg128(128トークン、tok/s) | VRAMピーク |
|---|---|---|---|
Q4_K_M(-ngl 42。12GBに載りきらず一部をCPUで処理) | 358.07 ± 42.68 | 3.55 ± 0.05 | 11,961 MiB |
PQ2_0(-ngl 99、全層) | 1293.30 ± 23.17 | 53.19 ± 0.13 | 8,666 MiB |
PTQ1_0(-ngl 99、全層) | 1285.44 ± 21.52 | 61.37 ± 0.16 | 7,517 MiB |
- 生成は PQ2_0 が 15.0倍、PTQ1_0 が 17.3倍
- PTQ1_0 のほうが生成が速い。メーカーも「RTX 40シリーズ(Ada世代)では PTQ1_0 の生成が速い」としており、そのとおりでした
- 一方、プロンプト処理は2つでほぼ同じでした。メーカーの表では RTX 4090 で PQ2_0 が約1.9倍速いとありますが、RTX 4070 では差が出ませんでした
GPU使用率は高いのに速い
全層がGPUに載った今回は、ベンチ中のGPU使用率が 70〜90% でした。9月1日の測定では、載せる層を増やしすぎて遅くなった構成ほどGPU使用率が高く(65〜98%)、正常な構成は21〜29%でした(集計のしかたが今回と少し違うので目安です)。今回は使用率が高くて速い。GPU使用率は、それだけでは良し悪しの目安にならない、ということです。
文脈が埋まると2割減
-d(すでに読み込んだ文脈の長さ)を変えて、別に測りました。
| 構成 | 文脈 0 | 文脈 8,192 | 文脈 32,768 |
|---|---|---|---|
| PQ2_0 生成 (tok/s) | 53.35 | 50.31 | 42.87 |
| PTQ1_0 生成 (tok/s) | 61.49 | 57.92 | 48.20 |
「文脈 0」の値は上の表とは別の実行なので、わずかに違います。32Kトークンの文脈が埋まった状態では、生成が約2割遅くなりました。VRAMのピークは PQ2_0 で 10,566 MiB、PTQ1_0 で 9,428 MiB です。
速度: 実際に使ったとき(llama-server)
9月3日の実測と同じ3つのプロンプトを、同じ設定(温度0.7、思考オフ、最大768トークン)で投げました。思考の止め方だけは違います(後述)。起動条件は、Q4_K_M が -ngl 42 -c 2048、Bonsai の2形式が -ngl 99 -c 8192 です。表は3タスクの生成速度(tok/s)とVRAMピークです。
| 構成 | 日本語生成 | 要約 | コード相談 | VRAMピーク |
|---|---|---|---|---|
| Q4_K_M | 3.55 | 3.56 | 3.54 | 11,856 MiB |
| PQ2_0 | 48.91 | 49.09 | 49.07 | 8,760 MiB |
| PTQ1_0 | 56.21 | 55.62 | 56.21 | 7,608 MiB |
Q4_K_M は、9月3日と同じ -ngl 32 -c 2048 では 2.60〜2.65 tok/s でした。上の表には、それより速かった -ngl 42 の値を載せています。
今回の旅行プラン1件では、Q4_K_M は265トークンを75.7秒、PTQ1_0 は336トークンを6.2秒で書き終えました(出力の長さが違うので、同じ文章を書かせた比較ではありません)。長い入力や続けての会話、思考モードでの待ち時間は測っていません。
今回の条件(短い入力・思考オフ・-c 8192)では、3タスク平均の生成速度は llama-bench の約91〜92%でした。9月3日の実測で分かった「生成速度はベンチから見積もれる」は、この条件では今回も成り立っています。
品質: 同じ3タスクを並べた
各タスク1回・温度0.7・思考オフです。比べたのは、Q4_K_M の3回分(9月3日・10月7日の2設定)と、Bonsai の2形式です。
コード相談: 5つとも完全正答
ボタンの id="countButton" と getElementById("button") の食い違いを、5つとも正しく指摘し、正しい修正コードを出しました。差はありません。
要約: 5つとも大筋で原文に忠実
最後の「注意点」も5つとも書けています。「重要な点を3つに整理する」という指示には、5つとも箇条書きではなく地の文で答えました(3点は含まれています)。Q4_K_M の10月7日の2回(「プライバシー保護に優れる」「プライバシーが守られる」)と PTQ1_0(「クラウドと比べて初期設定の手間がかかります」)には、原文にない言い換えが少し入りました。1回ずつなので、差とは言いません。
日本語生成(長野1泊2日の旅行プラン): 5つとも地理を間違えた
| 字数(500字以内) | 地理の誤り(抜粋) | |
|---|---|---|
Q4_K_M(9/3、-ngl 32) | 569(超過) | 「新幹線で松本まで」 |
Q4_K_M(10/7、-ngl 32) | 365 | 東京→長野が「約2時間半」、「長野市立美術館」 |
Q4_K_M(10/7、-ngl 42) | 420 | 「松本市内の『善光寺』」 |
| PQ2_0 | 362 | 東京→長野が「約2.5時間」、長野の旅程に「松川湖」 |
| PTQ1_0 | 506(超過) | 「新幹線で信州大島駅へ」→松本へ |
字数は、改行と太字などの記号を除いて数えました。
確かめた事実です。
- 東京→長野は、北陸新幹線「かがやき」で1時間20分前後です(たとえば503号は東京7:20発・長野8:37着の77分。2026年10月のJR東日本時刻表。列車によって所要時間は異なります)
- 松本に新幹線は通っていません。善光寺は長野市にあります
- 松川湖は静岡県伊東市にあります
- 長野市にある美術館は「長野県立美術館」です。「長野市立美術館」「信州大島駅」は、検索では確認できませんでした
大事なのは、元のモデル(Q4_K_M)も同じ種類の間違いをしていることです。所要時間の誤り、新幹線の扱い、場所の取り違えは、三値化の前から出ています。三値化で間違いが増えたとは言えません。 そのうえで、固有名詞や所要時間をそのまま信じてはいけない点は、どの形式でも同じです。
字数の指示は、PQ2_0 が守り、PTQ1_0 はわずかに超えました(506字)。Q4_K_M も9月3日の回は超えています。1回ずつなので、ここに差があるとは言いません。
文脈を伸ばすと、12GBでもう一度「崖」が出る
12GBで使うときに、いちばん気をつけたいところです。
llama-server を -ngl 99(全層GPU)で、文脈の長さ(-c)だけ変えて起動し、短い要約(134トークン)を1回投げました。KVキャッシュは既定の16bitです。
| 構成 | 文脈の長さ | 生成 (tok/s) | プロンプト処理 (tok/s) | VRAMピーク |
|---|---|---|---|---|
| PQ2_0 | 32K | 49.09 | 462.03 | 10,143 MiB |
| PQ2_0 | 48K | 48.89 | 410.32 | 11,214 MiB |
| PQ2_0 | 64K | 17.05 | 49.08 | 11,869 MiB |
| PQ2_0 | 128K | 18.61 | 49.27 | 11,827 MiB |
| PTQ1_0 | 32K | 56.17 | 466.78 | 9,025 MiB |
| PTQ1_0 | 64K | 56.26 | 469.78 | 11,105 MiB |
| PTQ1_0 | 96K | 15.04 | 49.33 | 11,840 MiB |
| PTQ1_0 | 128K | 14.67 | 50.20 | 11,873 MiB |
- PQ2_0 は 48K → 64K で、生成が 2.9分の1、プロンプト処理が 8.4分の1
- PTQ1_0 は 64K → 96K で、生成が 3.7分の1、プロンプト処理が 9.5分の1
- どちらも起動するし、答えも返ってきます。エラーは出ません
9月1日の記事の「GPUに2層多く載せたら19倍遅くなった」と同じ型です。今回は層の数ではなく、文脈の長さで崖を踏みます。
気づく手がかり
遅くなった構成では、サーバのログにこの1行が出ていました。
common_fit_params: failed to fit params to free device memory: n_gpu_layers already set by user to 99, abort「空いているVRAMに収まらない。でも層数はユーザーが指定しているので、調整はしない」という意味です。
ただし、この警告が出ても崩れなかった構成もありました(後述の PTQ1_0 + -fa on + 8bit の128K。前述の Q4_K_M -ngl 42 でも、層数の数字が42の同じ警告が出ていました)。警告は「危ないかもしれない」の目印で、崩れた証拠ではありません。VRAM使用率も、崩れた構成は96%以上でしたが、同じ日の Q4_K_M -ngl 42 は96.5%で正常に動いていました。確実なのは、短い文脈のときと生成速度を比べることです。
なぜここまで遅くなるのか(溢れた分を Windows のドライバが共有メモリへ逃がしている、など)は、確かめていません。
自動調整に任せた1例
-ngl を指定せずに起動すると、llama.cpp が自動で収まるように調整します。PQ2_0 を64Kで試したところ、ログに「層の一部をCPUに割り当て、それに伴って高速化用の処理の一部を無効にした」旨が出て、生成は 12.15 tok/s でした(どちらが遅さの原因かは確かめていません)。崖を踏んだとき(17.05)よりさらに遅い結果です。試したのはこの1例だけです。
flash attention と8bitのKVキャッシュで伸ばす
-fa on -ctk q8_0 -ctv q8_0(flash attention を有効にし、文脈の記憶を8bitで持つ)を付けて測りました。
| 構成 | 文脈の長さ | 生成 (tok/s) | VRAMピーク |
|---|---|---|---|
PQ2_0 + -fa on + 8bit | 64K | 48.60 | 10,316 MiB |
PQ2_0 + -fa on + 8bit | 128K | 14.36(崩れる) | 11,936 MiB |
PTQ1_0 + -fa on + 8bit | 128K | 55.71 | 11,393 MiB |
(参考)PQ2_0 + -fa on のみ | 64K | 40.65 | 11,944 MiB |
PQ2_0 の64Kは、-fa on だけでも 17.05 → 40.65 tok/s まで戻りました。8bitも足すと 48.60 です。2つの効果は切り分けていません。8bitにしたときの出力の質も確かめていません。
今回の測定で、短い入力の生成速度を保てた文脈枠
-ngl 99+-c(KV 16bit) | -ngl 99 -fa on -ctk q8_0 -ctv q8_0 | |
|---|---|---|
| PQ2_0(7.21GB) | 48K(64Kで低下) | 64K(128Kで低下) |
| PTQ1_0(5.95GB) | 64K(96Kで低下) | 128K(試した最大値) |
この表の読み方には4つの注意があります。
- 「その文脈枠で起動して、短い入力(134トークン)を流したときに速度が落ちなかった」という意味です。文脈を実際に埋めると、上のベンチのとおり32Kで約2割遅くなります
- 測った文脈枠は 32K・48K・64K・96K・128K と飛び飛びです。表の値と、速度が落ちた次の値の間に本当の境目がありますが、そこは測っていません
- デスクトップが約1.2GBを使っている状態での値です。ブラウザなどでVRAMを多く使っていれば、境目は手前に来ます
- メーカーのデモスクリプトは文脈の長さをメインメモリの量から決めるため、12GBのGPUでは収まらないことがあると、メーカー自身が書いています。文脈の長さは自分で指定してください
メーカーの「既知の問題」ページは、思考モード(このモデルの既定)で答えが途中で切れるときの対策として、出力上限 16,384以上・文脈 65,536 を勧めています。今回の環境で12GBのままその設定を使うなら、PTQ1_0、または PQ2_0 + -fa on + 8bit でした。
この結果から言えること
- VRAM 12GBのGPUをすでに持っている人:今回のRTX 4070 12GBでは、思考オフの短い3タスクで PTQ1_0 が平均56 tok/s(PQ2_0 は49 tok/s)でした。この使い方のために24GB機へ買い替える必要はありませんでした。他の12GB GPUでの速度は未確認です。文脈枠は、PTQ1_0 なら
-ngl 99と-cの指定だけで64Kまで、-fa on -ctk q8_0 -ctv q8_0を足せば128Kまで正常でした(PQ2_0 はそれぞれ48K・64Kまで。いずれも短い入力での確認)。固有名詞や所要時間は自分で確かめる前提です(元のモデルも同じです)。 - いまのGPUが8GB以下の人:8GB以下は未実測なので、この記事だけでは買い替えが必要かどうか判断できません。PTQ1_0 の本体は5.54GiBですが、それだけで8GBで動くとも動かないとも言えません。購入を考える場合、RTX 4070 12GBは今回動作と速度を確かめた構成の一例です。
【PR】楽天市場でRTX 4070の価格を見る
- より大きなVRAMを考える人:大容量VRAMを検討する用途は、次のようなものです。
- 長い文脈枠を16bitのKVキャッシュのまま使いたい(今回は PTQ1_0 が96K、PQ2_0 が64Kで速度が落ちました)
- 通常の4bit量子化(Q4_K_M、17.8GB)の27Bを全層GPUに載せたい(12GBでは載りきらず、3.6 tok/s 前後でした)
- 画像入力を併用したい(画像入力は未実測です。メーカー資料では、画像用に0.63GBのファイルが追加で必要です)
- 128Kを超える文脈を使いたい(モデルの上限は262K)
【PR】楽天市場でRTX 3090の価格を見る - PCごと替える人:中古ゲーミングPCで、VRAM 12GB以上の機種を探す方法もあります(本サイトでは未実測)。
【PR】GP-ZEROで中古ゲーミングPCを見る
動かすときの注意
- 改造版の llama.cpp を使う。 PrismML-Eng/llama.cpp のリリースから入手します。通常版は PTQ1_0 / PQ2_0 を読み込めません。メーカーは、Q2_0 という名前のファイルと F16 のファイルは「通常版でも読み込めてしまい、意味のない出力になる」と注意しています。Windows では CUDA 12.4 版を選びました。メーカーの既知の問題に「CUDA 13.3 版は一部の環境で、Windows では起動表示のあと何も言わずに終了する」とあるためです
-ngl 99と-cを自分で指定する。 自動調整に任せた1例では、かえって遅くなりました- 思考を止めるには、リクエストに
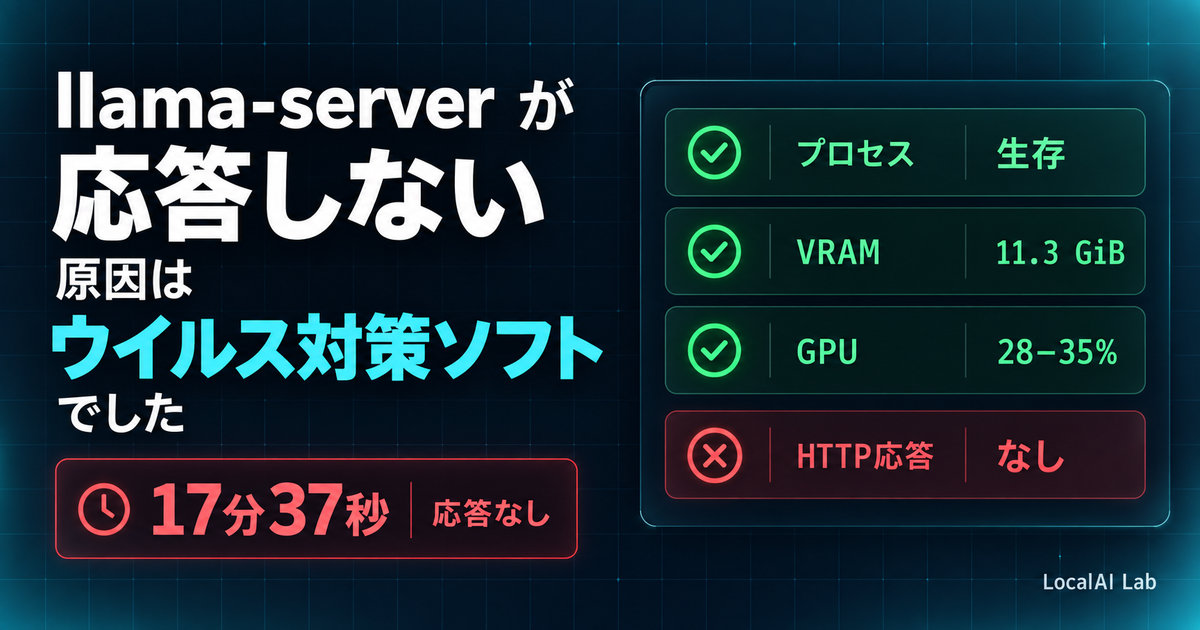
"chat_template_kwargs": {"enable_thinking": false}を付けます。"reasoning_effort": "none"でも止まりました。9月3日の実測ではサーバに--reasoning-budget 0も付けていましたが、メーカーの既知の問題に「0 では思考が止まらない」とあるため、今回は付けていません。止めないと、今回の確認では簡単な質問でも英語で考えてから答えました - llama-server が応答しないときは、ウイルス対策ソフトを疑ってください。私は9月にこれでつまずきました(llama-serverが応答しない原因はウイルス対策ソフトでした)
断定していないこと
- RTX 4070 12GB + RAM 32GB という1環境、PrismML版 llama.cpp の1つの版(b10754)での実測です。他のGPU・他の版は測っていません
- 品質は思考オフ・各タスク1回・温度0.7での比較です。「同じ3タスクではこうだった」までです
- 思考モード(このモデルの既定)での速度や、答えが出るまでの時間は測っていません
- 文脈の崖は、短いプロンプト(134トークン)で確かめました。実際に64Kの文章を流し込んだ状態の速度は測っていません(llama-bench で 32K まで)
- 崖で遅くなる仕組みは確かめていません。
-fa onと8bitの効果は切り分けていません。8bitでの出力の質も確かめていません - Q4_K_M のサーバ設定は
-ngl 32と42の2つだけ試しました。もっと速い設定があるかは詰めていません - 24GB機(RTX 3090 など)と画像入力は未実測です
- メーカーのベンチマーク(98.2%)は紹介しましたが、依拠していません
まとめ
RTX 4070 12GB で 27B を使うなら、
- Ternary Bonsai 2 27B の PTQ1_0 を、改造版 llama.cpp で全層GPUに載せる。実運用で生成 56 tok/s、元の4bit版の約16倍
- 品質は、同じ3タスクでは元のモデルと明確な差が見えませんでした(各1回)。固有名詞を信じてはいけないのは元のモデルも同じです
- 文脈枠は、KVキャッシュ16bitのままなら PTQ1_0 で64Kまで正常、96Kでは約4分の1に落ちました(
-fa on+ 8bitなら128Kでも正常。どちらも短い入力で確認し、間の境目は未測定)。落ちてもエラーは出ないので、速度を測って確かめてください
「27Bには24GB」は、このモデルを今回の使い方(思考オフ・短い入力)で動かす限り、RTX 4070 12GBでは当てはまりませんでした。より大きなVRAMを検討する理由は、文脈枠の広さだけでなく、KVキャッシュの精度、使うモデル形式、画像入力の有無で変わります。必要な容量と24GB機での速度は未実測です。
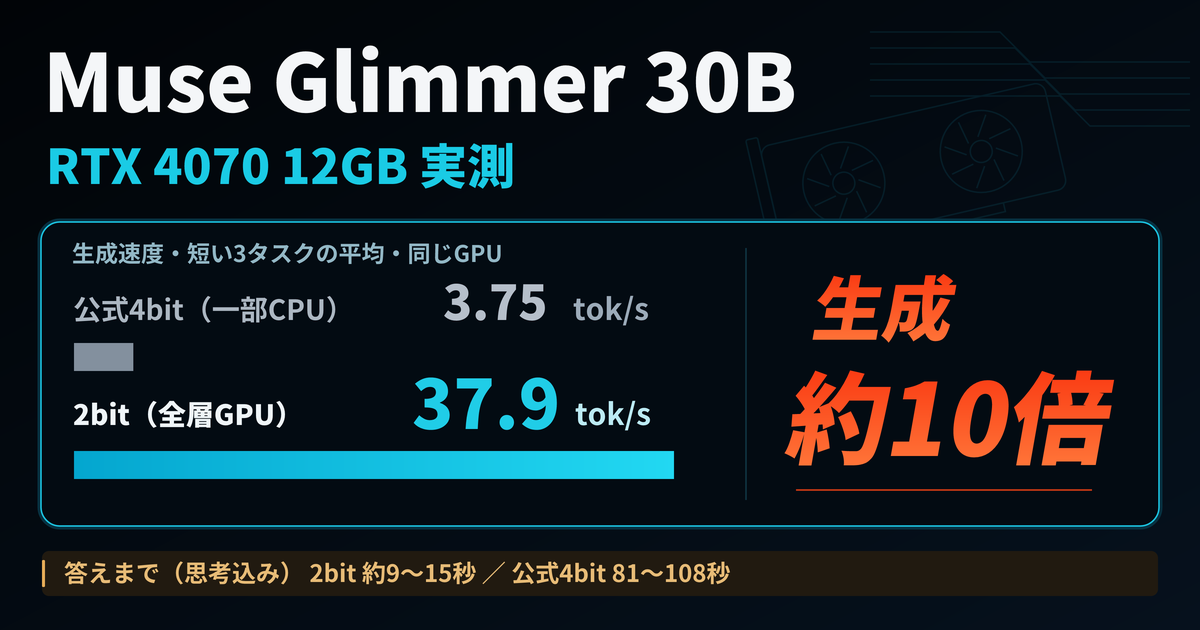
追記 2026-10-13:同じRTX 4070 12GBで、Meta の Muse Glimmer 30B も測りました。公式4bitは12GBに載りきらず生成約3.7 tok/sでしたが、unsloth の2bit版なら全層がGPUに載り、約38 tok/s(思考 low・短い3タスクの平均)でした。
→ Muse Glimmer 30BをRTX 4070 12GBで実測|2bitは全層GPUで38 tok/s、公式4bitの約10倍
関連記事
- Muse Glimmer 30BをRTX 4070 12GBで実測|2bitは全層GPUで38 tok/s、公式4bitの約10倍
- Qwen3.8-27BはRTX 4070 12GBで動くか実測|GPUに2層多く載せたら19倍遅くなった
- llama-serverが応答しない原因はウイルス対策ソフトでした
- Qwythos-27BをRTX 4070 12GBで実測|1.7 tok/s、VRAM 93.3%、24GBが要る理由
llama.cppでの動かし方(PrismML版の入手、思考の止め方、文脈枠の崖)は、Zennに技術メモとしてまとめています。
Ternary Bonsai 2 27BをRTX 4070で動かす:PrismML版llama.cpp、思考の止め方、文脈枠の崖(Zenn)
コメント