ローカルLLM実装

Qwythos-9BはVRAM 6GBでどこまで動く?Q4/Q5/Q6を比較検証

Qwythos-9B-Claude-Mythos-5-1MのGGUFを、VRAM 6GBのGTX 1660 Tiとllama.cppで実測。Q4_K_M/Q5_K_M/Q6_KのVRAM(約3.9〜4.6GB)と速度、日本語・要約・コードの出来を比較しました。
ローカルLLM実装
自分のGPUでローカルLLMを使う手順|OllamaでGemma 4・Qwen3を動かす

Ollamaで自分のGPUにローカルLLMを入れる手順。VRAM 6〜24GB別に最初に試すモデル、RTX 4070 12GBでの実測速度(gemma4:12b 約43 tok/s)、--verbose と nvidia-smi で速度とVRAMを確かめる方法まで。
ローカルLLM実装

Gemma 4をRTX 4070(12GB)で実測|12B・E4B・Qwen3 14B・Phi-4-mini・26Bを同じ試験でクラウドと比べた

RTX 4070(12GB)でGemma 4・E4B・Qwen3 14B・Phi-4-mini・26Bの5モデルをOllamaで実測。クラウドのOpus 4.8と同一テストで採点し、12GB級はコード15/15で同点。速度・VRAM・画像認識の差を実数値で比較した。
AIコーディング

Claude Fable 5を実測|Opus 4.8と同じ隠しテストを全サーフェスで受けさせた結果

Opus 4.8と同じ隠しテストをClaude Fable 5に全サーフェスで実施。品質は全run満点。差が出たのは簡潔さ・コストの振れ幅(単発$0.17〜workflow$4.16)・フォールバック挙動の3点を実測。
AIコーディング

Claude Opus 4.8のeffortを実測検証|全5段階×Code/Cowork/Chatでトークン・速度・品質はどう変わるか

Claude Opus 4.8のeffort(low〜max+ultracode)を実機で27run検証。出力トークンは約7倍、処理時間は最大6倍に増える一方、正解率は全レベル同じ。実測データと使い分け指針を公開。
AIコーディング

Claude Code のステータスラインを自作する|プラン・effort・応答時間・使用量ゲージを1行に

Claude Codeのステータスラインを Node.js で自作する実装記録。stdinに渡るJSONスキーマ、契約プラン・effort・応答1回ごとのAPI処理時間(累積値の差分方式)・公式使用量ゲージ(rate_limits)の実装と設計判断、Windowsのハマりどころまでまとめました。
AIサービス比較

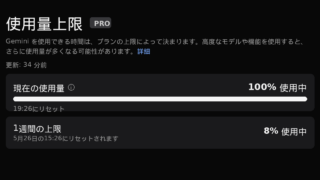
Gemini Omni Flash 再検証|テキストから動画が3本作れた(前回は1本も作れず)

前回はテキストから動画を1本も作れず100%だったGemini Omni Flashを再検証。今回は3本とも完走、使用量0→78%。生成した3本の動画とプロンプト、注意点まで実機ログでまとめました。
AI×業務自動化

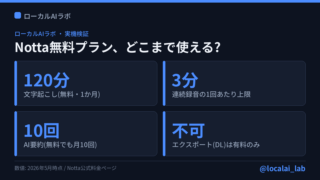
Notta無料プラン、どこまで使える?|文字起こし精度と”有料の壁”を実際に試した

Nottaの無料プランを実際に使い、文字起こし精度・AI要約・エクスポート制限・課金ラインを検証。1回3分/120分月の実用度、誤変換の具体例、業務利用時のセキュリティ注意点まで実機ベースでまとめました。
AIサービス比較

Gemini Omni Flash、動画は作れる。でもPro契約だと2〜3本で使用量が尽きた

Geminiの新動画モデル「Omni Flash」をProユーザーが実機検証。0%スタートなのに未完成の動画1本で使用量100%、強制Flash-Lite降格…。compute-usedモデルの仕組みと、仕様か不具合かを公平に整理した実機レビューです。
AI業界解説

AIサイバー攻防戦2026 — Claude Mythos・日本政府ガイドライン・企業が今すべきこと

2026年、サイバー攻撃の約16%にAIが関与。自律型ランサムウェア、経営者なりすましのディープフェイク詐欺が現実に。攻撃AI vs 防御AI(Claude Mythos)、日本政府の規制まで整理し、企業が今すべき対策を実装目線で解説します。