【PR】この記事にはアフィリエイトリンクを含みます。Amazonのアソシエイトとして、当メディアは適格販売により収入を得ています。実測に使った機材と、実測していない機材は、リンクごとに区別して記載しています。
この記事の測定結果 llama-server の生成の中央値と、実タスクの区間の VRAM の最大(GPU 全体。画面表示分を含む)です。思考オフ・文脈設定4096。
Recursive Flint UD-Q2_K_XL(Unsloth) 13.56GB
25.272 tok/s
llama-server・中央値
専門家の多くをCPU側に
測定中の最大 5,639 VRAM 6,144 MiB
同じ8問×3回の品質は内容 19/24、厳格 11/24。共有 GPU メモリへのはみ出しはなし。
- GPU
- VRAM 6GB の GPU(6,144 MiB)。画面表示もこの GPU
- CPU・メモリ
- 4コア8スレッド/RAM 32GB(16GB×2、DDR4-3200)
- 実行環境
- llama.cpp b12005(llama-server と llama-bench)
結論
総パラメータ 39.8B の MoE「Recursive Flint」の実測結果です。PC は VRAM 6GB の GPU(画面表示と兼用)と RAM 32GB。
量子化は Unsloth の UD-Q2_K_XL(13.56GB)、llama.cpp b12005、思考オフ、文脈設定4096。
-ngl 99と--n-cpu-moe 41の組み合わせで動いた。共有 GPU メモリへのはみ出しもなし- 生成は中央値 25.272 tok/s(llama-server、24本)。llama-bench の tg128 は、専門家を GPU に多く置くほど上がった
- VRAM は GPU 全体で最大 5,639 MiB(画面表示分を含む)。RAM の空きは最小 3,234 MB
- Q3(UD-Q3_K_XL)は起動していない。RAM 32GB では空きが足りない見込みだったため
- 同じ8問×3回は内容 19/24、厳格 11/24。24本中1本で、思考の終わりの印(</think>)が答えに残った
Recursive Flint とは
Recursive が開発した MoE(専門家混合)モデルです。総パラメータ 39.8B のうち、トークンごとに使うのは約2.5B。
| 項目 | モデルカードの記載 |
|---|---|
| 開発元 | Recursive |
| 総パラメータ | 39.8B(丸めた表記は 40B-A2.5B) |
| トークンあたりの有効パラメータ | 約2.5B(出力ヘッドを含む) |
| 層数 | 49(密な層2+MoE 層47) |
| 専門家 | MoE 層ごとに256。トークンごとに6つを選択+常に使う共有の専門家1つ |
| 推奨の生成設定 | temperature 1.0、top-p 0.95、top-k 20 |
- MoE:層ごとに多数の「専門家」を持ち、トークンごとに一部だけを使う作り
- 表はモデルカード(英語)の記載から
検証環境と条件
| 項目 | 内容 |
|---|---|
| GPU | VRAM 6GB の GPU(6,144 MiB)。画面表示もこの GPU |
| CPU | 4コア8スレッド |
| RAM | 32GB(DDR4-3200、16GB×2) |
| OS | Windows |
| 実行環境 | llama.cpp b12005(llama-server と llama-bench) |
| 測定日 | 2026年11月4日 23時17分〜11月5日 0時12分 |
モデルは Hugging Face の unsloth/flint-GGUF にある3つ(サイズと SHA256 の一致を確認済み)。記事の中心は UD-Q2_K_XL です。
| 量子化 | サイズ | この記事での扱い |
|---|---|---|
| UD-Q2_K_XL | 13,562,207,680 bytes | bench・実タスク・品質 |
| UD-IQ2_XXS | 11,855,541,696 bytes | bench とロードだけ |
| UD-Q3_K_XL | 18,494,977,472 bytes | 起動していない(RAM の節) |
- llama-server:
-ngl 99(ログで 50/50 層)、--n-cpu-moe 41、文脈設定4096、flash attention 有効、同時1件 - 思考オフ(
--reasoning-budget 0)、max_tokens 1024 - 生成条件 M2(主条件):temperature 0.2、top_p 0.95、top_k 40、min_p 0、repeat_penalty 1.0、cache_prompt false、system なし
- 前回の Nemotron 3.5 Bolt E4B の記事と同じ条件。モデルカードの推奨ではない(注意点の節)
- M2 は8問をシード 11・23・37 で各3回(24本)
- RS(推奨設定):モデルカード推奨の設定で、シード11 の8本だけ
- llama-bench:
-ngl 99、pp512・tg128 を各3回。--n-cpu-moeは UD-Q2_K_XL で 49・45・41、UD-IQ2_XXS で 49
用語
- tok/s:1秒あたりに生成するトークン数。トークンの区切り方はモデルごとに違う
- -ngl:GPU に割り当てる層の数。99 は全層を指定
- GPU 全体:画面表示などを含む、GPU 全体の VRAM 使用量
- 共有 GPU メモリ:GPU がメインメモリ側に確保した分。この量で VRAM からのはみ出しを判定(なし/少量/あり)
- RAM の空き:PC 全体のメモリのうち、すぐ使える量(Available)
--n-cpu-moe と速度
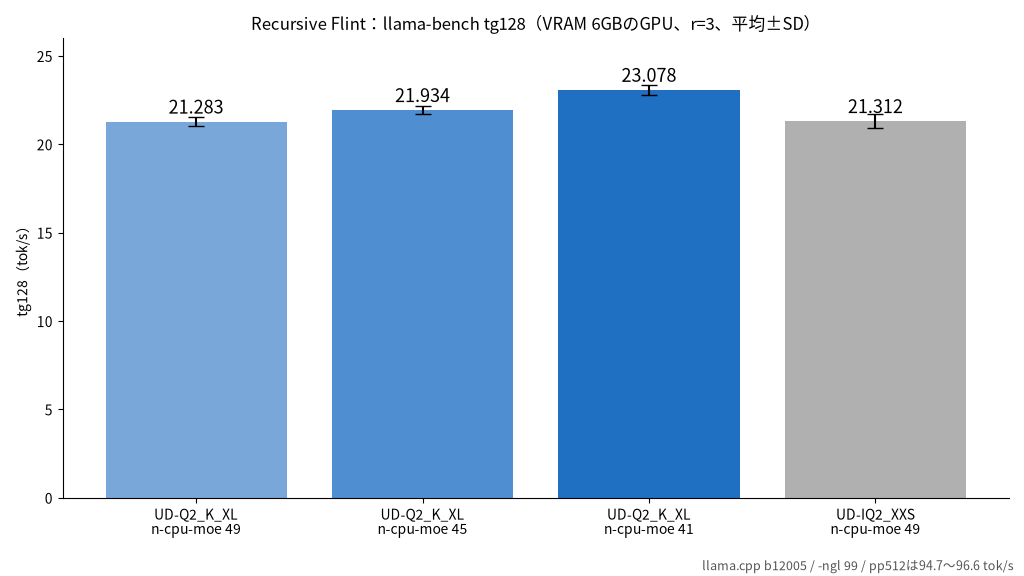
専門家を GPU に多く置くほど、生成(tg128)は速くなりました。試した中では N=41 がいちばん速く、23.078 tok/s。
--n-cpu-moe の数字は専門家の重みを CPU 側に置く層の数で、小さいほど専門家を GPU に多く置きます。
| 量子化 | --n-cpu-moe | pp512(tok/s) | tg128(tok/s) | はみ出し |
|---|---|---|---|---|
| UD-Q2_K_XL | 49(全層の専門家を CPU 側) | 94.742 ± 2.984 | 21.283 ± 0.257 | なし |
| UD-Q2_K_XL | 45 | 95.231 ± 2.779 | 21.934 ± 0.212 | なし |
| UD-Q2_K_XL | 41(採用) | 96.555 ± 3.065 | 23.078 ± 0.267 | なし |
| UD-IQ2_XXS | 49 | 96.135 ± 2.358 | 21.312 ± 0.412 | なし |
- llama-bench:pp512 は512トークンの入力処理、tg128 は128トークンの生成。値は3回の平均±標準偏差
- はみ出し:共有 GPU メモリへのはみ出しの判定
- N=41 を採用。候補の 49・45・41 のうち、tg128 がいちばん速かった
- 候補は、N=49 で起動・暖機したあとの GPU 全体の使用量(最大 3,716 MiB)をもとに絞った
- 41 より小さい値(専門家をさらに GPU に置く)は未測定
- pp512 は 94.742〜96.555 で、ほぼ横ばい
- UD-IQ2_XXS の tg128 は、同じ N=49 の UD-Q2_K_XL とほぼ同じ
UD-IQ2_XXS は bench とロードだけ
UD-IQ2_XXS(N=49)の実タスクと品質は未測定。bench の値は上の表のとおりです。
| 項目 | UD-IQ2_XXS(N=49) |
|---|---|
| ロード | 38.931秒 |
| GPU 全体の最大(bench 区間) | 3,560 MiB |
| RAM の空き最小 | 7,166 MB |
- GPU 全体の最大は bench 区間の値。UD-Q2_K_XL の実タスクの値(VRAM の節)とは区間も N も違う
実タスクの速度と </think> が残った1本
llama-server(Q2・N=41)の生成は中央値 25.272 tok/s。推奨設定(RS)の8本も 25.289 tok/s で、ほぼ同じでした。
| 条件 | 本数 | 生成の中央値(範囲) | 入力の処理の中央値 |
|---|---|---|---|
| M2(主条件) | 24 | 25.272(22.996〜26.367) | 34.809 |
| M2・</think> の1本を除く | 23 | 25.310(22.996〜26.367) | 35.019 |
| RS(推奨設定) | 8 | 25.289(24.942〜26.158) | 40.875 |
- 単位は tok/s。かっこ内は最小〜最大
- この記事の生成の値は、</think> の1本を含む24本の中央値
- ロード:36.483秒(N=49 で予備に起動したときは 35.609秒)。OS のファイルキャッシュは未制御
24本中1本で </think> が答えに残った
24本中1本で、思考の終わりの印(</think>)が答えに残りました。設定で思考をオフにしても、完全には効かないことがあります。
| 項目 | q3・シード23 の1本 |
|---|---|
| 生成 | 25.176 tok/s |
| 入力・生成・時間 | 118トークン・116トークン・8.145秒 |
| 思考の欄(reasoning_content) | 0文字 |
| 終了理由 | stop |
| 除外したときの中央値 | 25.272 → 25.310 tok/s(23本) |
| 採点 | 内容は合格、厳格は不合格 |
- 内容:必要な事実と、次の報告の時刻はあった
- 厳格の不合格の理由:本文の重複と、</think> の混入
- 品質の合計(厳格 11/24)は、この不合格を含む
- 答えをプログラムで読み取る使い方では、</think> などの印が残っていないか確かめてください
VRAM と RAM
VRAM は 6,144 MiB に収まり、はみ出しもなし。RAM 32GB で Q2 は動き、Q3 は空きが足りない見込みで起動していません。
VRAM(GPU 全体)
- GPU 全体の最大:5,639 MiB(待機時から +3,545 MiB)。実タスク(M2)の区間で、画面表示分を含む
- 共有 GPU メモリの最大:104 MiB(llama-server のプロセス単位)。はみ出しの判定は「なし」
- どちらも外部ログ(nvidia-smi の1秒おきの記録と GPU カウンター)の値。NVML の値は不使用
起動ログの buffer
--n-cpu-moe を 41 に下げた分、専門家の重みが CPU 側から GPU 側へ移りました(起動ログの値)。
| --n-cpu-moe | CPU 側 | CUDA0 model |
|---|---|---|
| 41(採用) | 10,034.95 | 2,893.76 |
| 49(予備の起動) | 11,814.95 | 1,113.76 |
- 単位は MiB。llama-server の起動ログの buffer 行
- N=41 の CUDA0 には、ほかに KV 199.50・compute 187.27
- N=41 のログ表示は offloaded 50/50(全層を GPU に割り当て)
RAM の空き
RAM の空きは最小 3,234 MB、中央値 12,086 MB。RAM は DDR4-3200 の 16GB×2 です。
- PC 全体の空き(Available)。Q2・N=41 の llama-server の実行中
- 空きが 1GiB を下回ったら止める安全装置は、作動しなかった
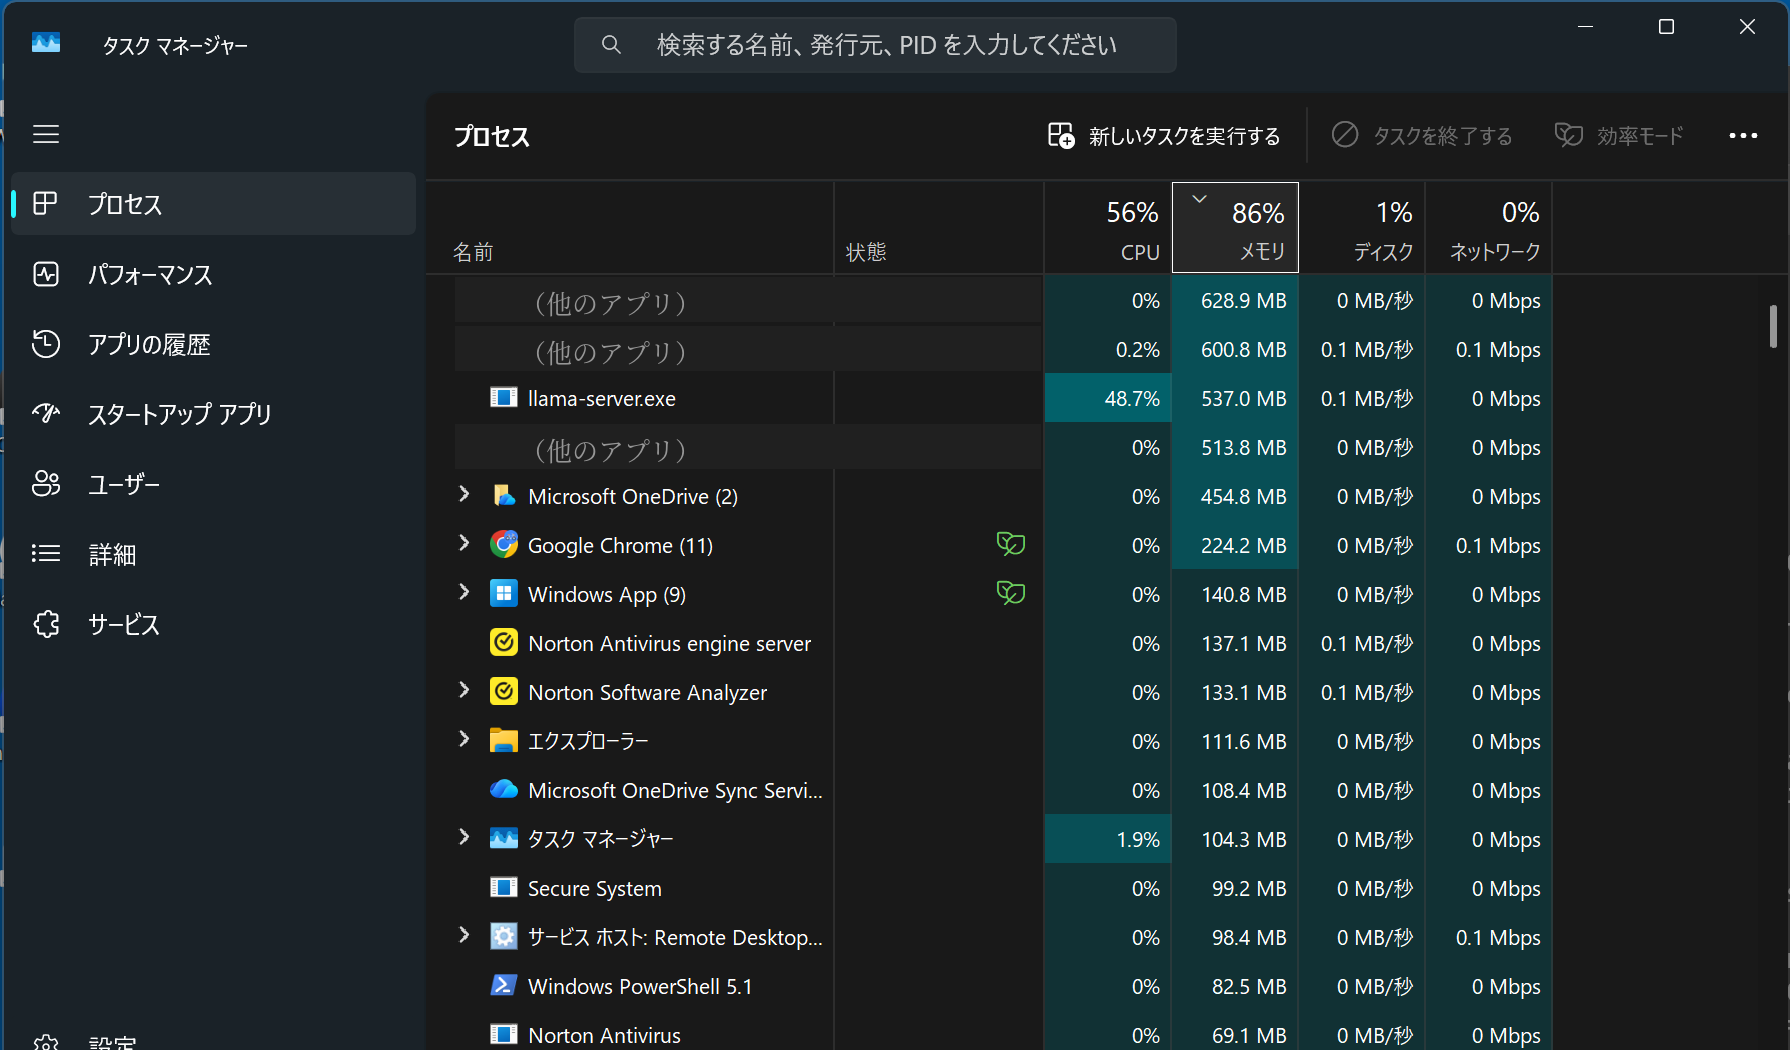
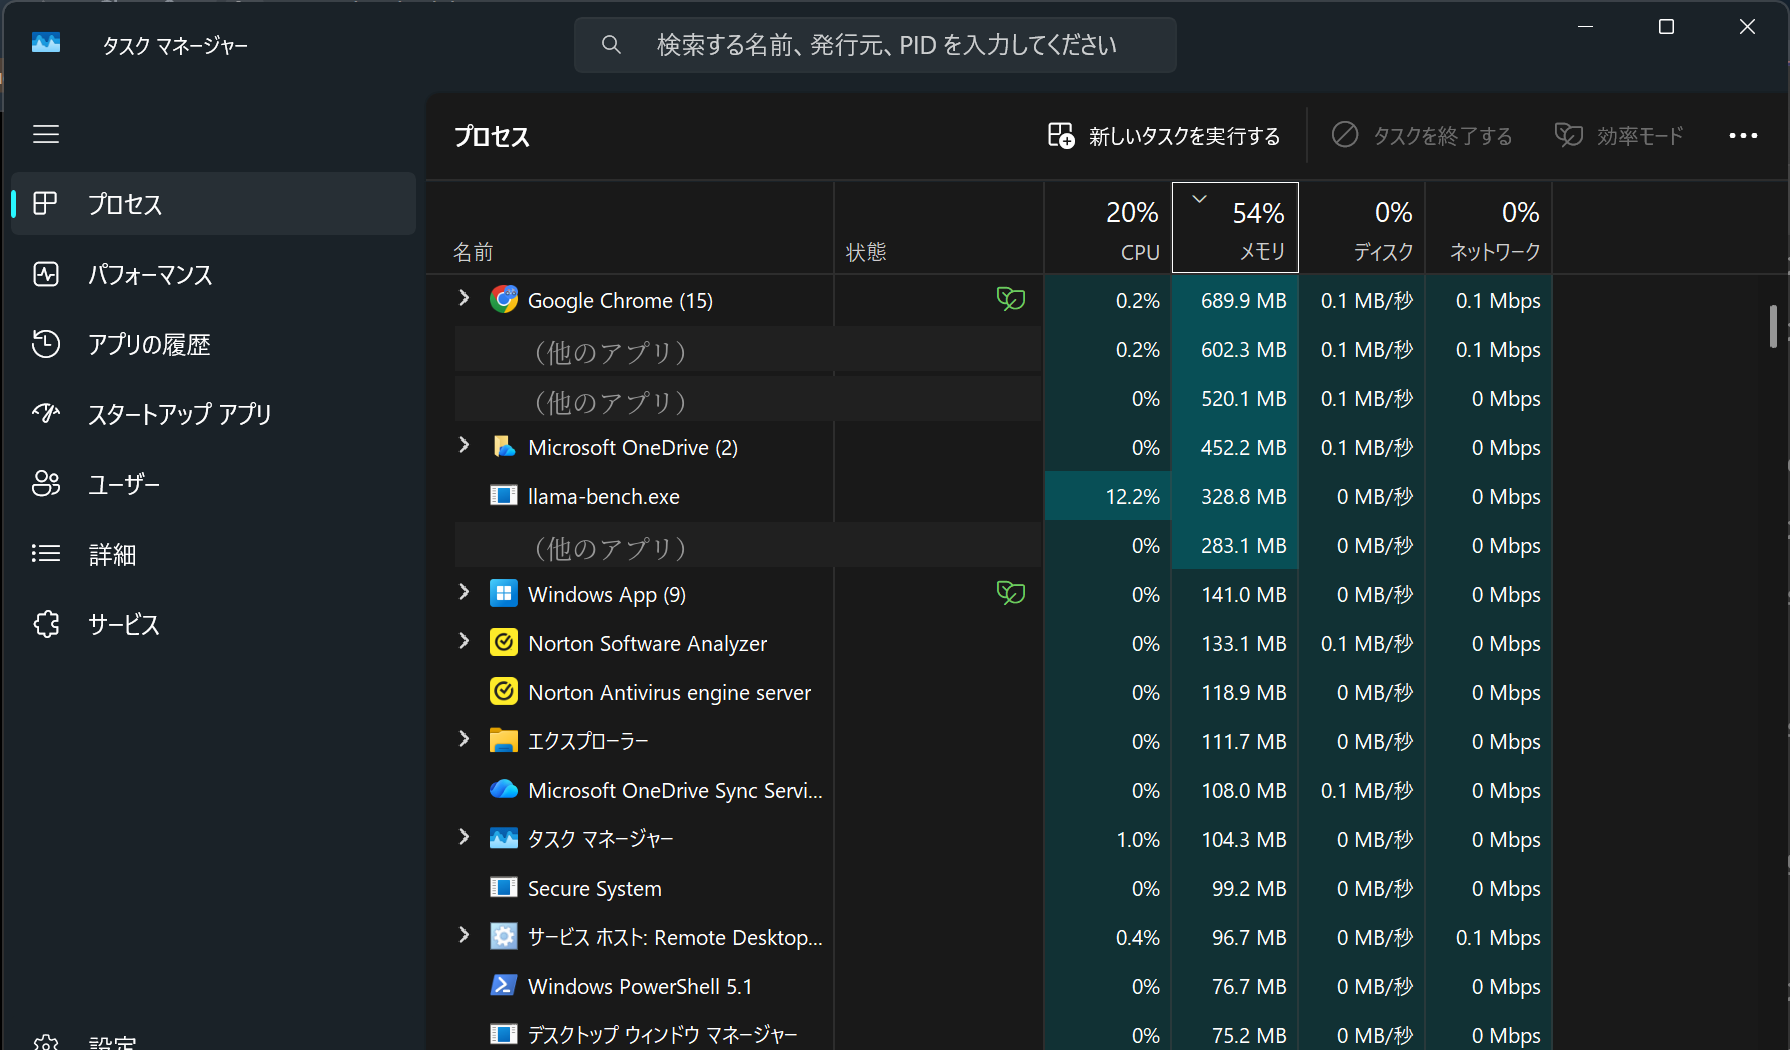
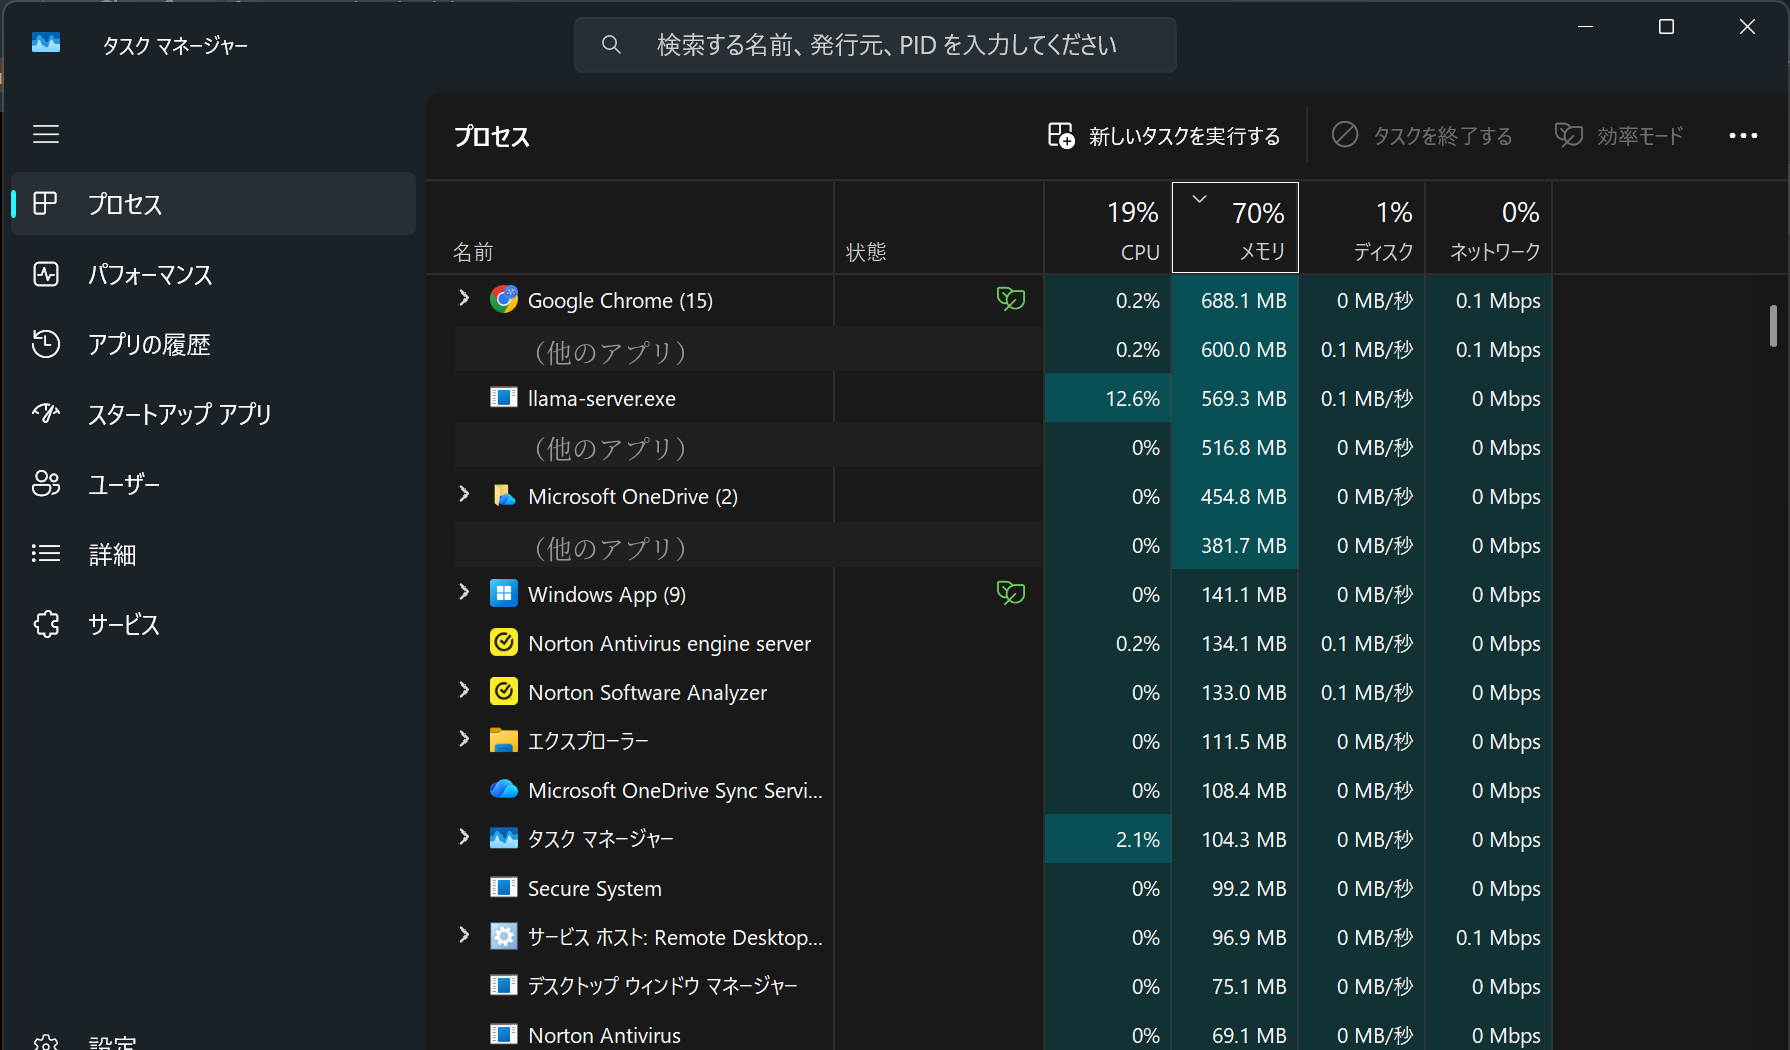
- キャプチャの llama-server.exe のメモリ列は 569.3 MB(M2)・537.0 MB(RS)の表示。起動ログの CPU 側 buffer より小さく、理由は未確認
- この記事の RAM の値は、PC 全体の空き(Available)
Q3 を起動しなかった理由
UD-Q3_K_XL(18.49GB)は、起動前の見込みで RAM の空きが足りませんでした。見込みの空き最小は −47.27 MB で、開始の条件 1,800 MB を下回っています。
- 開始の条件を満たさないため起動していない。速度・VRAM・品質はどれも未測定
- Q2 と Q3 の品質の比較もなし
Q3 を試すなら、RAM を 64GB に増やすのも選択肢の1つ。メモリの規格(DDR4/DDR5)は自分の PC に合わせて選んでください。
【PR】RAM 64GB での動作は、検証ラボでは未実測。
AmazonでDDR4 64GB(32GB×2)を見る
楽天市場でDDR4 64GB(32GB×2)を見る
シリコンパワーダイレクト(メモリメーカーのオンラインストア)を見る
品質: 同じ8問を3回ずつ(Q2)
内容の合格は 19/24、厳格の合格は 11/24。q4 は内容も 0/3、q8 はコードがテストに全部通ったものの厳格は 0/3 でした。
- q1 抽出JSON:お知らせから日付・時刻・場所などを取り出して JSON で出す
- q2 要約:図書館の夜間貸出の記事を、40字以内の3行に要約する
- q3 条件つきの文:システム障害のお知らせを、150字以内・です・ます・必須の4項目つきで書く
- q4 注文JSON:注文文を JSON にし、合計金額(9,800円)も計算して入れる
- q5 計算:りんごとみかんの代金から10%引いた支払額(3,960円)を求め、考え方も書く
- q6 推論:3人の傘の色を、手がかりから当て、考え方も書く
- q7 Python:英単語を数えて上位 n 個を返す関数を書く(テスト5件)
- q8 JavaScript の修正:平均を返す関数のバグの原因を1〜2文で説明して直す(テスト8件)
- 内容:課題の要点を満たした回答。q7・q8 はテストの全件合格が条件
- 厳格:内容に加え、形式など課題の指定まで満たした回答。前回までの記事の「指定条件まで合格」に当たる
- 課題ごとに決めた要点に照らした、理由つきの判定。日本語能力全般の点数ではない
- q7・q8 のコードは別の Linux 機の隔離環境でテスト
- ネットワークなし、1本あたり実時間10秒・メモリ 1GiB などの上限付き
- テストは前回記事と同じファイル(ハッシュ一致)。環境の失敗・時間切れはなし
| 課題 | 内容 | 厳格 |
|---|---|---|
| q1 抽出JSON | 3/3 | 0/3 |
| q2 要約 | 2/3 | 2/3 |
| q3 条件つきの文 | 3/3 | 2/3 |
| q4 注文JSON | 0/3 | 0/3 |
| q5 計算 | 3/3 | 3/3 |
| q6 推論 | 2/3 | 1/3 |
| q7 Python | 3/3 | 3/3 |
| q8 JavaScript | 3/3 | 0/3 |
| 合計 | 19/24 | 11/24 |
- q4 は内容も 0/3。3本とも不合格
- q8:修正コードは3本ともテスト 8/8 で、厳格は 0/3
- コードの外の説明で、「空配列のときは 0 を返す処理が要る」ことの説明が足りない・あいまいだった
- シード 11・37 は、説明の文の数(1〜2文)の条件も満たしていない
- q3:厳格の不合格1本は、</think> が残ったシード23
- q7:3本ともテスト 5/5 で、厳格も 3/3
推奨設定(RS)の8本
RS は内容 4/8、厳格 3/8。シード11 の1本ずつのため、M2 との差は比べられません。
- RS の q7(テスト 5/5)・q8(テスト 8/8)は、どちらも厳格まで合格
同じ PC の既存記事との比較
同じ PC で測った既存記事の値と並べます。測り方と設定が記事ごとに違うため、倍率や順位は付けません。
- LLM-jp-4.1をVRAM 6GBで実測|8B・32B-A3Bを比較
- Nemotron 3.5 Bolt E4BはVRAM 6GBで動く?「4GB」の中身を実測
- LFM3-1.7BをVRAM 6GBで実測|速度・VRAM・品質を量子化3種で比較
| 構成 | 生成(tok/s) | GPU 全体の最大(増加) | RAM の空き最小 | 8問 内容・厳格 |
|---|---|---|---|---|
| Recursive Flint UD-Q2_K_XL --n-cpu-moe 41(この記事) | 25.272 | 5,639(+3,545) | 3,234 MB | 19/24・11/24 |
| LLM-jp-4.1 32B-A3B(MoE)Q4_K_M --n-cpu-moe 28 | 17.85 / 18.71 / 18.67 | 記載なし | 約1.1 GiB | 別の問題 |
| Nemotron 3.5 Bolt E4B Q4_K_M | 58.048 | 5,702(+3,456) | 記載なし | 15/24・12/24 |
| LFM3-1.7B Q4_K_M | 152.13 | 3,045(+1,251) | 記載なし | 15/24・9/24 |
| LFM3-1.7B Q8_0 | 107.08 | 3,806(+2,012) | 記載なし | 18/24・12/24 |
- GPU 全体の単位は MiB(画面表示分を含む)。ほかの記事の値は各記事に書かれた値で、再測定・再採点はなし
- 置き方:Flint と LLM-jp-4.1 32B-A3B は専門家を CPU 側に置く指定あり。Nemotron・LFM3 は全層 GPU
- llama.cpp の版:LLM-jp-4.1 は b11574、ほかは b12005
- LLM-jp-4.1 の値:旅行・要約・コードの3課題を各1回(この順)。文脈設定は 8192。8問とは別の問題のため、品質は比べない
- RAM の空き最小:LLM-jp-4.1 は元記事の表記(GiB)のまま
- トークナイザー:モデルごとに違うため、tok/s は同じ文章を出す速さの比を表さない
この結果から言えること
- VRAM 6GB+RAM 32GB で 40B 級の MoE を試したい人:UD-Q2_K_XL なら、--n-cpu-moe 41 で画面表示と兼用でも動いた
- RAM の空きは最小 約3.2GB。ほかのアプリを閉じてから起動してください
- 思考オフでも </think> が答えに残る回答があった。答えをプログラムで読むなら確かめてください
- 決まった形の出力やコードに使いたい人:q7・q8 のコードは3本ずつ、すべてテストに通った
- ただし q4 は内容も 0/3、q8 はコードの外の説明が足りない・あいまいで厳格 0/3
- 生成されたコードや JSON は、確かめてから使ってください
- RAM を増やして Q3 も試したい人:Q3(18.49GB)は 32GB では空きが足りない見込みで、起動していない
- 64GB での動作と、Q2 との品質の差は未検証
- VRAM が大きい GPU を考える人:VRAM が大きければ、--n-cpu-moe の数字を小さくして専門家を GPU に多く置ける
- 6GB では、数字を 49 から 41 に下げるほど tg128 が上がった
- 12GB・16GB での速度と動作は未実測
【PR】VRAM 12GB・16GB の GPU での Flint の動作は、検証ラボでは未実測。
GIGABYTE GeForce RTX 3060 12GB(Amazon)
GIGABYTE GeForce RTX 3060 12GB(楽天市場)
AmazonでRTX 5060 Ti 16GBを見る
楽天市場でRTX 5060 Ti 16GBを見る
- PCごと買い替えるなら:新品の BTO パソコンと、中古のゲーミング PC の2つの選択肢
- VRAM の容量と画面表示で最初から使われる量に加え、RAM の容量も確かめてください
【PR】新品の BTO パソコン・中古のゲーミング PC とも、検証ラボでは未実測。
GP-ZEROで中古ゲーミングPCを見る
OZ GAMINGでBTOパソコンを見る
注意点と、測っていないこと
- 検証環境の表の1台で、1晩・各条件1回の結果。llama.cpp も b12005 の1つの版だけ
- 生成条件はモデルカードの推奨ではない。M2 は temperature 0.2 など前回記事と同じ条件で、推奨は temperature 1.0・top-p 0.95・top-k 20
- 推奨の設定(RS)は、シード11 の8本だけ
- 思考オフ(
--reasoning-budget 0)、max_tokens 1024、文脈設定4096 だけ。思考 ON と長い文章は未測定 - 品質はこの8問・3つのシード・この採点基準での結果。3回は出力の揺れを見る繰り返しで、24個の別々の課題ではない
- 各節に書いた測定上の注意
- VRAM の測り方(VRAM の節)
- ロード時間は OS のファイルキャッシュ未制御(実タスクの節)
- q7・q8 は別の Linux 機でテスト(品質の節)
- 未測定:Ollama、Q3、UD-IQ2_XXS の実タスクと品質、--n-cpu-moe 41 未満、VRAM 12GB 以上の GPU
再現用のコマンド
Q2・N=41 の llama-server は、次のコマンドで起動します。
モデルは Hugging Face の unsloth/flint-GGUF にある flint-UD-Q2_K_XL.gguf(13,562,207,680 bytes)。
llama-server -m flint-UD-Q2_K_XL.gguf -ngl 99 --n-cpu-moe 41 -c 4096 -fa on --parallel 1 --reasoning-budget 0- 生成条件(temperature など)は、このコマンドに含まれない(検証環境と条件の節)
- --n-cpu-moe 41 は、この PC(VRAM 6GB、画面表示と兼用)での値。起動後に GPU 全体の使用量と共有 GPU メモリを確かめてください
コメント